
Кратко
- Обе модели вышли 22 сентября 2026 года: Claude Opus 5.5 — примерно за полтора часа до анонса GPT-6 Sol.
- Sol стоит вдвое дешевле на каждой позиции прайса: $2 и $10 за миллион токенов против $4 и $20.
- Opus 5.5 заметно сильнее там, где сравнение вообще корректно: в независимом индексе Artificial Analysis у неё 58 баллов против 48 у Sol.
- Релизные таблицы двух компаний напрямую сопоставлять нельзя: один и тот же Claude Opus 5 на одном и том же тесте получает 60,3% у OpenAI и 74,0% у Anthropic.
22 сентября 2026 года два крупнейших разработчика выпустили новые модели с разницей примерно в полтора часа. Сначала Anthropic показала Claude Opus 5.5, следом OpenAI — GPT-6 Sol и GPT-6 Luna. Совпадение дало редкую возможность сравнить две свежие модели без поправки на возраст. Ответ на «gpt 6 sol или claude opus 5.5» упирается в один выбор: платить вдвое меньше или получать заметно больше. Ниже — как это выглядит в цифрах и почему половину цифр сравнивать нельзя.
Два релиза одного дня
Совпадение дат вряд ли было случайным. Anthropic анонсировала Opus 5.5 утром, OpenAI выпустила пару Sol и Luna примерно через полтора часа — и сразу с новым прайсом, вдвое ниже прежнего.
Позиционирование у моделей разное, и это важно для сравнения. Opus 5.5 — флагман Anthropic, лучшее, что компания предлагает. Sol — средняя ступень линейки GPT-6: над ней стоит GPT-6 Astra за $10 и $50 за миллион токенов, под ней — Luna за $0,10 и $0,50. То есть мы сравниваем чужой флагман с чужой рабочей лошадкой, и отсюда растут почти все дальнейшие выводы.
Характеристики и цена: таблица
| Параметр | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Разработчик | OpenAI | Anthropic |
| Дата выхода | 22 сентября 2026 | 22 сентября 2026 |
| Идентификатор в API | gpt-6-sol | claude-opus-5-5 |
| Контекстное окно | 1 050 000 токенов | 1 000 000 токенов |
| Максимум входа | 922 000 токенов | не заявлен отдельно |
| Максимальный ответ | 128 000 токенов | 128 000 (до 300 000 через Batch API в бете) |
| Дата знаний | 20 апреля 2026 | июнь 2026 |
| Вход | текст, изображения | текст, изображения |
| Выход | только текст | только текст |
| Рассуждения | можно выключить (none) | всегда включены |
| Уровни глубины | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Уровень по умолчанию | medium | medium |
| Цена ввода | $2 за млн | $4 за млн |
| Цена вывода | $10 за млн | $20 за млн |
| Чтение из кэша | $0,20 за млн | $0,20 за млн |
| Запись в кэш | $2,50 за млн | $5 за 5 минут, $8 за час |
| Сводный индекс Artificial Analysis | 48 | 58 |
Три различия в таблице стоят отдельного слова.
Первое — рассуждения. У Sol есть уровень none: модель отвечает мгновенно, без раздумий. У Opus 5.5 отключить рассуждения нельзя вовсе, запрос с выключенными размышлениями вернёт ошибку. Если у вас много коротких запросов, где думать не над чем, это прямая экономия на стороне Sol.
Второе — дата знаний. У Opus 5.5 она на два месяца свежее: июнь 2026 против 20 апреля. Для вопросов о недавних событиях и версиях библиотек разница ощутимая.
Третье — кэш. Чтение из кэша у обеих моделей стоит одинаково, $0,20 за миллион. А вот запись у Anthropic устроена сложнее: $5 при пятиминутном хранении и $8 при часовом против единой цены $2,50 у OpenAI.
Цена: вдвое дешевле на каждой строке
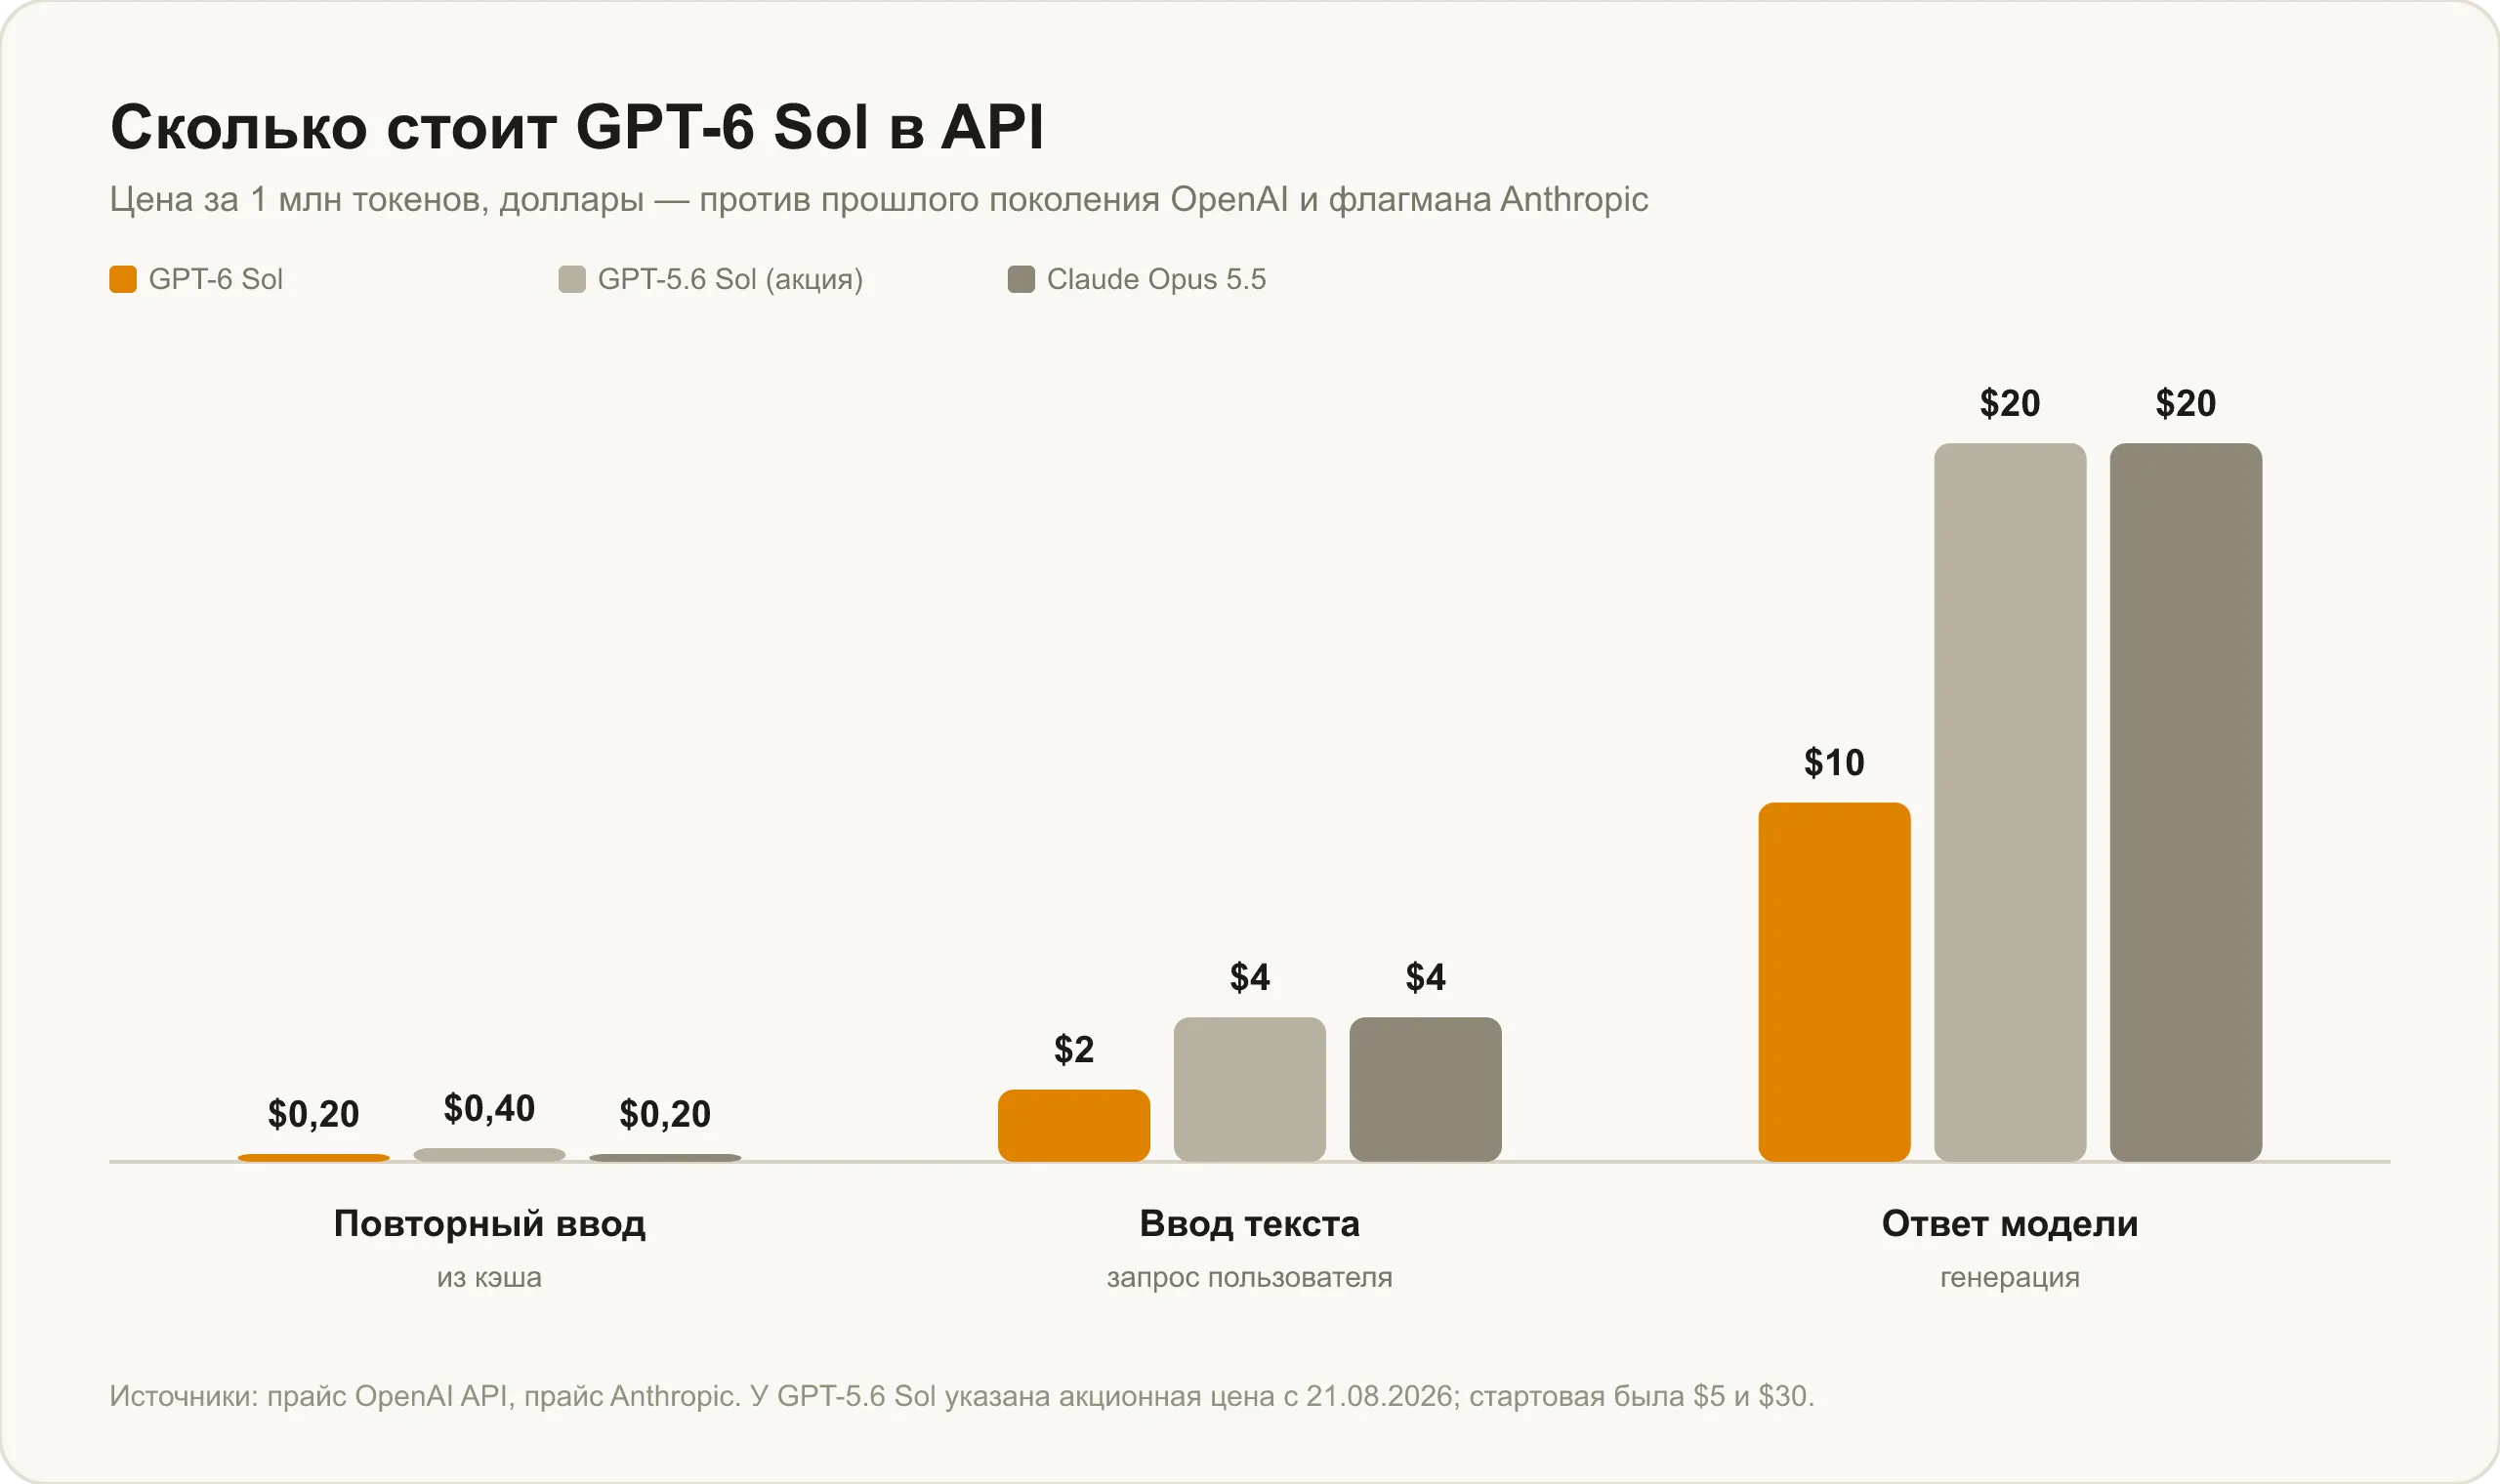
Ввод: $2 против $4. Вывод: $10 против $20. Ровно вдвое, без нюансов и без мелкого шрифта. На типичной нагрузке, где вывода примерно вчетверо меньше входа, счёт за Opus 5.5 выйдет в два раза выше при той же работе.
Любопытно, что обе компании двигались в одну сторону. Anthropic снизила цену флагмана с $5 и $25 у Opus 5 до $4 и $20. OpenAI срезала вдвое, с $4 и $20 до $2 и $10, и попала ровно в прайс Claude Sonnet 5 — средней модели Anthropic. То есть формально флагман Anthropic сравнивается с моделью, которая стоит как чужой средний тариф. Общую картину удешевления мы разобрали в статье про снижение цен на GPT-6.
Про постоянство цен обе компании высказались похоже: представитель OpenAI сказал VentureBeat, что новые цены постоянные, а не промо; Anthropic ещё 10 августа отменила запланированное повышение Sonnet 5 и оставила вводную цену навсегда.
Почему бенчмарки двух компаний нельзя сравнивать в лоб
Дальше начинается место, где большинство обзоров врёт, не замечая этого. Каждая компания публикует свою релизную таблицу, прогоняя чужие модели на собственном стенде. Результаты расходятся не на доли процента.
Пример. В релизной таблице OpenAI Claude Opus 5 на бенчмарке OSWorld 2.0 показывает 60,3% на среднем уровне рассуждений. В релизной таблице Anthropic тот же Claude Opus 5 на том же OSWorld 2.0 показывает 74,0%. Одна модель, один бенчмарк, разница почти в четырнадцать пунктов.
То же самое с FrontierCode 1.1. У OpenAI Claude Opus 5 набирает 53,4%. У Anthropic та же Opus 5 — 48,0%.
Причины обычные: разные версии бенчмарка, разные обвязки, разные настройки глубины рассуждений, разное число попыток. Ничего злонамеренного, но вывод из этого простой: цифру из таблицы OpenAI нельзя ставить рядом с цифрой из таблицы Anthropic и объявлять победителя. Внутри одной таблицы сравнение работает, между таблицами — нет.
Где цифры всё-таки пересекаются
С этой оговоркой посмотрим на три места, где сопоставление хоть сколько-то осмысленно.
На сложных задачах по коду, бенчмарк FrontierCode 1.1, у Sol 49,3% на уровне max по таблице OpenAI, у Opus 5.5 — 54,4% по таблице Anthropic. Важнее другое: в обеих таблицах Sol оказывается ниже всех моделей Anthropic, даже Claude Fable 5.1 с её 50,9% выше. Направление сходится в двух независимых замерах, и это уже кое-что значит.
С автоматизацией рутины, бенчмарк AutomationBench, цифры интереснее.
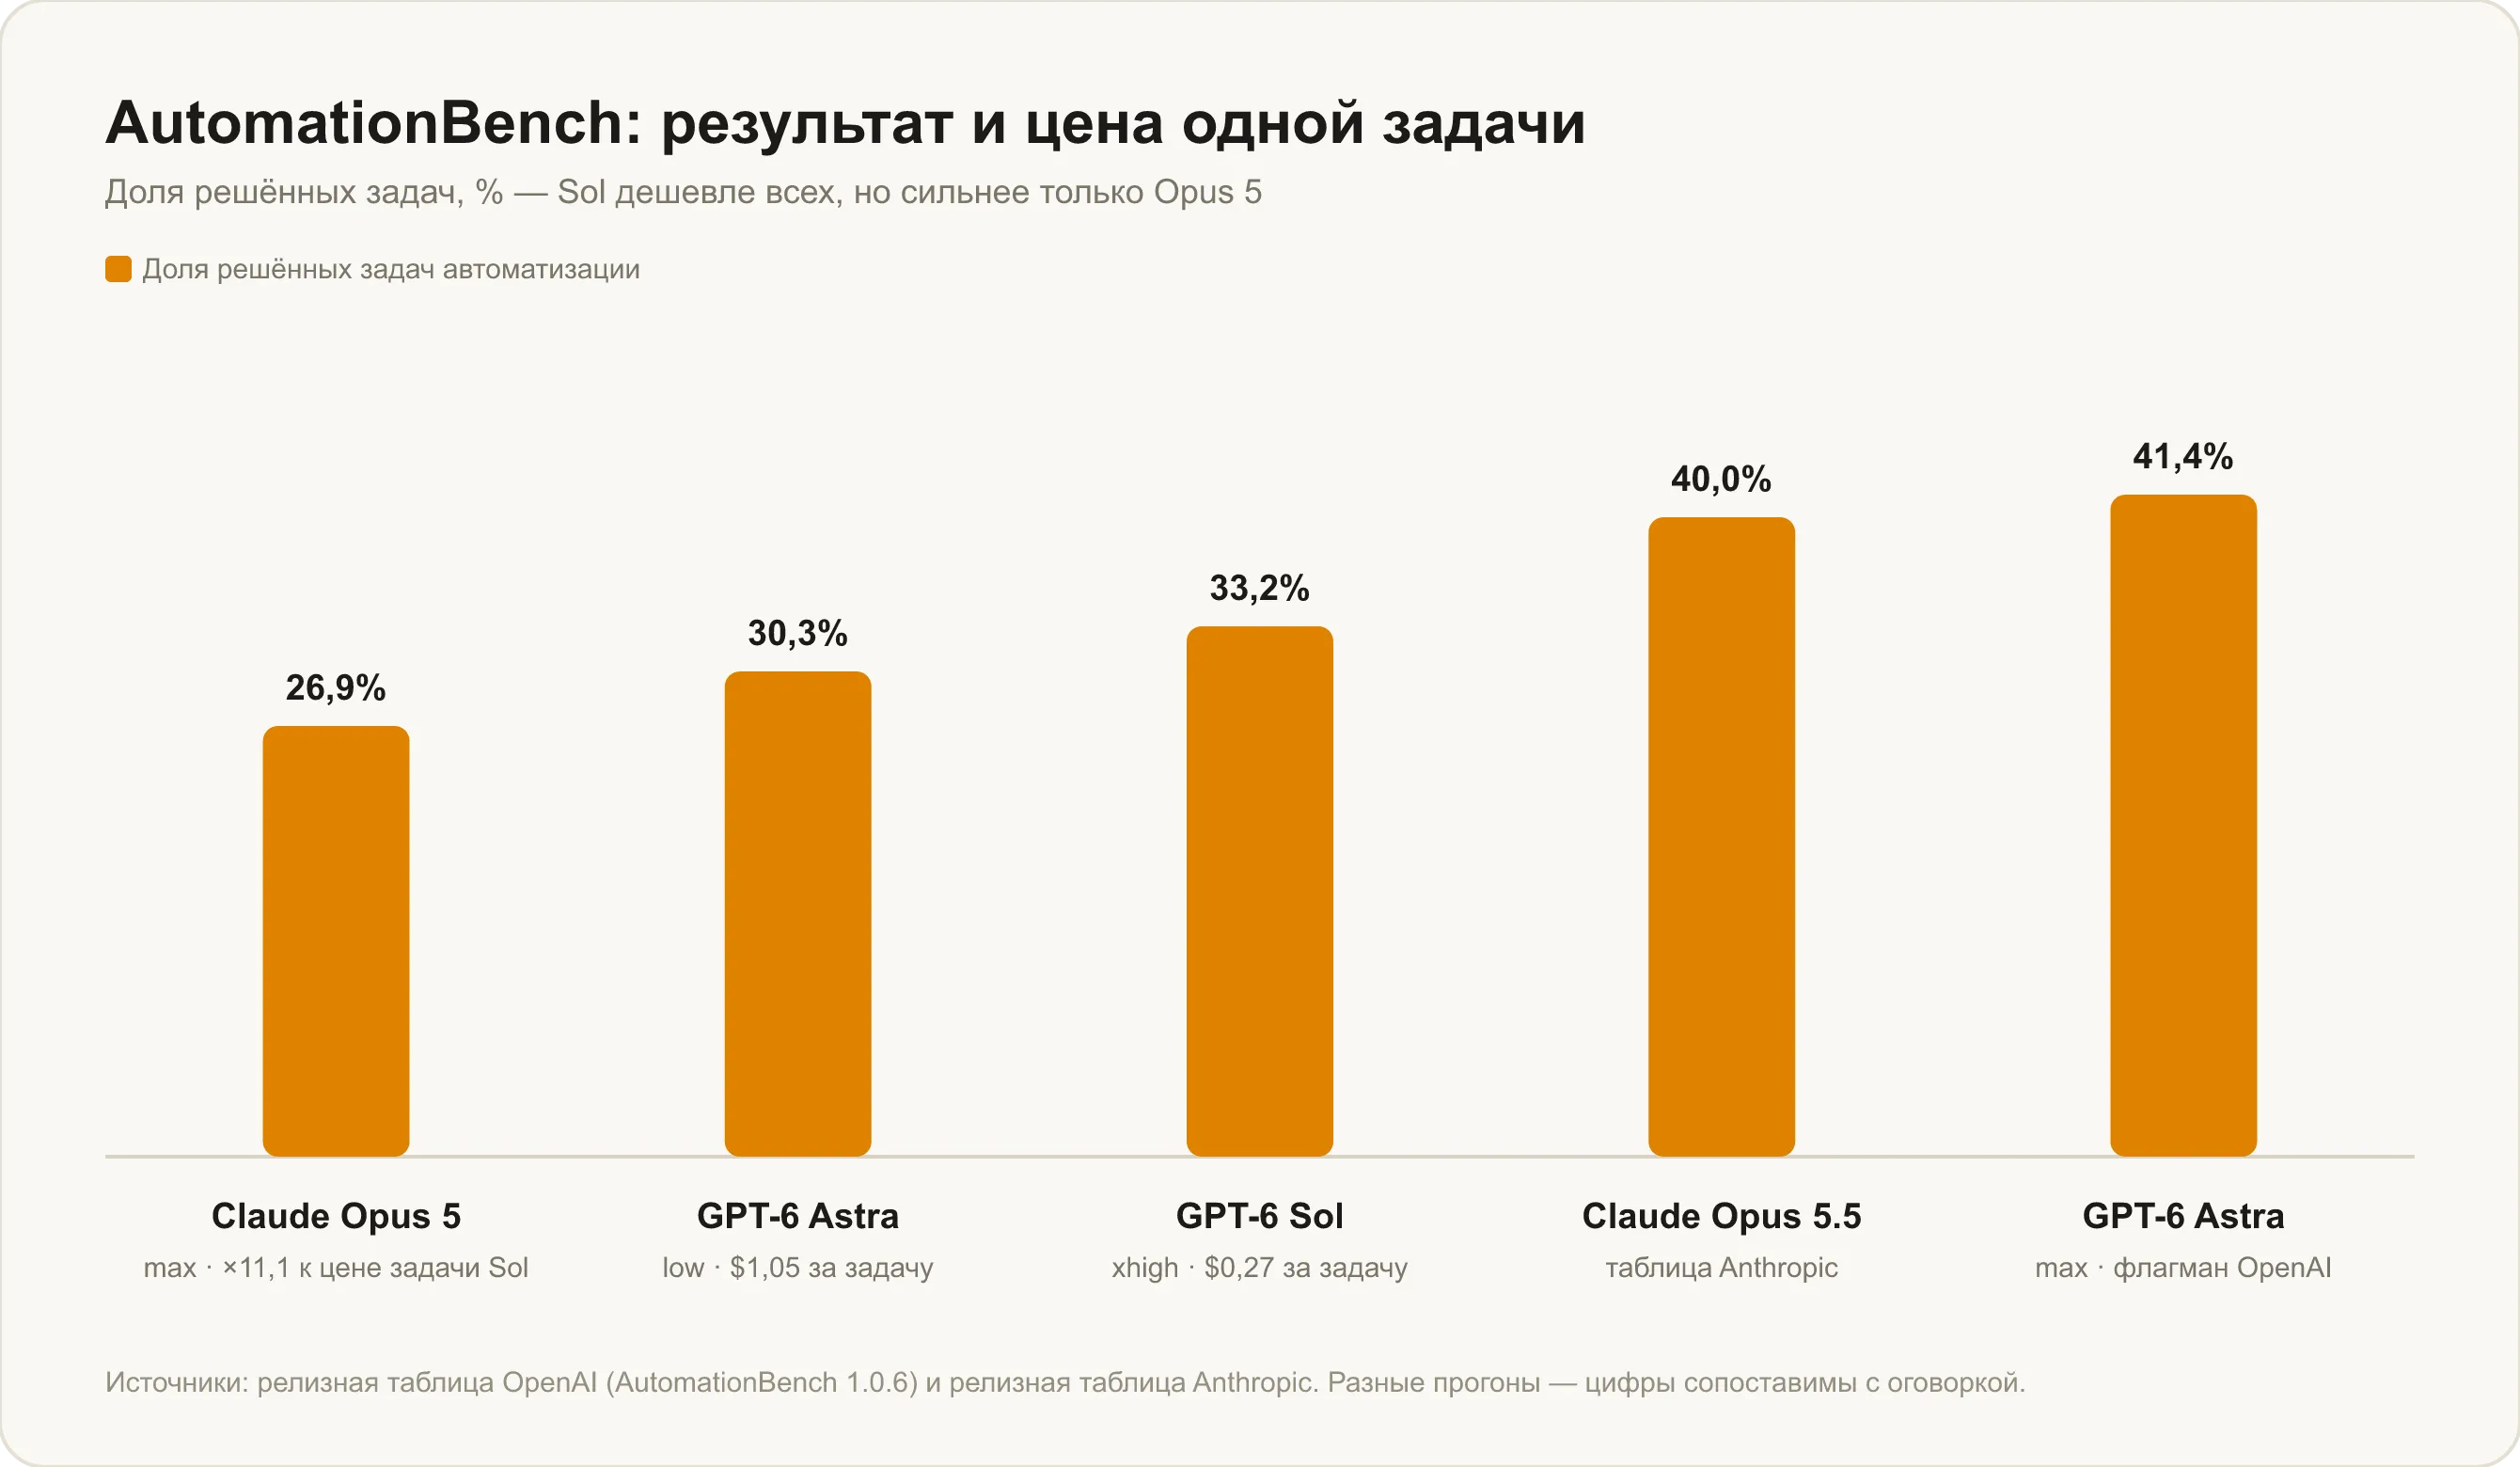
У Sol 33,2% на уровне xhigh при цене $0,27 за задачу. Claude Opus 5 в режиме max — 26,9%, и задача обходится в 11,1 раза дороже. На этом месте обычно и рождается заголовок «Sol обходит Claude дешевле в одиннадцать раз».
Заголовок неточный. Sol обходит Opus 5 — модель прошлого поколения. Вышедшая в тот же день Opus 5.5 на AutomationBench показывает 40,0% по таблице Anthropic, то есть выше и Sol, и даже Astra на низком уровне рассуждений (30,3% при $1,05 за задачу, по данным VentureBeat). Сравнение при этом идёт между таблицами разных компаний, так что и сорок процентов здесь — ориентир, а не приговор.
Остаётся независимый индекс. Это единственное по-настоящему чистое сравнение: сторонний замерщик прогоняет обе модели на одном стенде.
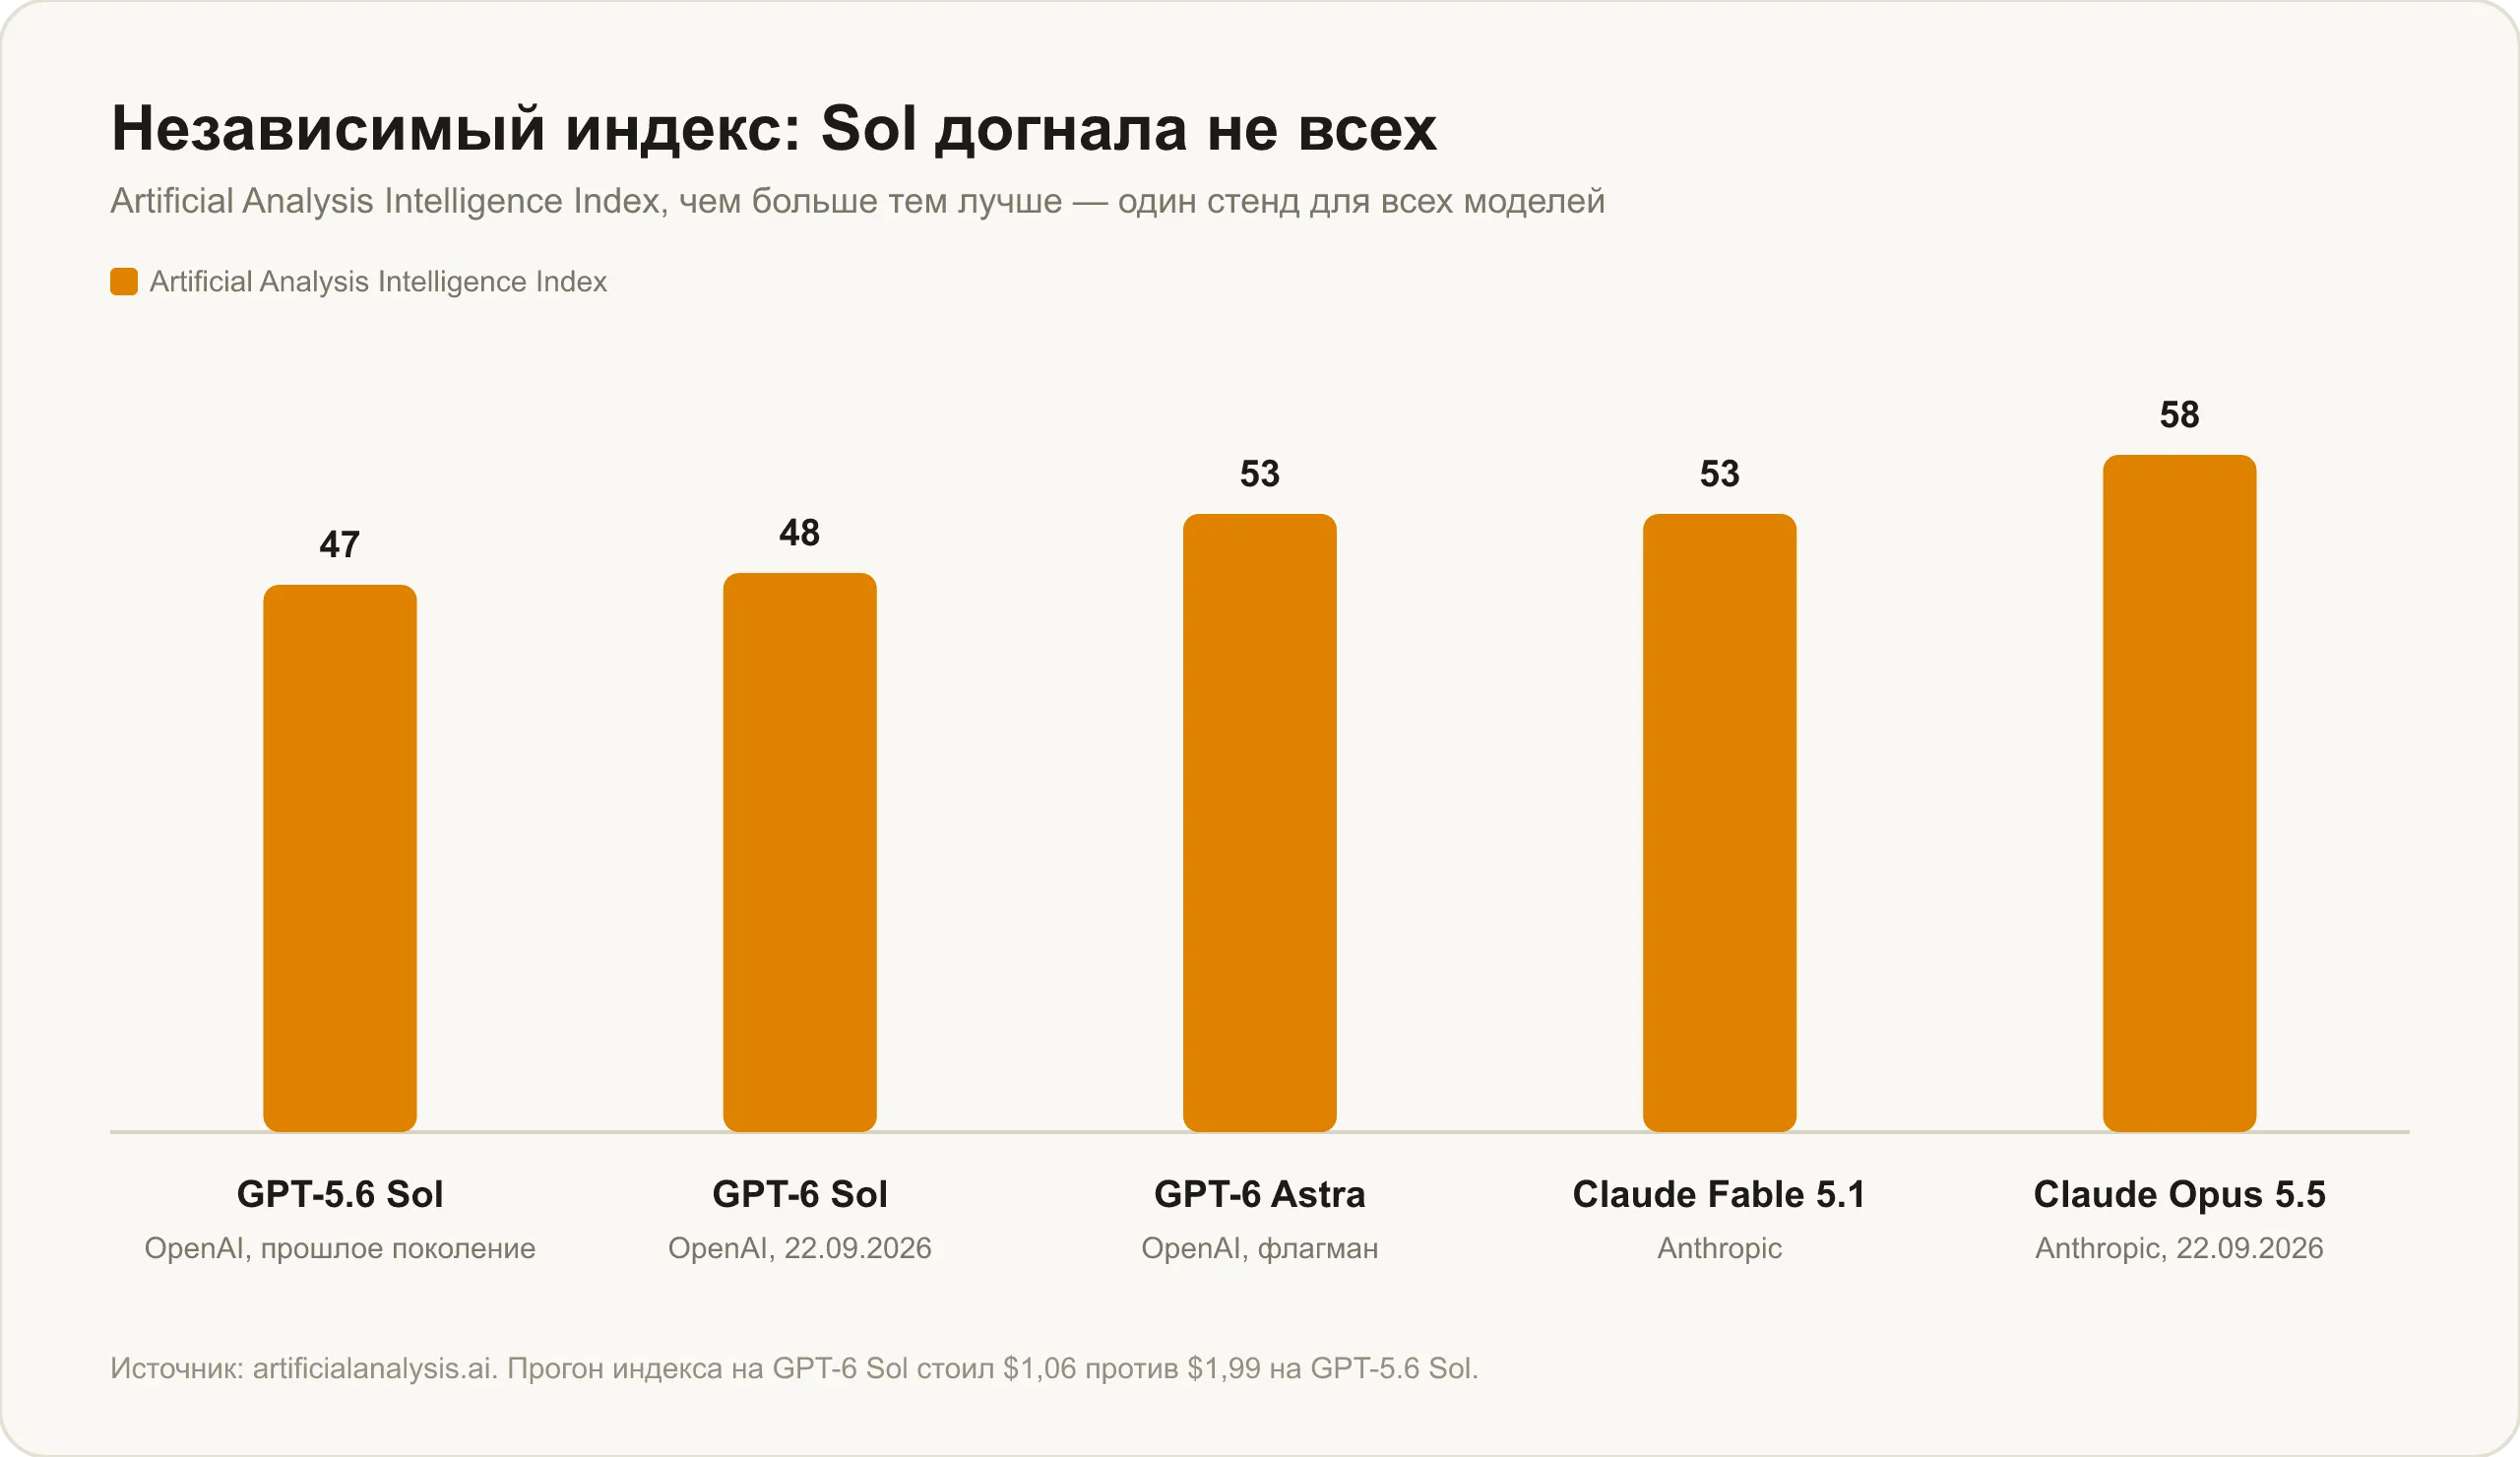
В Artificial Analysis Intelligence Index у Claude Opus 5.5 — 58 баллов, у GPT-6 Sol — 48. Между ними на отметке 53 стоят GPT-6 Astra и Claude Fable 5.1. Десять пунктов разрыва — это не погрешность, и отрицать её бессмысленно: по сводному интеллекту Opus 5.5 сильнее.
Одна оговорка для тех, кто читал наш разбор Astra. Там индекс приводился в значениях 61,2 у Astra и 65,7 у Fable 5.1 — это была прошлая версия методики Artificial Analysis. Сейчас сервис считает иначе, и обе модели в новой шкале получают по 53. Числа внутри одной версии сопоставимы, между версиями — нет.
Надёжность: обе компании обещают одно и то же разными словами
Любопытное совпадение: оба релиза делают упор не на силу, а на предсказуемость.
OpenAI показывает внутренние тесты: доля фактических ошибок у Sol на одинаковом уровне рассуждений упала с 10,8% до 5,1%, случаи, когда модель молчала о сломанном инструменте, — с 77,8% до 4,9%, приписывание себе несделанной работы — с 10,4% до 1,3%.
Anthropic в своём анонсе идёт с другой стороны: приводит миграцию кодовой базы на 680 тысяч строк за неполные сутки, оптимизацию веб-страницы, удавшуюся 39 раз из 40, и финансовую модель, собранную за 63 минуты против 93 у Opus 5.
Сравнивать эти наборы между собой невозможно — они меряют разное. Общий смысл в том, что оба разработчика в сентябре 2026-го продают надёжность, а не рекорды. И у обоих это самоотчёт: независимых проверок на дату релиза нет ни у той, ни у другой модели.
Кому что брать
Берите Claude Opus 5.5, если работаете со сложным кодом, где важен каждый процент, если нужны длинные агентные прогоны, если важна свежесть знаний (июнь 2026 против апреля) или если по сводному интеллекту хочется максимум из доступного. Разница в десять пунктов индекса оплачивается удвоением счёта — иногда это честная сделка.
Берите GPT-6 Sol, если объём работы большой, а бюджет конечный: за те же деньги вы получите вдвое больше прогонов. Если у вас много коротких запросов, где рассуждения не нужны, — режим none у Opus 5.5 недоступен в принципе. И если задачи типовые: на автоматизации рутины и работе в программах разрыв между моделями меньше, чем разрыв в цене.
Возьмите обе, если можете. Это не увиливание: у моделей разные сильные стороны, а проверка одного и того же запроса на двух моделях занимает минуту и отвечает на вопрос точнее любой таблицы.
С 29 сентября в линейке есть и GPT-6.1 Sol по той же цене. По заявлению OpenAI, на автоматизации бизнес-процессов (AutomationBench) она на 2,2 пункта обходит Opus 5.5 примерно за треть его цены за задачу. Это снова таблица одной компании, но разрыв между средней моделью OpenAI и флагманом Anthropic заметно сократился.
Как сравнить самому
Обе модели есть в каталоге Veruna AI — чата, где нейросети разных разработчиков собраны в одном месте, без VPN, без иностранной карты и с оплатой в рублях. GPT-6 Sol и Claude Opus 5.5 открыты на подписке Max, так что переключаться между ними можно в одном диалоге. Оформить подписку — на странице тарифов.
Дальше стоит взять две-три своих настоящих задачи, а не тестовых, и прогнать их на обеих моделях подряд. Про доступ из России подробнее — в статьях как пользоваться GPT-6 Sol и как пользоваться Claude Opus 5.5.
Частые вопросы
Что лучше: GPT-6 Sol или Claude Opus 5.5? Зависит от того, что для вас дороже — деньги или проценты. Opus 5.5 сильнее: 58 баллов против 48 в независимом индексе Artificial Analysis. Sol вдвое дешевле: $2 и $10 за миллион токенов против $4 и $20. Для повседневных задач разрыв в цене обычно весомее разрыва в качестве, для сложного кода — наоборот.
Насколько GPT-6 Sol дешевле Claude Opus 5.5? Ровно вдвое на каждой позиции: ввод $2 против $4, вывод $10 против $20. Чтение из кэша у обеих $0,20 за миллион, а запись у Sol $2,50 против $5 за пять минут и $8 за час у Opus 5.5.
Правда ли GPT-6 Sol обходит Claude в одиннадцать раз дешевле? Частично. На AutomationBench Sol набирает 33,2% при $0,27 за задачу против 26,9% у Claude Opus 5, задача которой стоит в 11,1 раза дороже. Но Opus 5 — модель прошлого поколения. Вышедшая в тот же день Opus 5.5 на том же бенчмарке показывает 40,0%, то есть выше Sol.
Почему результаты бенчмарков в разных статьях не сходятся? Потому что каждая компания прогоняет чужие модели на своём стенде. Claude Opus 5 на бенчмарке OSWorld 2.0 получает 60,3% в таблице OpenAI и 74,0% в таблице Anthropic. Сравнивать цифры можно только внутри одной таблицы.
У какой модели больше контекст? У GPT-6 Sol немного больше: 1 050 000 токенов против 1 000 000 у Claude Opus 5.5. Но под сам ввод у Sol отведено 922 000, остальное резервируется под рассуждения и ответ. У Opus 5.5 зато есть режим ответа до 300 000 токенов через Batch API в бете.
Можно ли отключить рассуждения?
У GPT-6 Sol — да, для этого есть уровень none. У Claude Opus 5.5 — нет, запрос с выключенными размышлениями возвращает ошибку на любом уровне глубины.