
Кратко
- Обе модели стоят одинаково: $2 за миллион входных токенов и $6 за выходные. Совпадение прайса делает сравнение честнее обычного — платите вы одно и то же, разница только в том, что получаете.
- В независимом индексе Artificial Analysis они почти вровень: 46,4 балла у Grok 4.7 и 45,4 у Qwen 3.8 Max 0902. У замеров Qwen при этом заметный разброс, так что вровень здесь — не фигура речи.
- Контекст у Qwen вдвое больше — миллион токенов против 500 тысяч, — и без порога, после которого тариф удваивается. У Grok такой порог есть: 200 тысяч токенов.
- Прямое сопоставление по бенчмаркам почти невозможно: компании прогоняют разные тесты и разные версии одних и тех же тестов. Где сравнивать нечестно, мы ставим прочерк.
Вопрос «квен или грок» выглядит странно ровно до того момента, как смотришь на прайс: обе модели стоят $2 и $6 за миллион токенов, обе вышли в августе-сентябре 2026 года и обе позиционируются как дешёвая альтернатива западным флагманам. Qwen 3.8 Max — китайская, от Alibaba; Grok 4.7 — американская, от SpaceXAI. Разница в сильных сторонах при этом заметная, и дальше мы её разбираем по опубликованным цифрам, а не по заголовкам релизов.
Сложность, с которой стоит начать
Две компании прогоняют разные наборы тестов, и это главное препятствие для честного сравнения.
Alibaba отчитывается по Terminal-Bench 2.1 и TerminalBench 3.0 (CellCog), SpaceXAI — по Terminal-Bench 4.0 (SpaceXAI). Это версии одного семейства тестов, но разной сложности, и их проценты между собой не складываются. Alibaba сравнивает себя с Claude и Gemini, SpaceXAI — с Claude и GPT. Прямого пересечения набирается мало.
Поэтому дальше в таблице встречаются прочерки. Там, где сопоставимого замера нет, честнее оставить пустое место, чем подставить цифру из соседнего теста и сделать вид, что она сравнима.
Независимый индекс: почти ничья
Единственное место, где обе модели измерены одним инструментом в одних условиях, — индекс Artificial Analysis. Агрегатор гоняет модели сам, по своей методике, и версия шкалы у обеих одна и та же.
Результат: 46,4 балла у Grok 4.7, 45,4 у Qwen 3.8 Max 0902 (Artificial Analysis). Разница в один балл укладывается в погрешность замера, тем более что у Qwen результаты агрегатора разбросаны от 45 до 56 по версиям модели и прогонам.
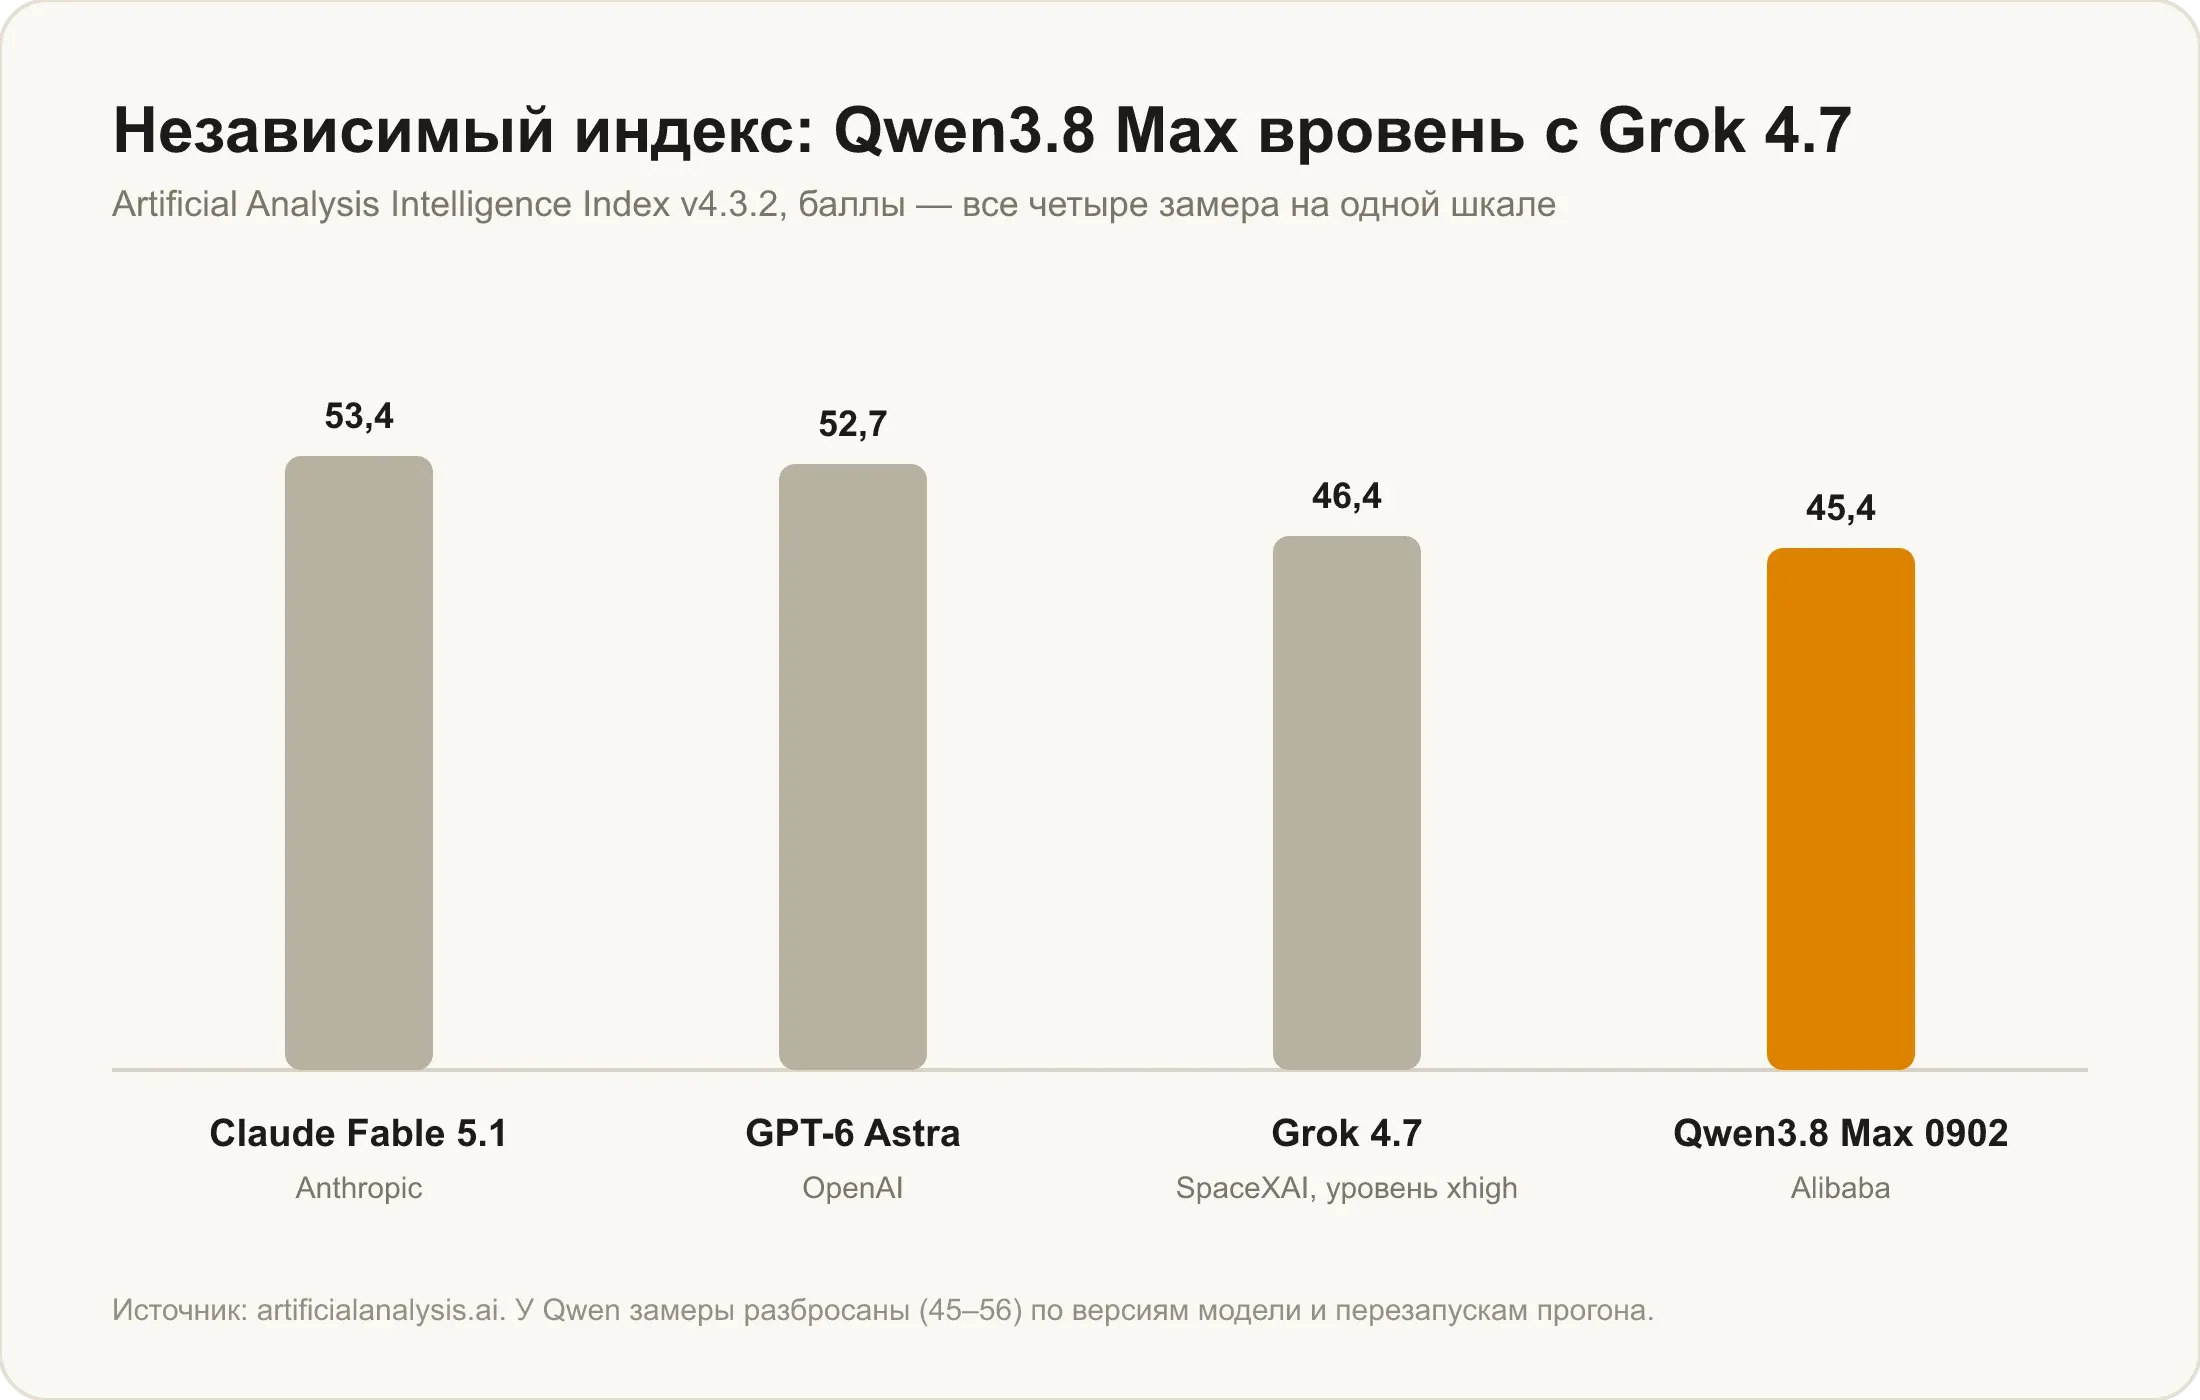
Заодно виден масштаб: обе дешёвые модели отстают от верхушки на семь-восемь баллов. У Claude Fable 5.1 — 53,4, у GPT-6 Astra — 52,7, это верхушка рейтинга. То есть пятикратная разница в цене покупает не пятикратную разницу в качестве, но и не ничью.
Любопытно, что обе модели агрегатор описывает одинаково — медленные и очень многословные. Со скоростью сравнение тоньше, чем кажется: у Qwen 39,2 токена в секунду, у Grok 4.7 — 39,5 на максимальном уровне рассуждений xhigh, но 55,3 на уровне high, который стоит по умолчанию. То есть в обычном режиме Grok заметно быстрее. Расход тоже отличается: на прогон индекса Grok израсходовала 240 млн токенов, Qwen — 190 млн (Artificial Analysis).
Контекст: здесь разрыв настоящий
Окно у Qwen 3.8 Max — миллион токенов, у Grok 4.7 — 500 тысяч. Вдвое.
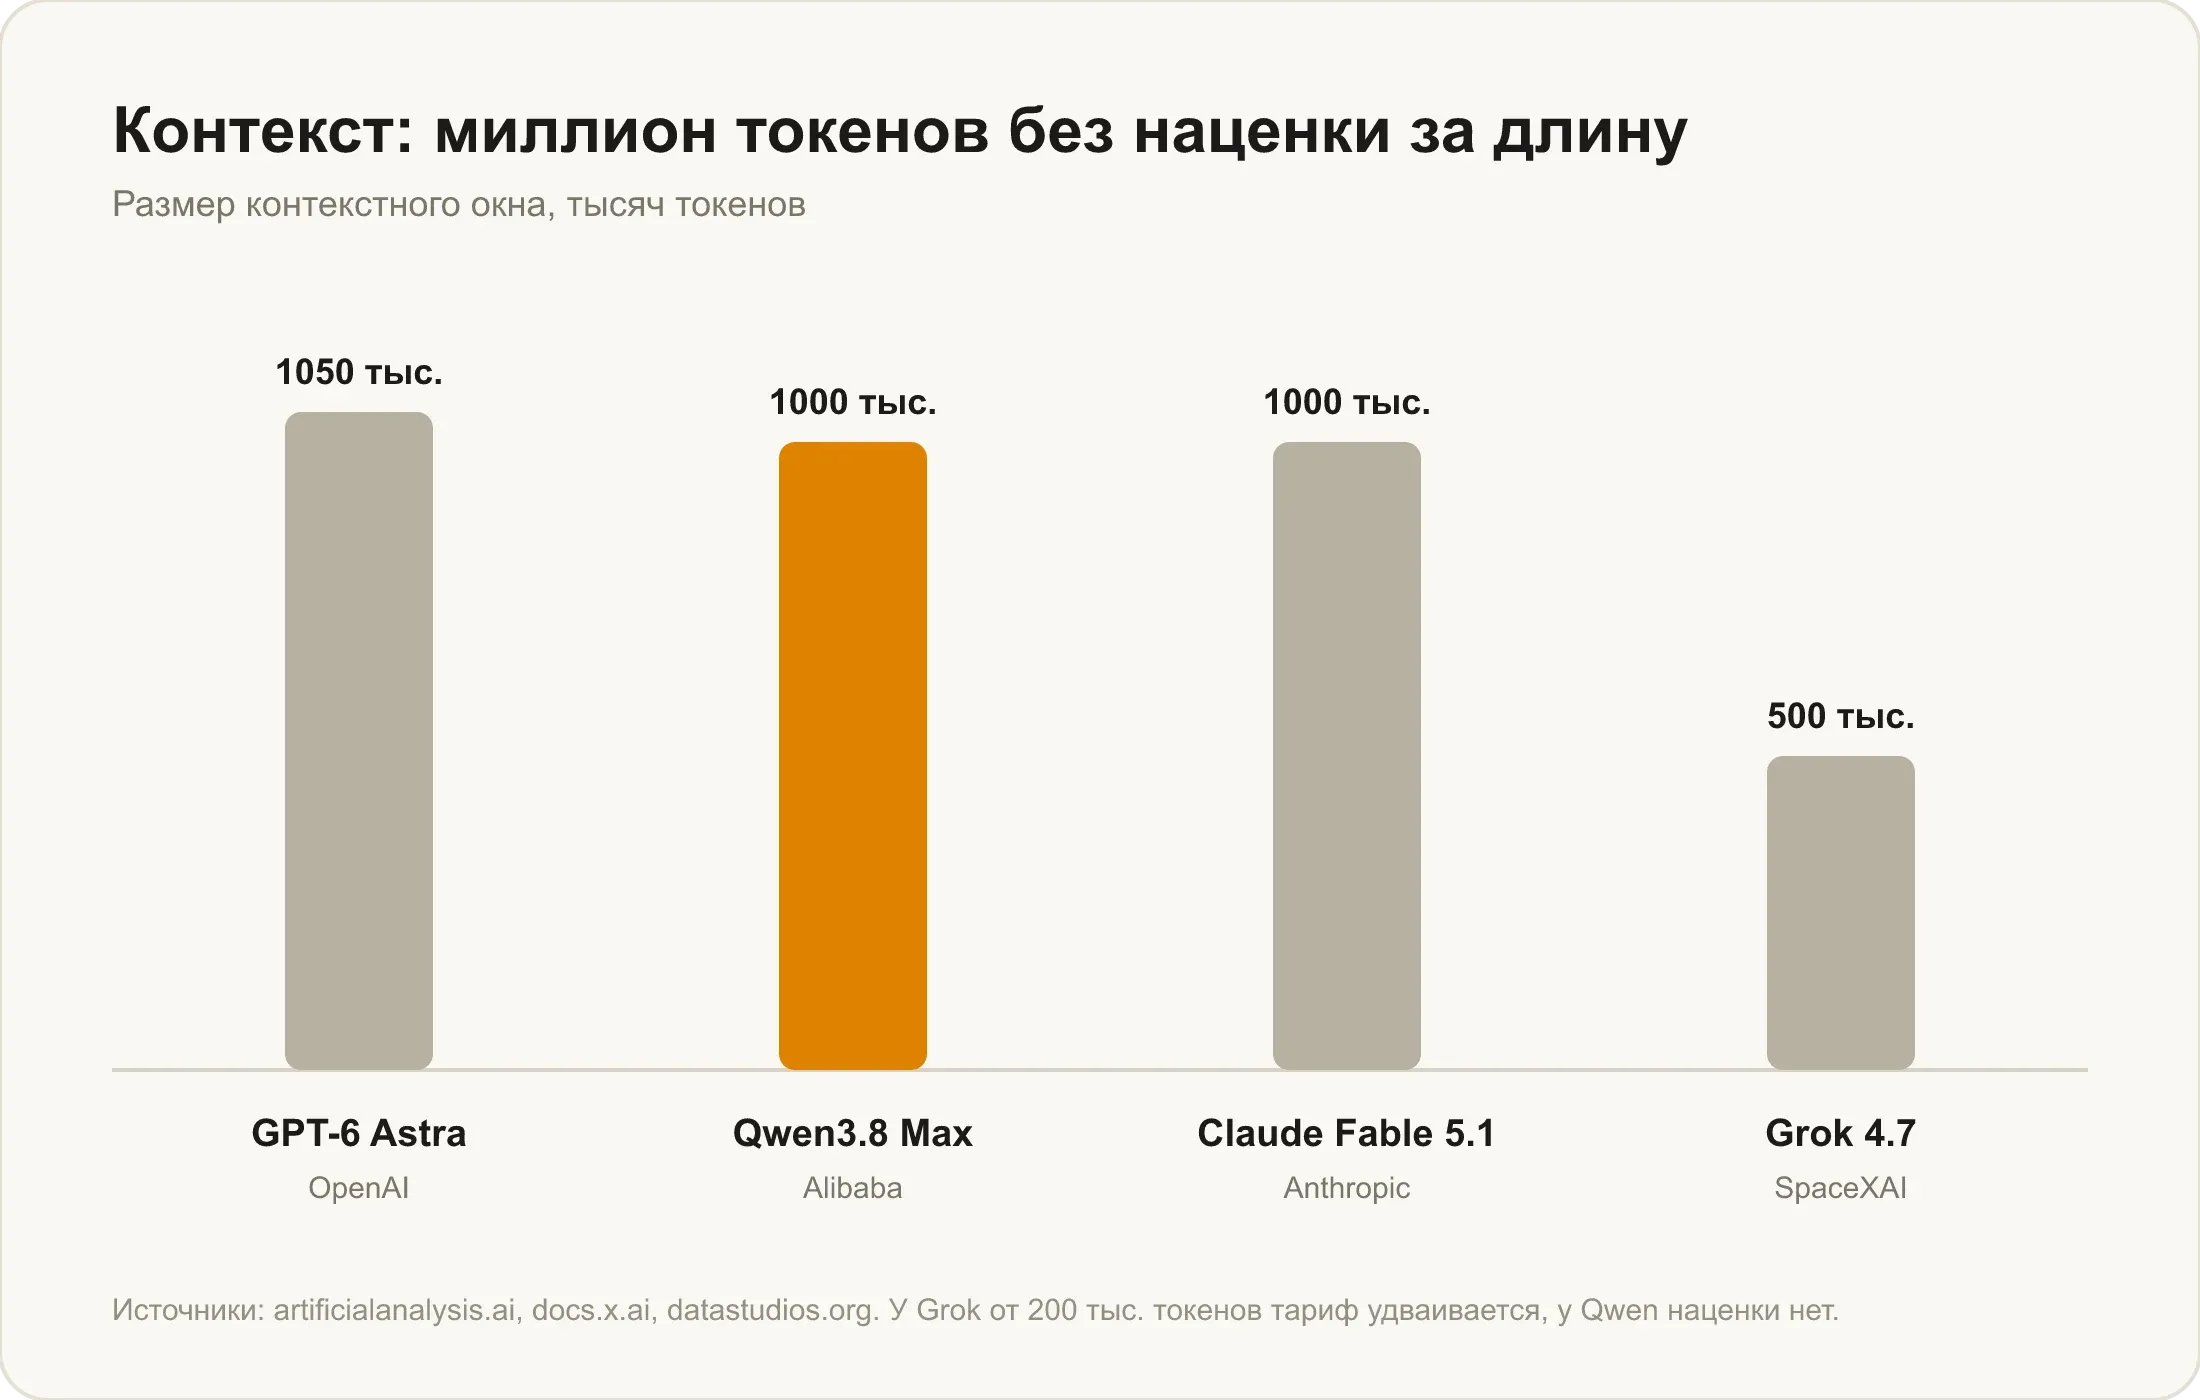
Но размер окна здесь — только половина истории. Вторая половина в том, как считаются деньги на длинном запросе. У Grok 4.7 есть порог: промпт свыше 200 тысяч токенов пересчитывается по удвоенному тарифу целиком, $4 и $12, а не только объём сверх порога. У Qwen такого порога нет вообще — миллионный промпт стоит по той же ставке, что и короткий.
Складывая одно с другим, получаем: на документе в 300 тысяч токенов Grok не просто ближе к пределу окна, а ещё и вдвое дороже самой себя. Для работы с большими текстами это решающий аргумент, и он не про бенчмарки, а про счёт.
Есть и обратная сторона. По замерам Artificial Analysis, Grok 4.7 на тесте длинного контекста потеряла 3,7 процентного пункта относительно предыдущей версии — то есть даже своё окно она держит хуже, чем раньше. Сопоставимого независимого замера длинного контекста у Qwen нет, так что утверждать, что она удерживает свой миллион идеально, оснований тоже нет.
Характеристики: таблица
Прочерк означает, что сопоставимого публичного результата нет — не додумываем цифру за разработчика. Источники по строкам: CellCog и Artificial Analysis для Qwen, SpaceXAI и тот же агрегатор для Grok. Все цифры актуальны на 22 сентября 2026 года.
| Параметр | Qwen 3.8 Max | Grok 4.7 |
|---|---|---|
| Разработчик | Alibaba | SpaceXAI |
| Дата выхода | 3 августа 2026, снапшот 0902 — 2 сентября | 21 сентября 2026 |
| Архитектура | MoE, 2,4 трлн параметров, ~95 млрд активных | официально не раскрыта |
| Контекстное окно | 1 000 000 токенов | 500 000 токенов |
| Максимальный ответ | 131 000 токенов | не публикуется |
| Вход | текст, изображения, видео | текст, изображения |
| Выход | только текст | только текст |
| Рассуждения | переключаются, есть режим без них | нельзя отключить, 4 уровня глубины |
| Цена ввода | $2 за млн | $2 за млн |
| Цена вывода | $6 за млн | $6 за млн |
| Наценка за длинный промпт | нет | от 200 тыс. токенов тариф удваивается |
| Чтение из кэша | $0,25 за млн | $0,50 за млн |
| Индекс Artificial Analysis v4.3.2 | 45,4 | 46,4 |
| Скорость выдачи | 39,2 токена/с | 55,3 токена/с (high), 39,5 (xhigh) |
| OSWorld-Verified (работа за компьютером) | 86,1% | — |
| PaperBench (воспроизведение статей) | 93,0% | — |
| OmniDocBench 1.5 (разбор документов) | 92,1% | — |
| DeepSWE v1.1 (правки в коде) | 69,3% | 71,0% |
| Terminal-Bench 4.0 (самоотчёт) | — | 38,0% |
| EEBench (электротехника) | — | 64,0% |
| Harvey Legal Agent (юридические задачи) | — | 19,6% |
Строка про видео — не мелочь. Qwen принимает на входе ролики, Grok только картинки. Если задача начинается со слов «вот запись экрана», выбор сужается до одной модели из двух.
Код: единственная строка, где сравнение корректно
DeepSWE v1.1 — один из немногих тестов, по которому обе компании опубликовали результаты под одним названием и одной версией. У Grok 4.7 — 71,0%, у Qwen 3.8 Max после снапшота 0902 — 69,3%. Разница меньше двух пунктов, то есть по правкам в реальных кодовых базах модели практически равны.
Для масштаба полезно вспомнить, где в этом тесте остальные: Muse Spark 1.3 даёт 75,4%, GPT-6 Astra — 74,1%, GPT-5.6 Sol Max — 72,7%, Claude Fable 5.1 — 70,0%. Все современные флагманы уложились в шесть пунктов, и обе наши дешёвые модели — внутри этого диапазона. Шире эту тему мы разбирали в статье какая нейросеть лучше пишет код.
Внешняя оценка при этом у моделей разная по характеру. Qwen 3.8 Max 0902 заняла первое место на лидерборде Code Arena в разделе WebDev с 1691 баллом — это голосование разработчиков на сторонней площадке (Code Arena). У Grok 4.7 своего результата на этом лидерборде нет, зато есть независимый прогон Artificial Analysis по терминалу, показавший около 26% против заявленных компанией 38,0%.
Где каждая выигрывает
У моделей почти не пересекаются области, в которых они хороши, и это делает выбор проще, чем обычно.
Qwen 3.8 Max сильна там, где нужно работать с интерфейсами и документами. 86,1% на OSWorld-Verified — лучший результат среди сопоставленных флагманов на задачах, где агент сам кликает по программам. 92,1% на разборе документов со сложной вёрсткой. Плюс видео на входе и окно на миллион токенов без наценки. Что модель умеет ещё, разобрано в статье что умеет Qwen 3.8 Max.
Grok 4.7 берёт узкими профессиональными сценариями. На инженерных расчётах по электротехнике у неё 64,0% против 56,4% у Claude Fable 5.1 и 39,4% у GPT-5.6 Sol Max. На агентных юридических задачах — 19,6% против 6,7% и 2,5% соответственно: проценты низкие, бенчмарк тяжёлый, но разрыв кратный. И под долгие многочасовые задачи в коде её обучали отдельно. Подробности — в материале что умеет Grok 4.7.
Общая слабость у обеих одна и та же: скорость. Artificial Analysis описывает и ту и другую как медленные и очень многословные, но Qwen медленнее: 39,2 токена в секунду против 55,3 у Grok на уровне рассуждений по умолчанию. Если задача короткая и нужен мгновенный ответ, ни та ни другая не подойдёт.
Деньги: одинаковый прайс, разный счёт
Раз цена за токен совпадает, вся разница в деньгах сводится к тому, сколько токенов модель потратит.
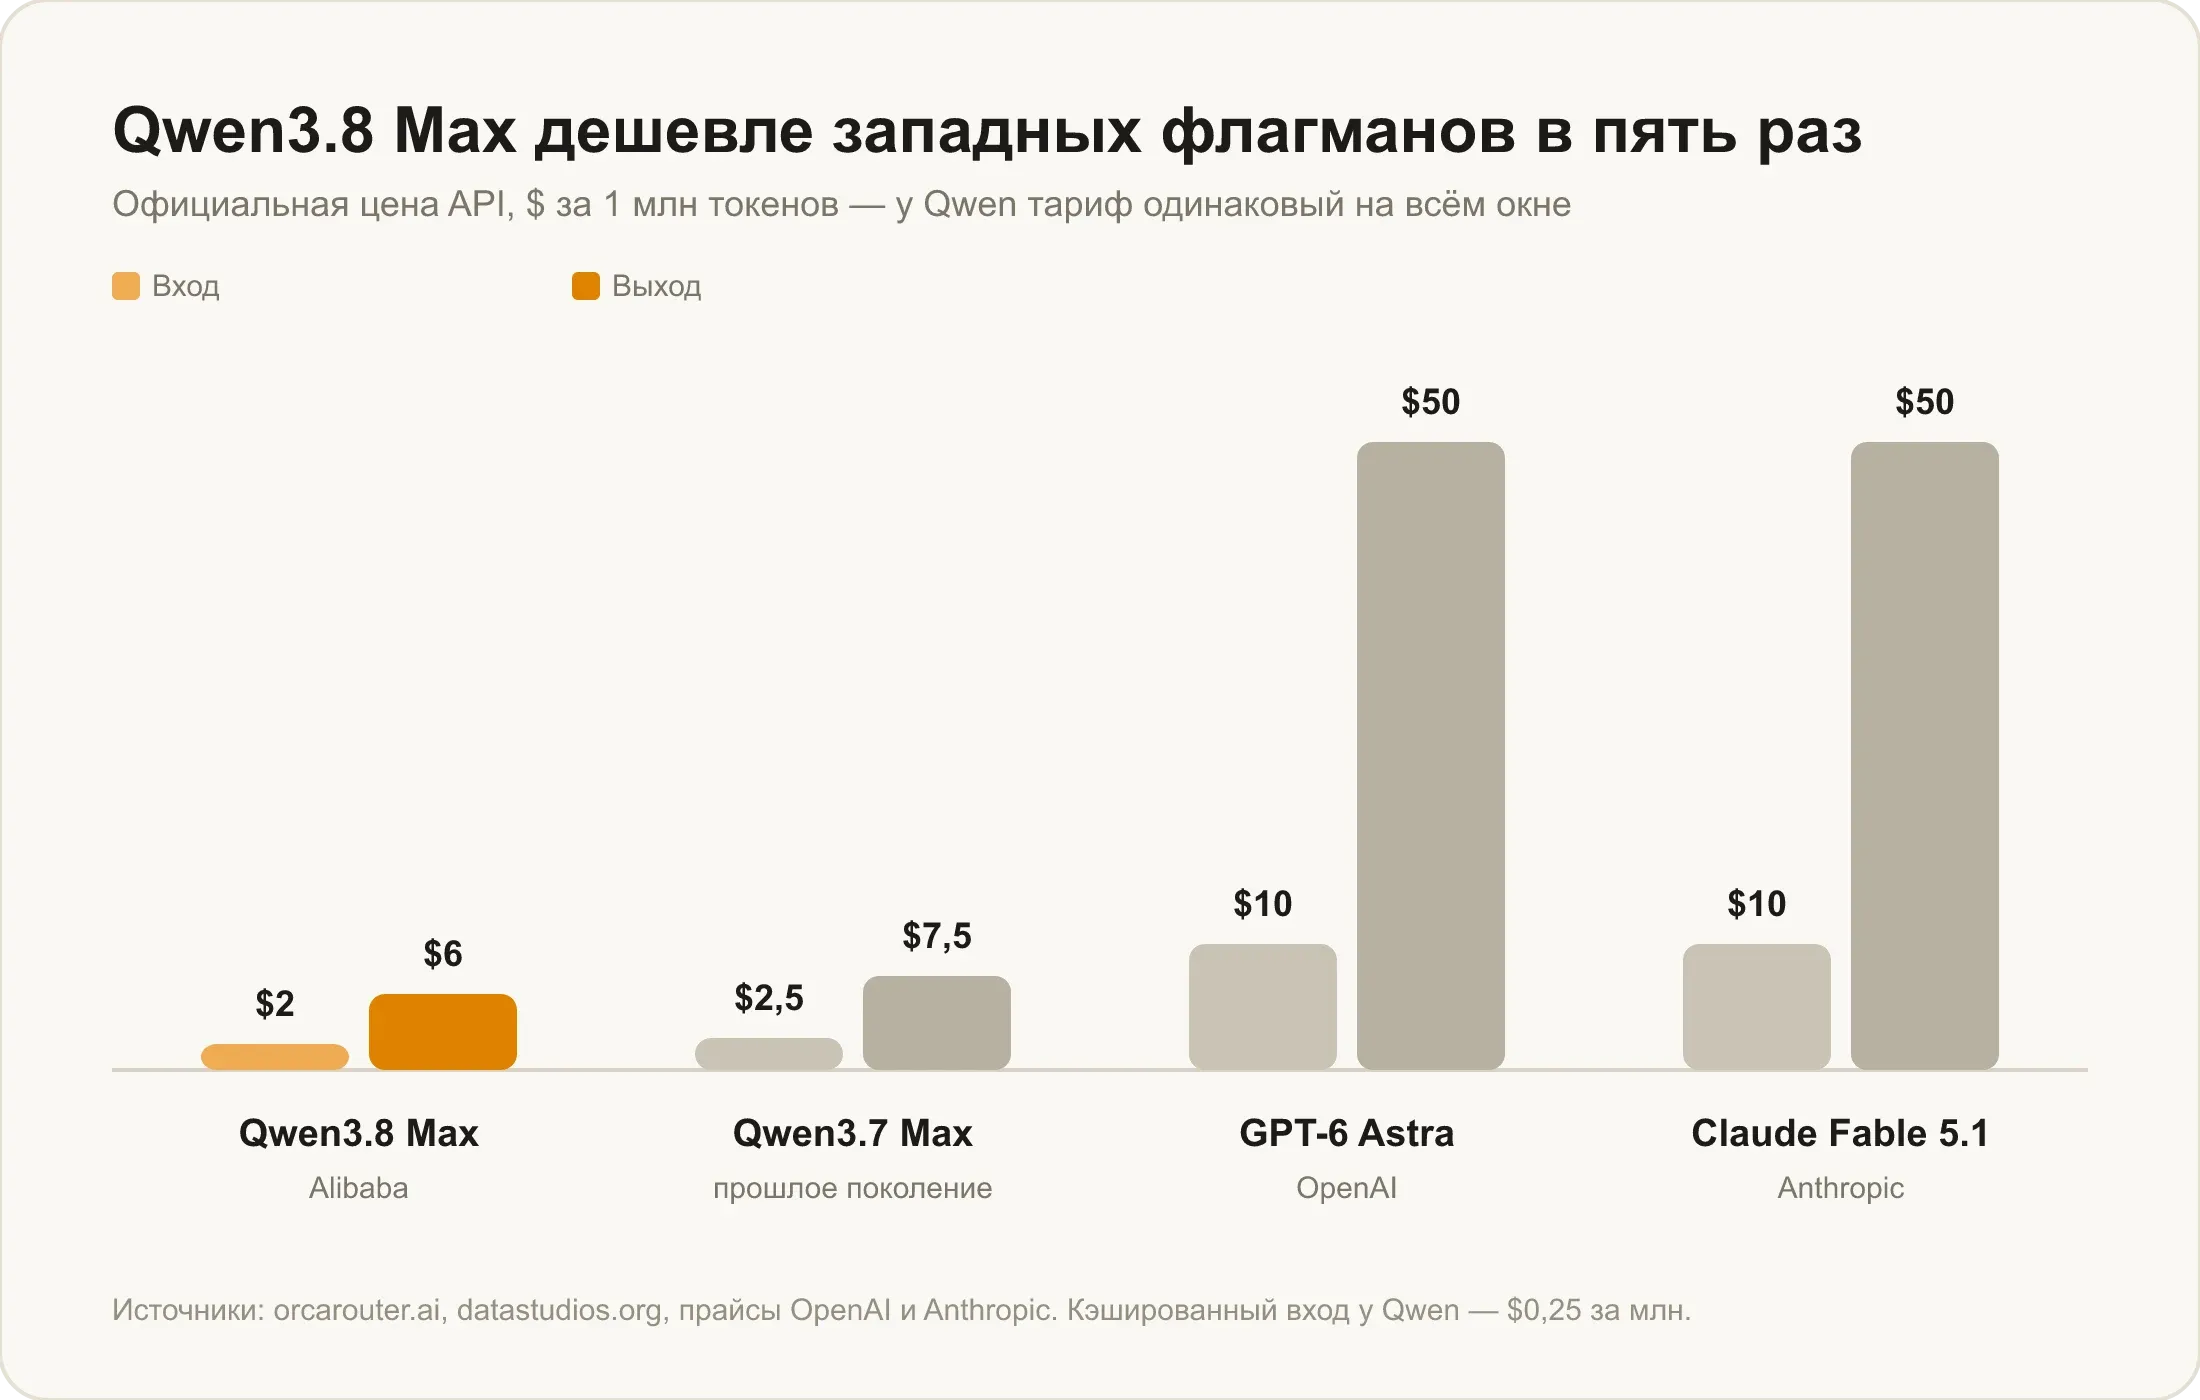
Прямого сопоставления расхода по одинаковой методике нет, но кое-что известно по обеим. Grok 4.7 тратит около 81 тысячи токенов рассуждений на задачу против примерно 36 тысяч у своей предыдущей версии — рост более чем вдвое, и в прогонах Artificial Analysis это выливается в $2,73–3,74 за задачу. У Qwen 3.8 Max агрегатор зафиксировал около 64 шагов на задачу против 14 у предыдущего поколения. Обе модели стали заметно прожорливее предшественниц.
Разница в кэше при этом в пользу Qwen: чтение из кэша стоит $0,25 за миллион против $0,50 у Grok. На сценариях с повторяющимся длинным префиксом — например, один и тот же большой документ в серии запросов — это вдвое дешевле.
И ещё раз про порог: у Grok на промпте от 200 тысяч токенов тариф удваивается, у Qwen наценки нет совсем. Если ваши запросы регулярно уходят за двести тысяч, одинаковый прайс перестаёт быть одинаковым.
Что выбрать под задачу
- Работа с интерфейсами, автоматизация действий в программах — Qwen 3.8 Max: 86,1% на OSWorld-Verified, у Grok сопоставимого публичного результата нет.
- Разбор длинного документа, отчёта, договора — Qwen: окно вдвое больше, наценки за длину нет, разбор сложной вёрстки на 92,1%.
- Видео на входе — только Qwen: Grok 4.7 видео не принимает.
- Инженерные расчёты и юридический агентный разбор — Grok 4.7: в этих узких тестах она обходит и Claude, и GPT с заметным отрывом.
- Долгая многочасовая задача в коде — скорее Grok: обновление затачивали именно под такие сценарии, разрыв с прошлой версией на долгих задачах составил 14 пунктов.
- Правки в обычном продуктовом коде — ничья: 71,0% против 69,3%, разница в пределах того, что перекрывается качеством промпта.
- Фронтенд и генерация целых приложений — Qwen: первое место на Code Arena в разделе WebDev, оценка сторонней площадки.
Общий вывод такой: при одинаковой цене это не «одна лучше другой», а две разные специализации. Qwen сильнее в работе с содержимым — документами, интерфейсами, длинными текстами. Grok — в узких инженерных и юридических сценариях и в долгих задачах, где модель должна сама держать план. Как та же Grok выглядит против флагмана OpenAI, мы разбирали в материале Grok 4.7 против GPT-6 Astra, а общий подход к выбору — в статье как выбрать нейросеть под задачу.
Как сравнить модели самому
Обе модели есть в каталоге Veruna AI и переключаются в одном чате. Не нужно заводить аккаунты в китайском облаке и у SpaceXAI, чтобы прогнать одну задачу через две модели и сравнить ответы вживую. На вашем документе или вашей кодовой базе они нередко ведут себя иначе, чем на тестовом наборе, и это честнее любого процента из чужой таблицы.
Работает без VPN, с оплатой в рублях. Qwen 3.8 Max и Grok 4.7 открыты на подписке Pro и выше — оформить можно на странице тарифов. Как получить доступ из России, подробно разобрано в статьях как пользоваться Qwen 3.8 Max и как пользоваться Grok 4.7.
Частые вопросы
Что лучше — Qwen 3.8 Max или Grok 4.7? Зависит от задачи, потому что цена у них одинаковая. Qwen сильнее в работе с документами, интерфейсами и длинными текстами, принимает видео и держит миллион токенов без наценки. Grok выигрывает в инженерных расчётах, юридических агентных задачах и долгих многошаговых сценариях в коде.
У какой модели больше контекст? У Qwen 3.8 Max — миллион токенов против 500 тысяч у Grok 4.7. Причём у Grok промпт свыше 200 тысяч токенов пересчитывается по удвоенному тарифу целиком, а у Qwen наценки за длину нет.
Какая модель дешевле? По прайсу они стоят одинаково: $2 и $6 за миллион токенов. Разница появляется на длинных запросах, где у Grok срабатывает удвоение тарифа, и на кэшированном вводе — $0,25 у Qwen против $0,50 у Grok.
Какая модель лучше для кода? Практически ничья. На DeepSWE v1.1 у Grok 4.7 — 71,0%, у Qwen 3.8 Max 0902 — 69,3%. На фронтенде Qwen впереди: первое место на лидерборде Code Arena в разделе WebDev. На долгих многочасовых задачах SpaceXAI обучала модель отдельно, и там преимущество у Grok.
Почему нельзя просто сравнить все бенчмарки двух моделей? Потому что компании прогоняют разные тесты и разные версии одних и тех же тестов. Например, Alibaba публикует Terminal-Bench 2.1 и 3.0, SpaceXAI — 4.0; это наборы задач разной сложности, и их проценты между собой несопоставимы.
Обе модели медленные? Обе не из быстрых, но Qwen медленнее. Artificial Analysis фиксирует у неё 39,2 токена в секунду, у Grok 4.7 — 55,3 на уровне рассуждений high по умолчанию и 39,5 на максимальном xhigh. Для коротких вопросов разумнее взять модель полегче.