
Кратко
- Grok 4.7 стоит $2 и $6 за миллион токенов против $10 и $50 у GPT-6 Astra — разница впятеро.
- В правках реального кода (DeepSWE v1.1) Astra впереди, но всего на три пункта: 74,1% против 71,0%.
- В терминале разрыв уже серьёзный: Astra заявляет 57,7%, SpaceXAI — 38,0%, а независимый замер Grok 4.7 без фирменной обвязки даёт около 26%.
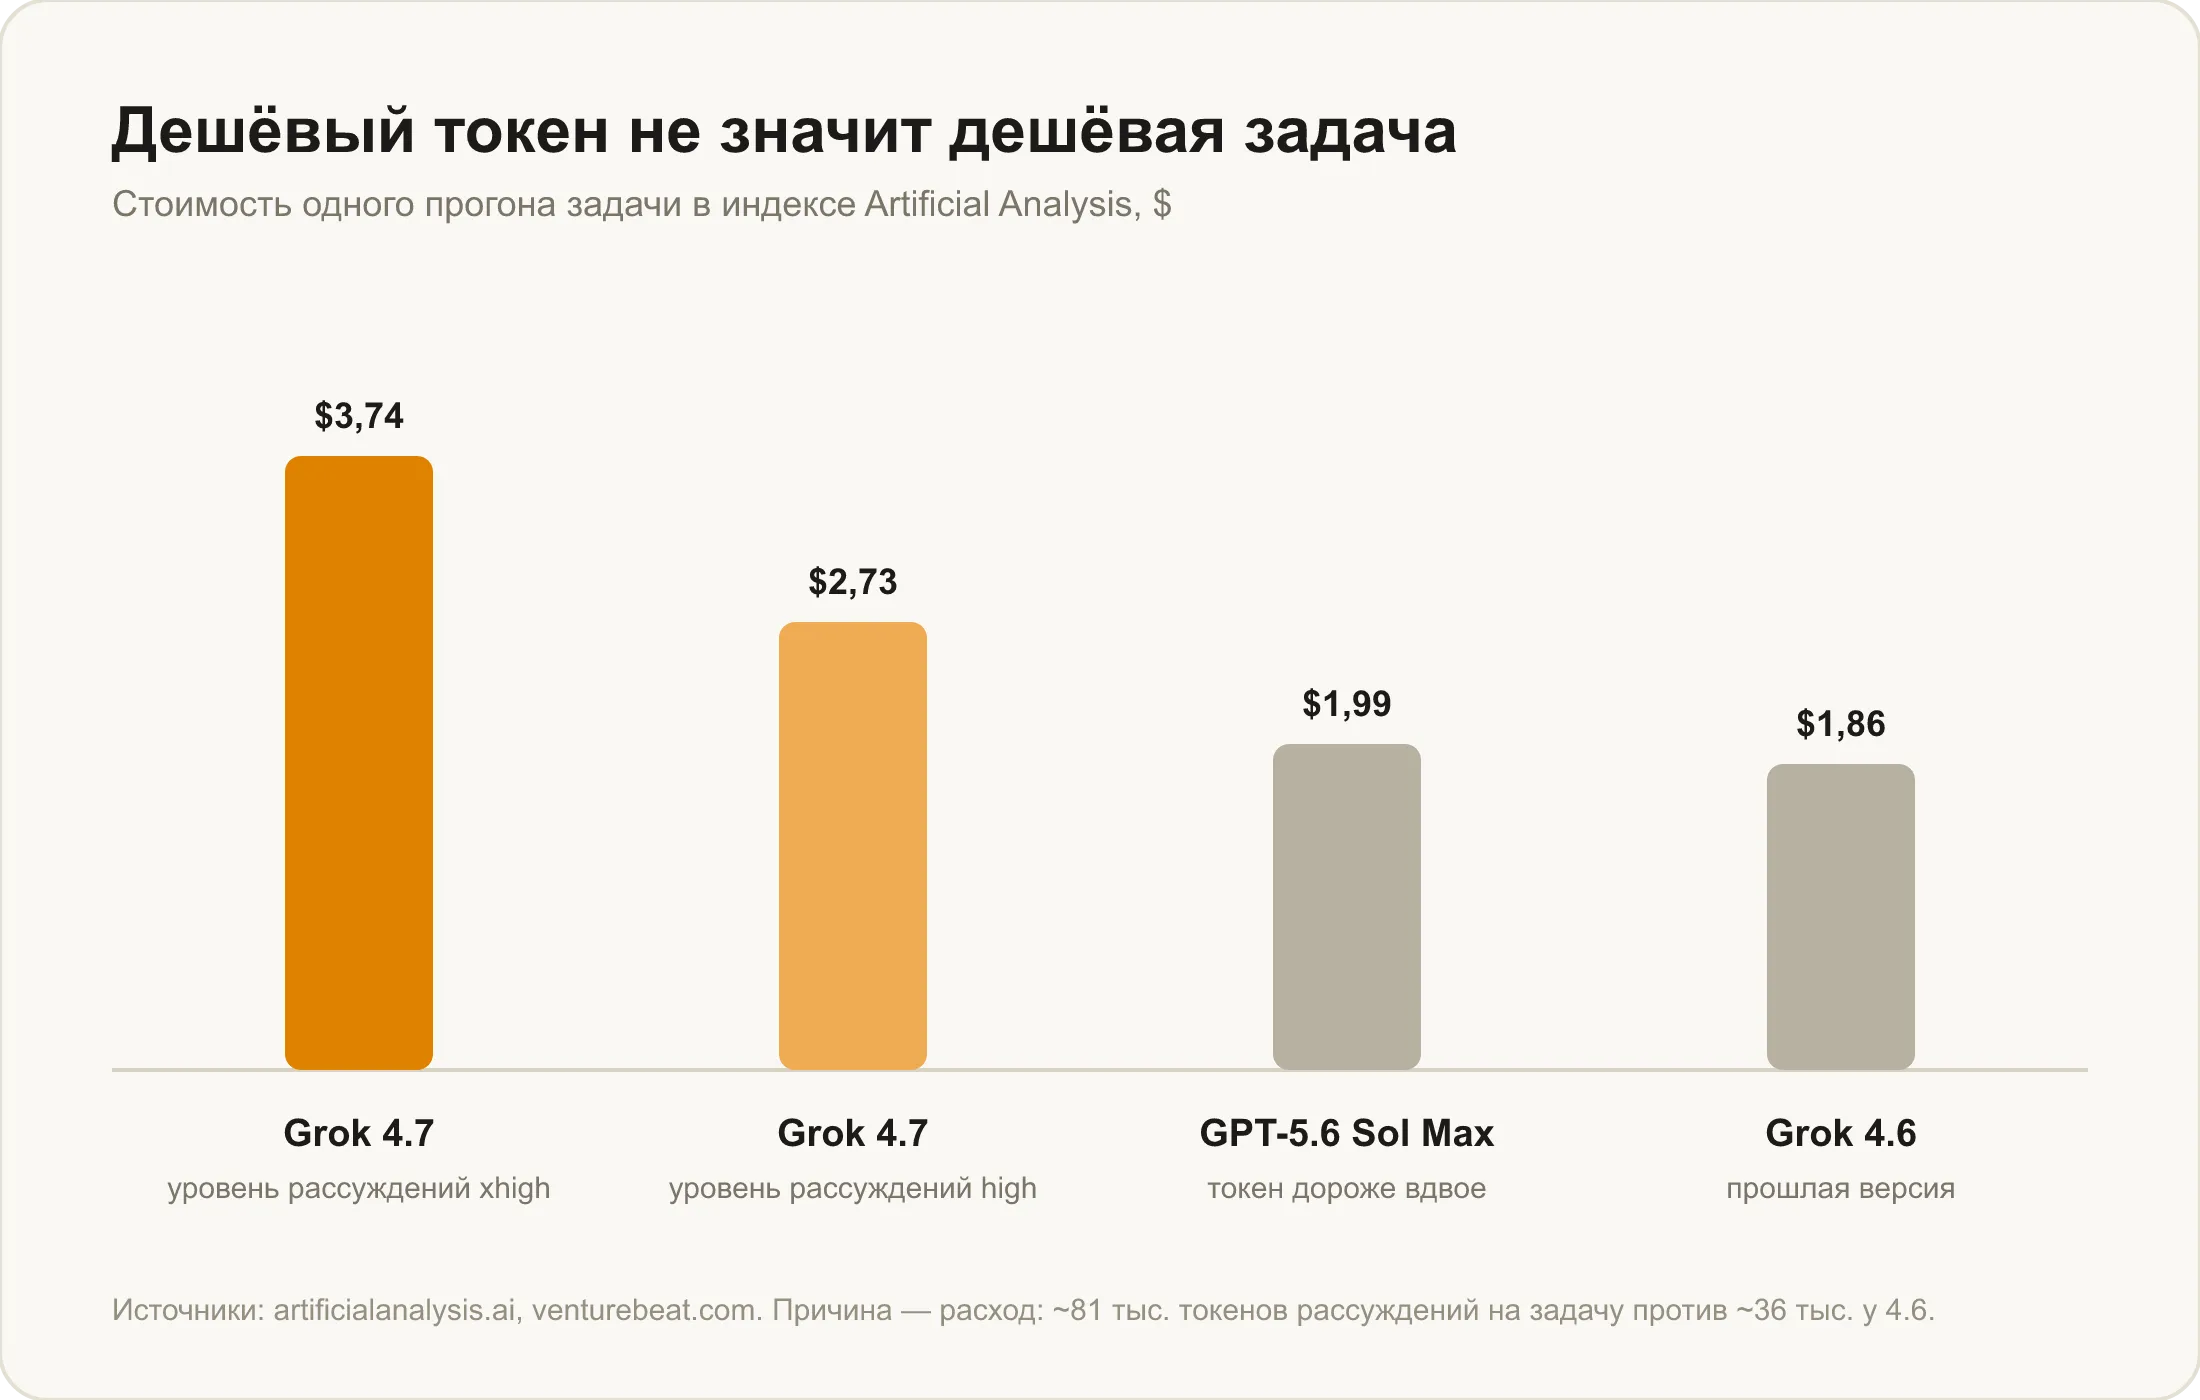
- Дешёвый токен не означает дешёвую задачу: Grok 4.7 тратит на рассуждения почти втрое больше токенов, чем Astra.
Вопрос «грок или чат гпт» в 2026 году сводится к более конкретному: брать дешёвую модель, которая думает долго, или дорогую, которая думает быстрее и точнее. Grok 4.7 от SpaceXAI вышла 21 сентября 2026 года, GPT-6 Astra от OpenAI — в начале того же месяца. Ни одна из них не выигрывает везде, и по запросу «grok 4.7 vs gpt 6» ищут именно это: не общий рейтинг, а конкретные цифры по задачам и по деньгам. Сравнение ниже построено по опубликованным бенчмаркам и прайсам, а не по заголовкам релизов.
Странность, с которой стоит начать
В официальной таблице бенчмарков Grok 4.7 компания сравнивает себя с GPT-5.6 Sol Max и Claude Fable 5.1 — то есть с прошлым флагманом OpenAI и текущим флагманом Anthropic. Самой GPT-6 Astra в основных таблицах нет, она мелькает только в одном графике (SpaceXAI).
Это не обязательно сокрытие: релизные таблицы вообще собирают так, чтобы модель выглядела выигрышно, и так делают все. Но раз прямого сравнения от разработчика нет, собирать его приходится из двух источников — официальных таблиц SpaceXAI и релизных данных OpenAI. Поэтому дальше в таблице встречаются прочерки: там, где сопоставимого замера нет, честнее оставить пустое место, чем додумывать цифру.
Код: разница меньше, чем ожидаешь
DeepSWE v1.1 — тест на правки в реальных кодовых базах и один из немногих бенчмарков, по которому опубликованы результаты обеих моделей. У GPT-6 Astra — 74,1%, у Grok 4.7 — 71,0%. Разрыв в три пункта, при том что токены Astra стоят впятеро дороже.
Для масштаба полезно посмотреть на весь кластер сразу: Muse Spark 1.3 даёт 75,4%, GPT-5.6 Sol Max — 72,7%, Claude Fable 5.1 — 70,0%. Пять современных флагманов уложились в шесть процентных пунктов.
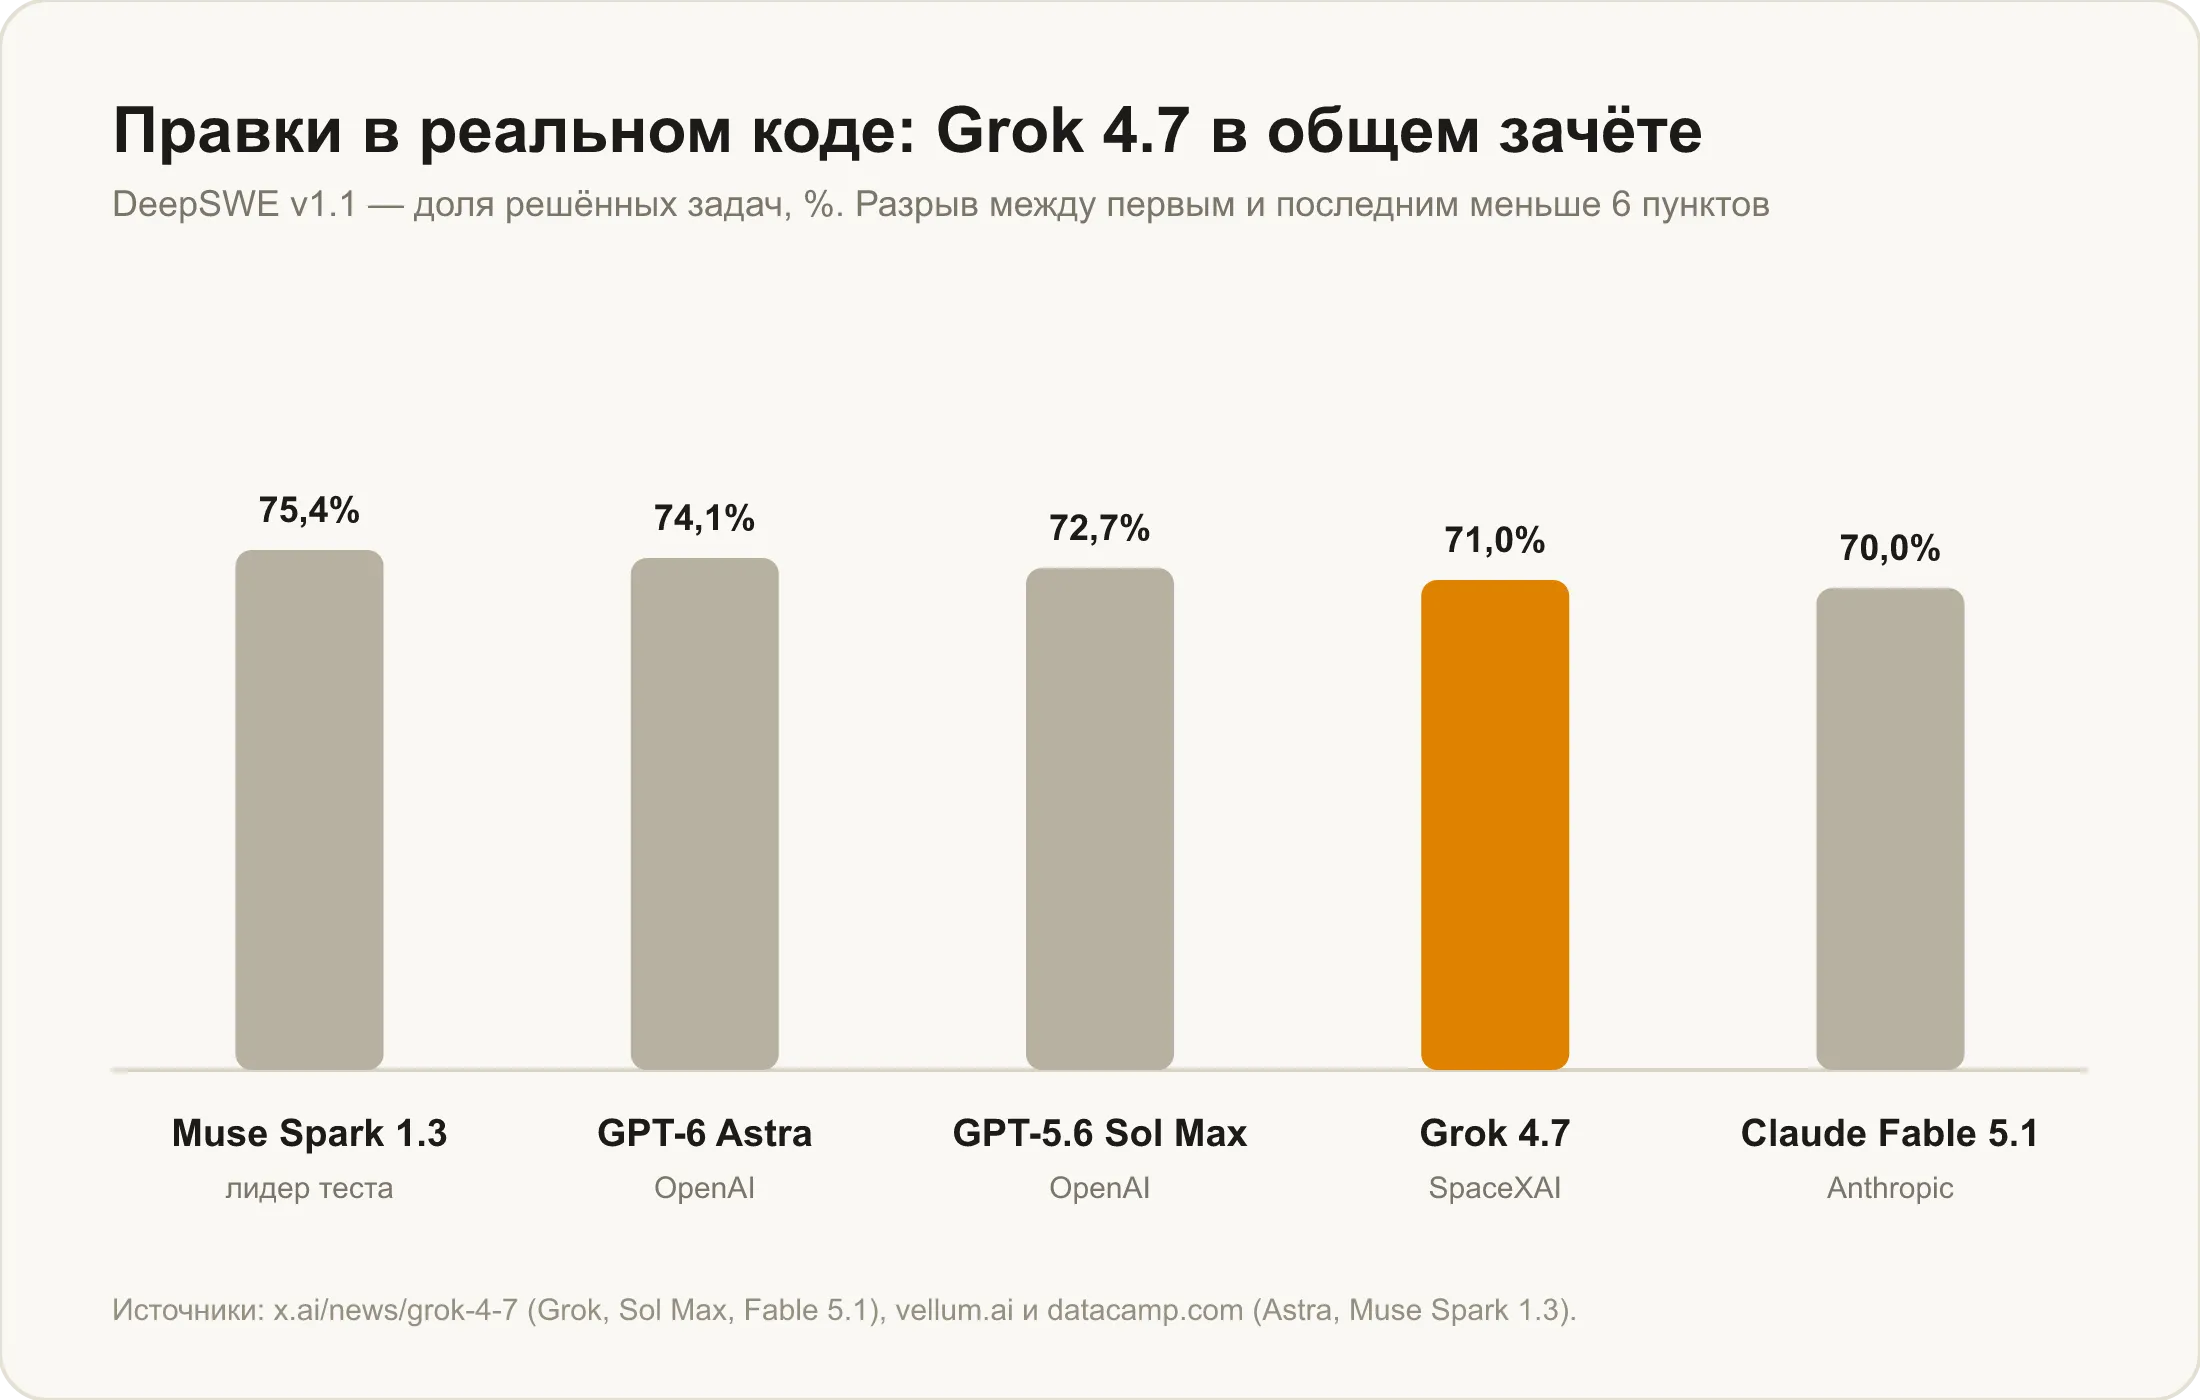
Вывод отсюда неудобный для любителей однозначных ответов: по правкам кода выбирать модель по проценту из бенчмарка бессмысленно, разница в пределах того, что легко перекрывается качеством промпта или особенностями конкретного проекта.
Терминал: здесь разрыв настоящий
А вот в самостоятельной работе в терминале модели расходятся всерьёз. По собственным замерам OpenAI, Astra решает 57,7% задач Terminal-Bench 4.0. SpaceXAI заявляет для Grok 4.7 38,0%, и это уже почти в полтора раза меньше.
Но и эти 38,0% получены с фирменной обвязкой вокруг модели. Artificial Analysis прогнала тест независимо и получила около 26% для Grok 4.7 без обвязки и 33% — в составе агента Grok Build (Artificial Analysis). То есть при сравнении «как есть» разрыв с Astra доходит до двукратного.
Терминал — не абстрактный тест: это сценарий, где модель сама выполняет команды, читает вывод и решает, что делать дальше. Если задача в этом и состоит, разница между моделями будет заметна сразу, без бенчмарков.
Контекст и характеристики: таблица
Прочерк означает, что сопоставимого публичного результата у модели нет — не додумываем цифру за разработчика.
| Параметр | Grok 4.7 | GPT-6 Astra |
|---|---|---|
| Разработчик | SpaceXAI | OpenAI |
| Дата выхода | 21 сентября 2026 | начало сентября 2026 |
| Контекстное окно | 500 000 токенов | 1 050 000 токенов |
| Максимальный ответ | не публикуется | 128 000 токенов |
| Вход | текст, изображения | текст, изображения |
| Выход | только текст | только текст |
| Рассуждения | нельзя отключить, 4 уровня глубины | нельзя отключить, 3 уровня глубины |
| Цена ввода | $2 за млн | $10 за млн |
| Цена вывода | $6 за млн | $50 за млн |
| Чтение из кэша | $0,50 за млн | $1 за млн |
| DeepSWE v1.1 (правки в коде) | 71,0% | 74,1% |
| Terminal-Bench 4.0 (самоотчёт) | 38,0% | 57,7% |
| Terminal-Bench 4.0 (замер Artificial Analysis) | ~26% | — |
| FrontierMath Tier 4 (математика) | — | 97,6% |
| MRCR v2, 512 тыс.–1 млн токенов | — | 96,3% |
| SWE-Marathon v1.1 (долгие задачи) | 46,0% | — |
| EEBench (электротехника) | 64,0% | — |
Контекст — вторая честная развилка. У Astra окно больше вдвое, и на MRCR v2, тесте на поиск фактов в очень длинном документе, она удерживает 96,3% на объёме от полумиллиона до миллиона токенов. У Grok 4.7 сопоставимого результата нет, зато есть замер Artificial Analysis, показывающий откат по длинному контексту на 3,7 пункта относительно прошлой версии. Для разбора многостраничных документов это аргумент в пользу Astra, и довольно весомый.
Деньги: где дешевизна Grok оказывается мнимой
Разница в прайсе выглядит сокрушительной: $2 и $6 против $10 и $50 за миллион токенов.
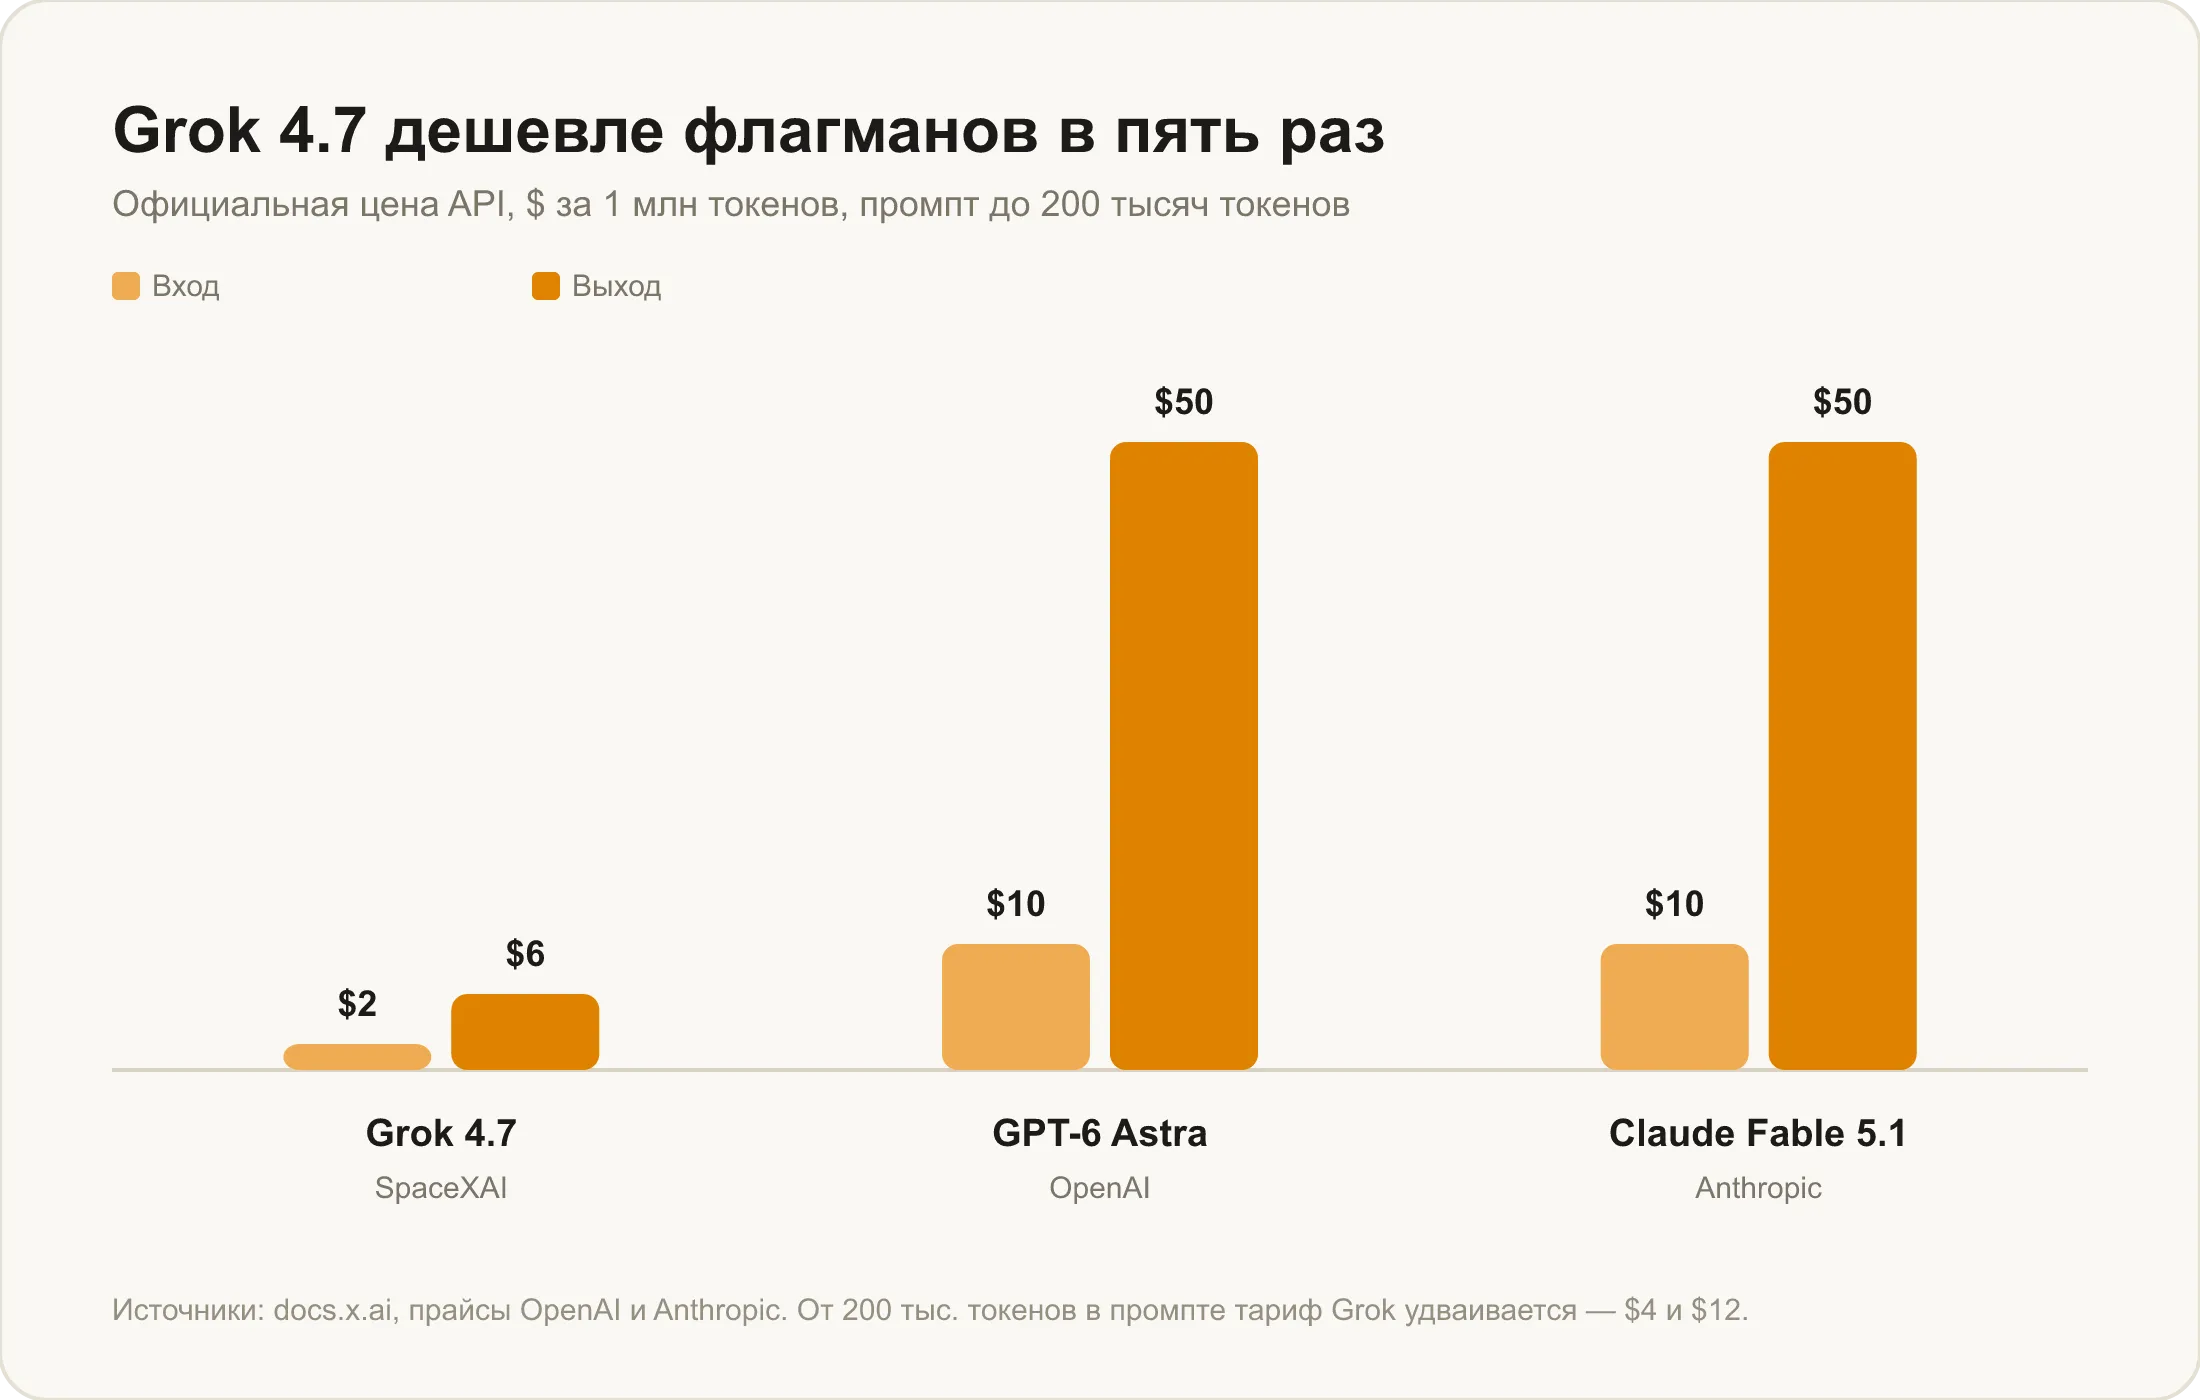
Но считать надо не за токен, а за задачу. Grok 4.7 тратит на рассуждения примерно на 196% больше токенов, чем GPT-6 Astra, на ту же задачу — почти втрое (VentureBeat). В абсолютных числах — около 81 тысячи токенов рассуждений на задачу против 36 тысяч у собственной предыдущей версии.
Во что это выливается по счёту, видно на прогонах Artificial Analysis: одна задача обходится в $3,74 на уровне рассуждений xhigh и $2,73 на high. У GPT-5.6 Sol Max, чьи токены вдвое дороже, — $1,99. У самой Grok 4.6 — $1,86.
Отдельная ловушка — порог в 200 тысяч токенов. Если промпт его превышает, тариф Grok удваивается до $4 и $12, причём пересчитывается весь запрос целиком, а не только объём сверх порога. На больших документах счёт растёт ступенькой.
Так что формулировка «Grok 4.7 впятеро дешевле» верна ровно для прайс-листа. На готовой работе преимущество съёживается, а на некоторых сценариях исчезает совсем.
Что выбрать под задачу
- Сложная математика, доказательства, исследовательские расчёты — Astra: на FrontierMath Tier 4 у неё 97,6%, у Grok 4.7 сопоставимого публичного результата нет.
- Самостоятельная работа в терминале и в программах — тоже Astra: разрыв здесь не косметический, а полуторный даже по самоотчётам, и двукратный по независимому замеру.
- Разбор очень длинного документа целиком — Astra: окно вдвое больше и подтверждённые 96,3% на MRCR v2 против зафиксированного отката Grok по длинному контексту.
- Правки в обычном продуктовом коде — практически ничья, три пункта разницы. Здесь дешёвый прайс Grok 4.7 действительно имеет смысл, особенно если задачи короткие и рассуждений на них уходит немного.
- Долгая многочасовая задача в коде — стоит попробовать Grok 4.7: обновление затачивали именно под такие сценарии, на SWE-Marathon v1.1 разрыв с прошлой версией в 14 пунктов.
- Инженерные расчёты и юридический агентный разбор — Grok 4.7: в этих узких тестах она обходит и Fable 5.1, и Sol Max с заметным отрывом.
Общий вывод получается таким: Astra сильнее там, где нужна глубина и длинный контекст, а Grok 4.7 берёт ценой и выносливостью на долгих задачах в коде. Ни одна из двух не универсальный чемпион, и попытка выбрать «лучшую нейросеть вообще» тут ни к чему не приведёт. Подробнее про каждую — в разборах что умеет Grok 4.7 и что умеет GPT-6 Astra. А как Astra выглядит против флагмана Anthropic, мы разбирали в материале GPT-6 Astra против Claude Fable 5.1.
Как сравнить модели самому
Grok и GPT-6 уже в каталоге Veruna AI и переключаются в одном чате. Не нужно заводить отдельные аккаунты у SpaceXAI и OpenAI, чтобы прогнать одну и ту же задачу через две модели и сравнить ответы вживую — это честнее, чем полагаться на процент из чужого бенчмарка, потому что на вашей кодовой базе или вашем документе модели нередко ведут себя иначе, чем на тестовом наборе.
Работает без VPN, с оплатой в рублях. Grok 4.7 открыта на подписке Pro и выше — оформить можно на странице тарифов. Как получить доступ из России и что с оплатой, разобрано подробно в статье как пользоваться Grok 4.7.
Частые вопросы
Что лучше — Grok 4.7 или GPT-6 Astra? Зависит от задачи. Astra сильнее в сложной математике, работе в терминале и с очень длинными документами. Grok 4.7 стоит впятеро дешевле по прайсу и заточена под долгие многошаговые задачи в коде. В правках обычного кода разница всего три пункта.
Правда ли Grok 4.7 дешевле в пять раз? По прайс-листу да: $2 и $6 против $10 и $50 за миллион токенов. Но на готовой задаче разрыв меньше, потому что Grok 4.7 тратит почти втрое больше токенов на рассуждения. Один прогон задачи в замерах Artificial Analysis обходится ей в $2,73–3,74 — дороже, чем GPT-5.6 Sol Max с вдвое более дорогими токенами.
Какая модель лучше для кода? Явного лидера нет. На DeepSWE v1.1 у Astra 74,1%, у Grok 4.7 — 71,0%, а лучший результат вообще у сторонней Muse Spark 1.3 (75,4%). Разница между пятью флагманами укладывается в шесть пунктов, выбирать разумнее по цене, скорости и поведению на своём проекте.
У какой модели больше контекст? У GPT-6 Astra — 1,05 млн токенов против 500 тысяч у Grok 4.7. При этом у Grok от 200 тысяч токенов в промпте удваивается цена, так что работа с длинными документами обходится дороже, чем кажется по базовому тарифу.
Можно ли сравнить обе модели на своей задаче? Да. Grok и GPT-6 есть в каталоге Veruna AI, переключение между моделями происходит прямо в чате, без отдельных аккаунтов у каждого разработчика. Это надёжнее, чем ориентироваться только на проценты из бенчмарков.