
Кратко
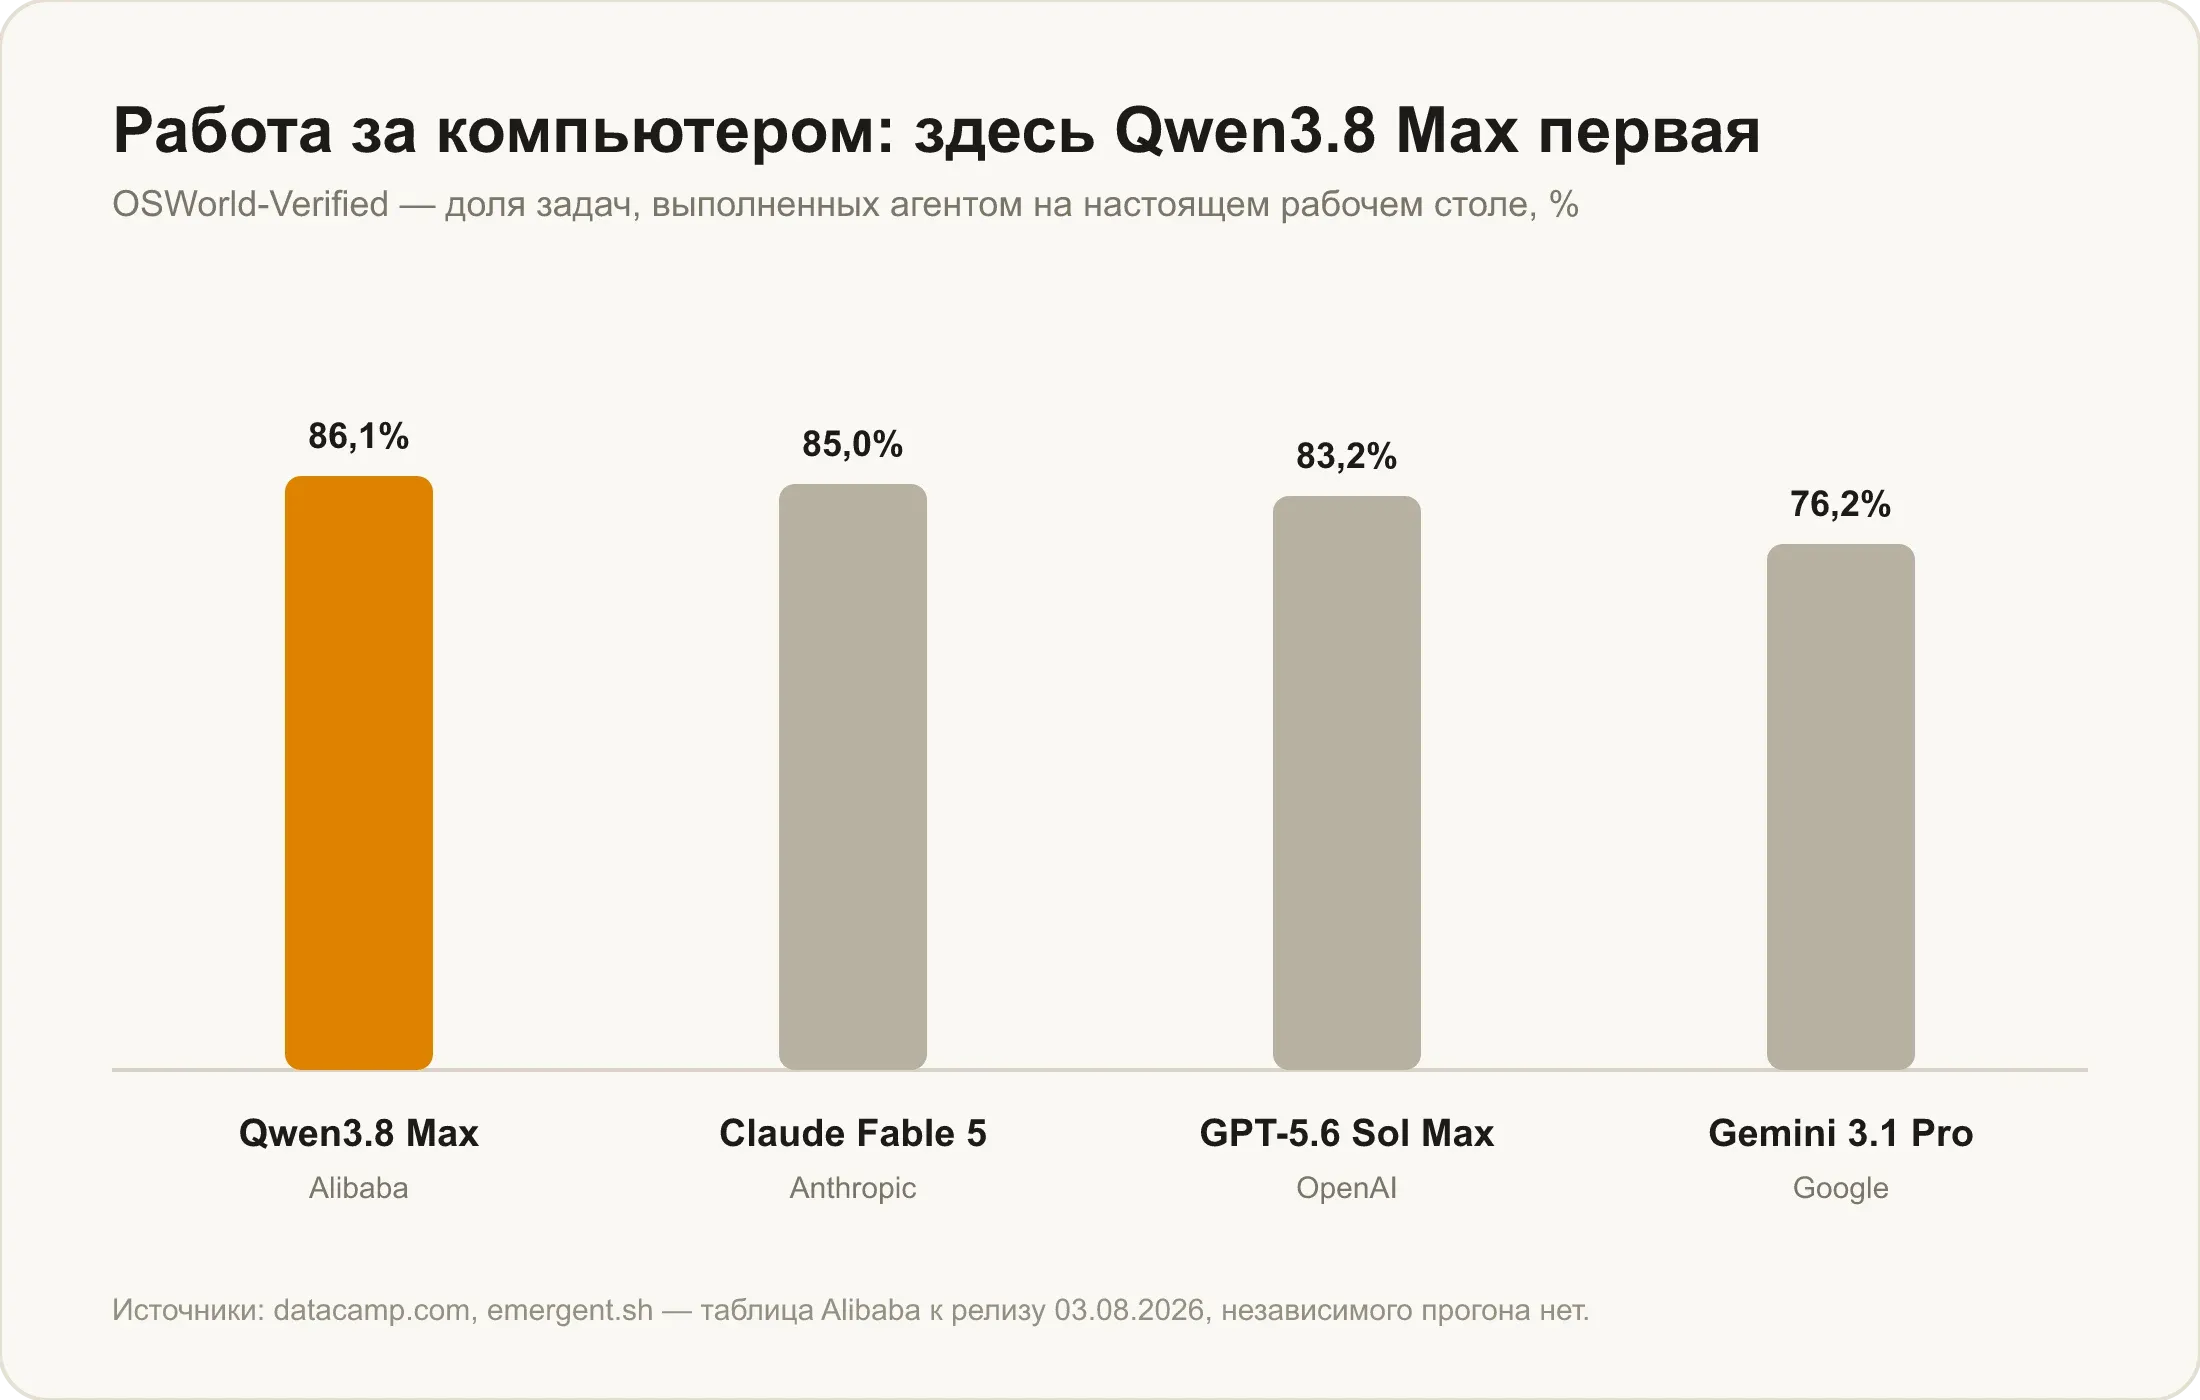
- Сильнейшая сторона Qwen 3.8 Max — работа за компьютером: 86,1% на OSWorld-Verified против 85,0% у Claude Fable 5 и 83,2% у GPT-5.6 Sol Max.
- Модель видит текст, картинки и видео, держит в контексте миллион токенов и хорошо разбирает документы со сложной вёрсткой: 92,1% на OmniDocBench 1.5.
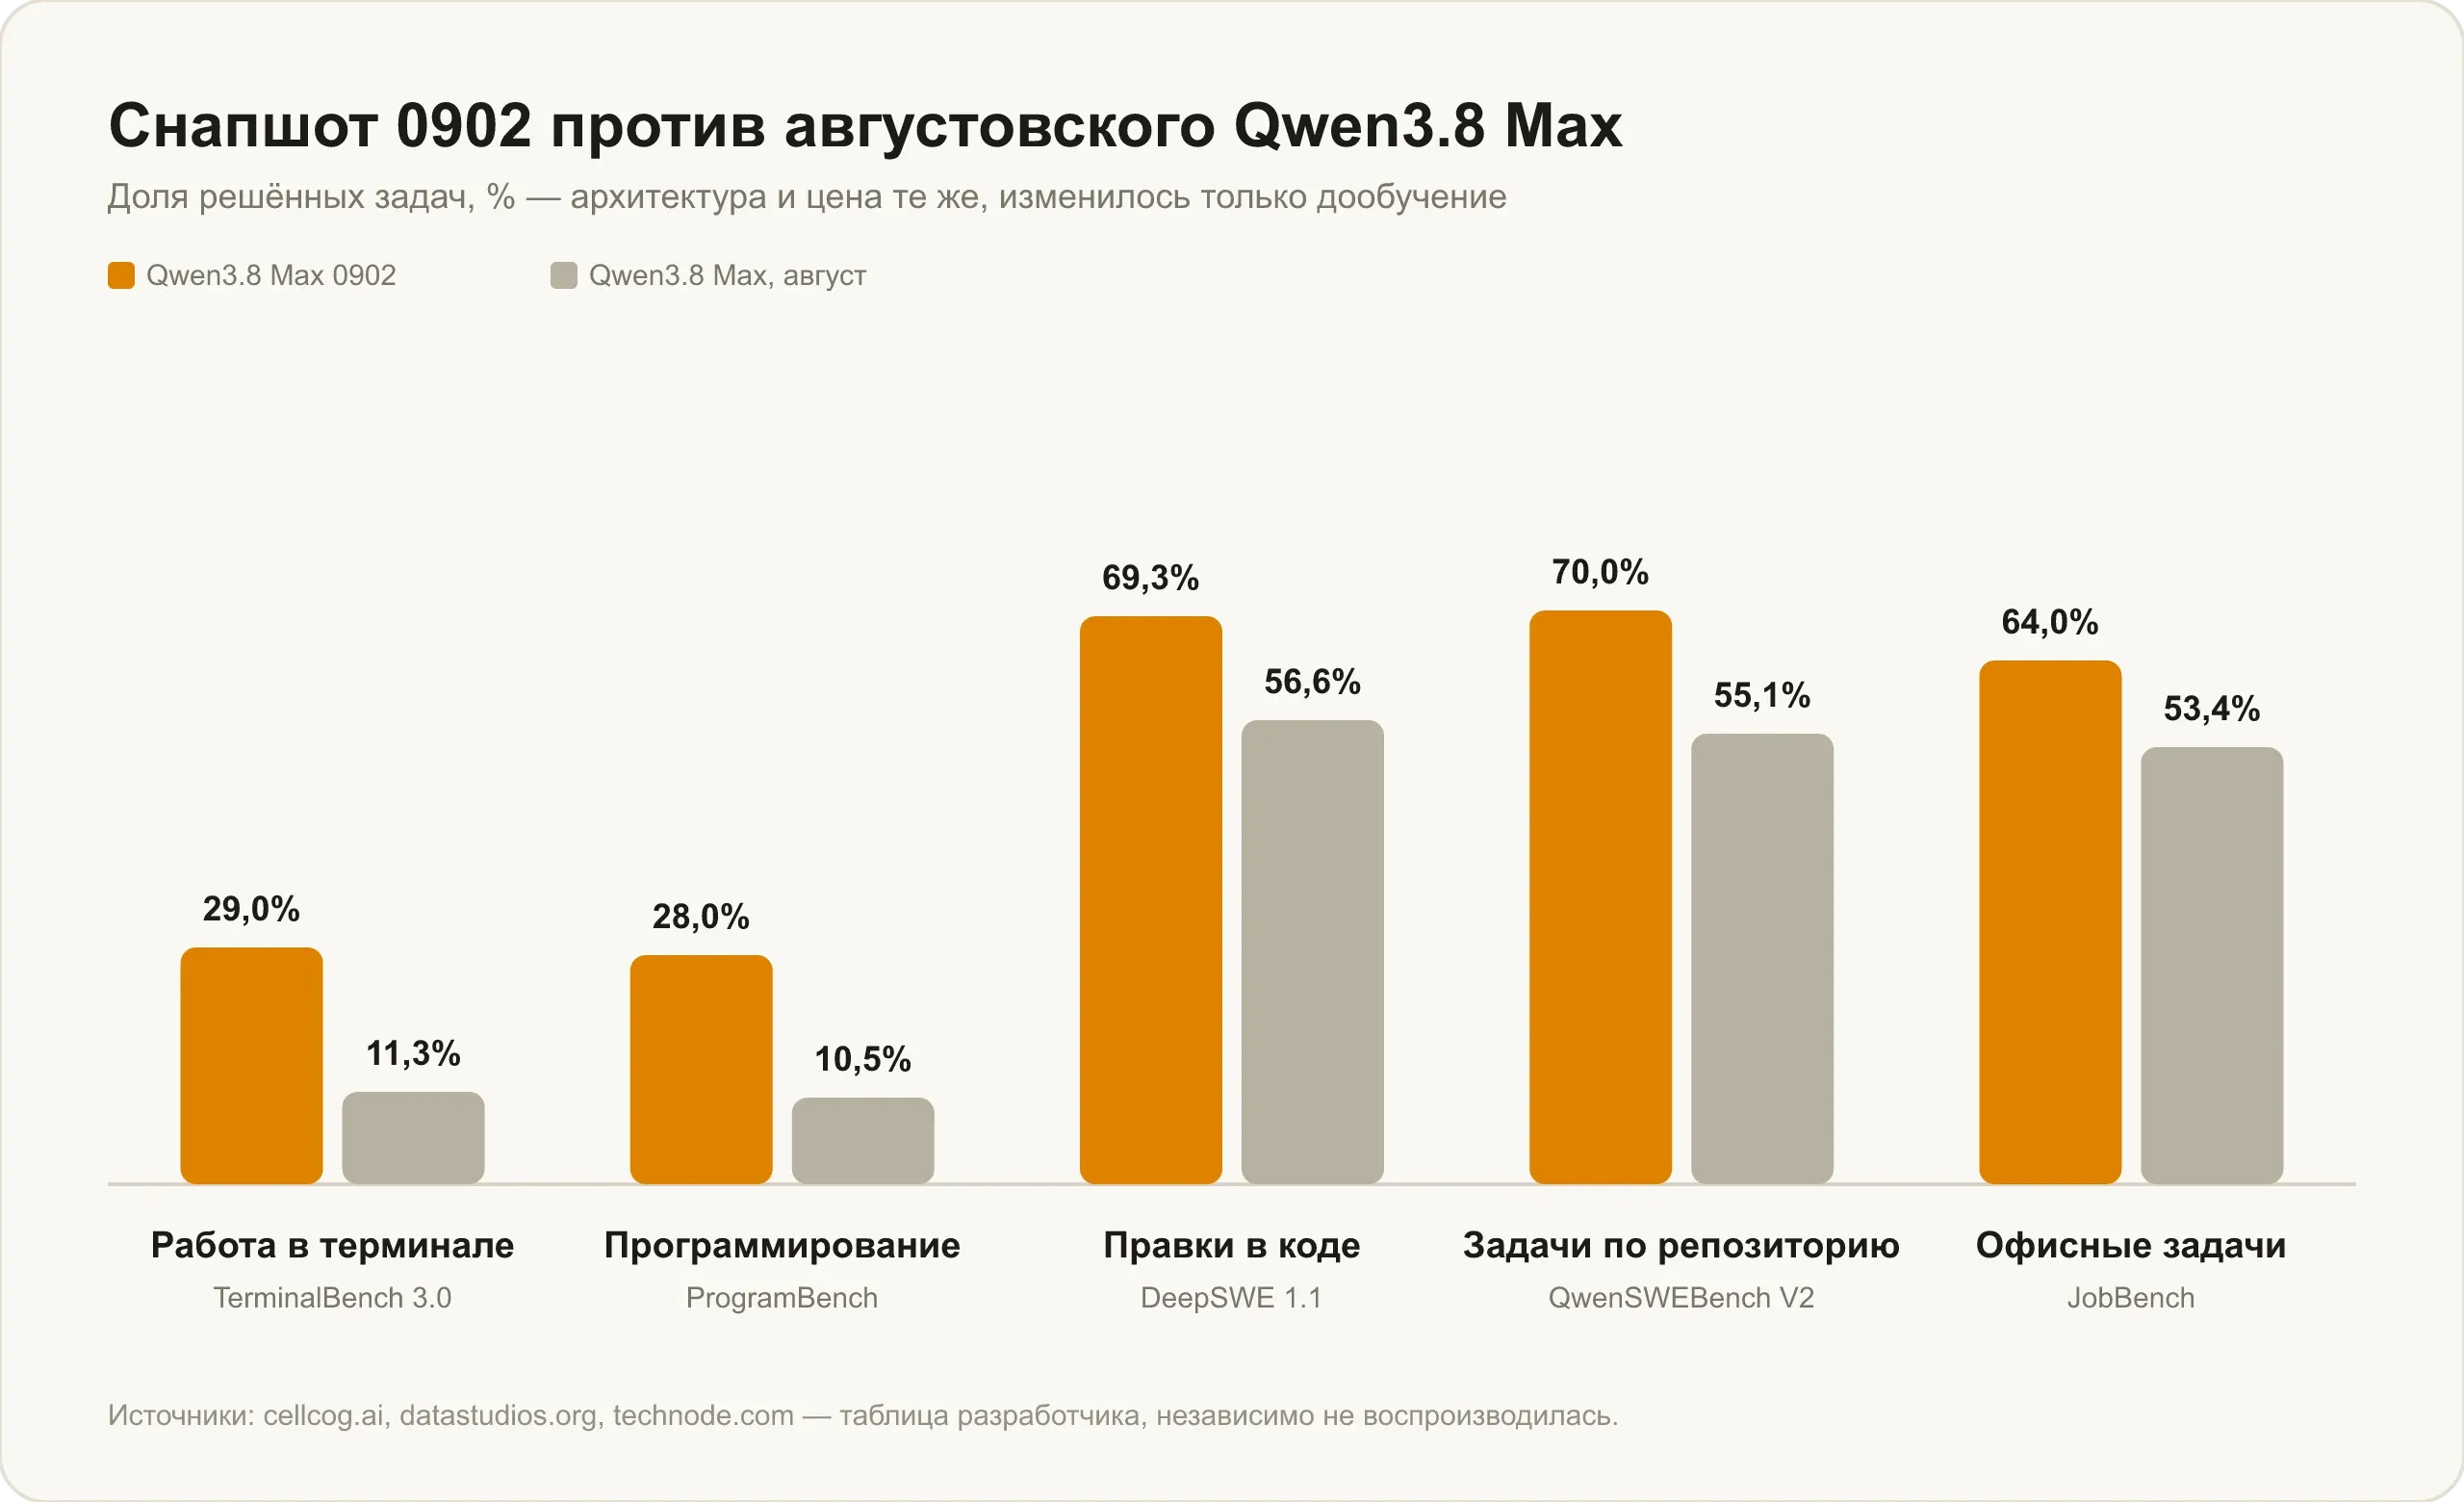
- Сентябрьский снапшот 0902 вытащил код из провала: правки в репозитории выросли с 56,6% до 69,3%, а на лидерборде Code Arena в разделе WebDev модель заняла первое место.
- Слабые места видны в тех же таблицах: 43,6% на тесте широкой эрудиции и 82,8% по следованию инструкциям. Плюс скорость, из-за которой модель попадает во вторую сотню рейтинга по быстроте.
Qwen нейросеть что умеет — тут короткого ответа не выходит, потому что сила у этой модели распределена очень неровно. В одних сценариях она обходит западные флагманы, в других заметно им уступает, и граница проходит не там, где ожидаешь. Разбираем, что умеет Qwen 3.8 Max по бенчмаркам и на практике, и отдельно — где заявленное расходится с независимым замером. Дата выхода, характеристики и цена собраны в материале про релиз Qwen 3.8 Max, здесь только про возможности.
Qwen 3.8 Max: паспортные данные
Контекстное окно — миллион токенов, это примерно полторы тысячи страниц в одном разговоре. На входе модель принимает текст, изображения и видео: по документации до 2048 картинок или до 64 роликов за раз, суммарно около двух часов записи. На выходе только текст, генерации изображений у неё нет.
Архитектура разреженная MoE: 2,4 трлн параметров всего, около 95 млрд активных на токен. Из инструментов модель умеет вызывать функции, искать в интернете, выполнять код и отдавать ответ в заданной структуре. Режим рассуждений переключается — можно попросить думать перед ответом, а можно отвечать сразу.
Видео на входе — то, чем из флагманов может похвастаться далеко не каждый, и это меняет набор доступных сценариев: разбор записи экрана, краткий пересказ вебинара, поиск нужного фрагмента в длинном ролике.
Главная сила: работа за компьютером
Самый заметный результат модели — OSWorld-Verified. Это тест, где нейросеть управляет настоящим рабочим столом: открывает программы, кликает по интерфейсу, переносит данные между окнами и доводит многошаговую задачу до конца. За словом «агент» в продуктовых анонсах обычно стоит именно такой сценарий.
Здесь у Qwen 3.8 Max 86,1%, у Claude Fable 5 — 85,0%, у GPT-5.6 Sol Max — 83,2%, у Gemini 3.1 Pro — 76,2%.
Две оговорки к этой строке. Первая: таблица августовская, и соперники в ней августовские. Сопоставимого результата на OSWorld-Verified у вышедших позже Claude Fable 5.1, Claude Opus 5 и GPT-6 Astra нет, так что «первая» здесь означает «первая среди тех, с кем Alibaba себя сравнила».
Вторая — на случай, если вы видели другие цифры по OSWorld. У семейства есть несколько наборов и режимов проверки, и в таблицах Anthropic, например, встречается строгий режим OSWorld 2.0 с результатами около сорока процентов у всех участников. Это другой протокол, а не та же метрика: сопоставлять 86,1% с ним нельзя.
Рядом стоит второй сильный результат — PaperBench, где модель должна воспроизвести научную работу по её тексту: 93,0%, лучший показатель среди сопоставленных. И третий, менее эффектный, но более прикладной: 92,1% на OmniDocBench 1.5, разборе документов со сложной вёрсткой — таблицами, колонками, формулами, сканами. Для человека, которому нужно вытащить данные из годового отчёта, эта цифра полезнее всех остальных (DataCamp, emergent.sh).
Научные вопросы уровня аспирантуры модель решает на 92,6% (GPQA Diamond) — ровно столько же, сколько Claude Fable 5. А в математике по картинке (MathVision) у неё 95,2%: снимок задачи с доски или страницы учебника она разбирает уверенно.
Код: провал в августе, разворот в сентябре
В августовском релизе код был слабым местом. На SWE-bench Pro модель набрала 67,7% против 80,0% у Claude Fable 5, и это при том, что кодинг был заявлен одним из приоритетов.
2 сентября Alibaba выпустила снапшот 0902 — ту же модель с тем же контекстом и прайсом, но переобученную. Разворот получился резким: работа в терминале по строгой версии теста выросла с 11,3% до 29,0%, программирование по ProgramBench — с 10,5% до 28,0%, правки в коде (DeepSWE v1.1) — с 56,6% до 69,3%, задачи по репозиторию (QwenSWEBench V2) — с 55,1% до 70,0%, офисные задачи (JobBench) — с 53,4% до 64,0% (CellCog).
Главное подтверждение пришло со стороны. На лидерборде Code Arena в разделе WebDev, где рейтинг складывается из голосов разработчиков, а не из таблицы вендора, снапшот дебютировал на первом месте с 1691 баллом — на три пункта выше Claude Opus 5 в режиме максимального усилия, на семнадцать выше Kimi K3 и на двадцать два выше собственной августовской версии (Code Arena). Это единственная цифра релиза, которую посчитал не сам разработчик.
Где Qwen 3.8 Max по-прежнему уступает
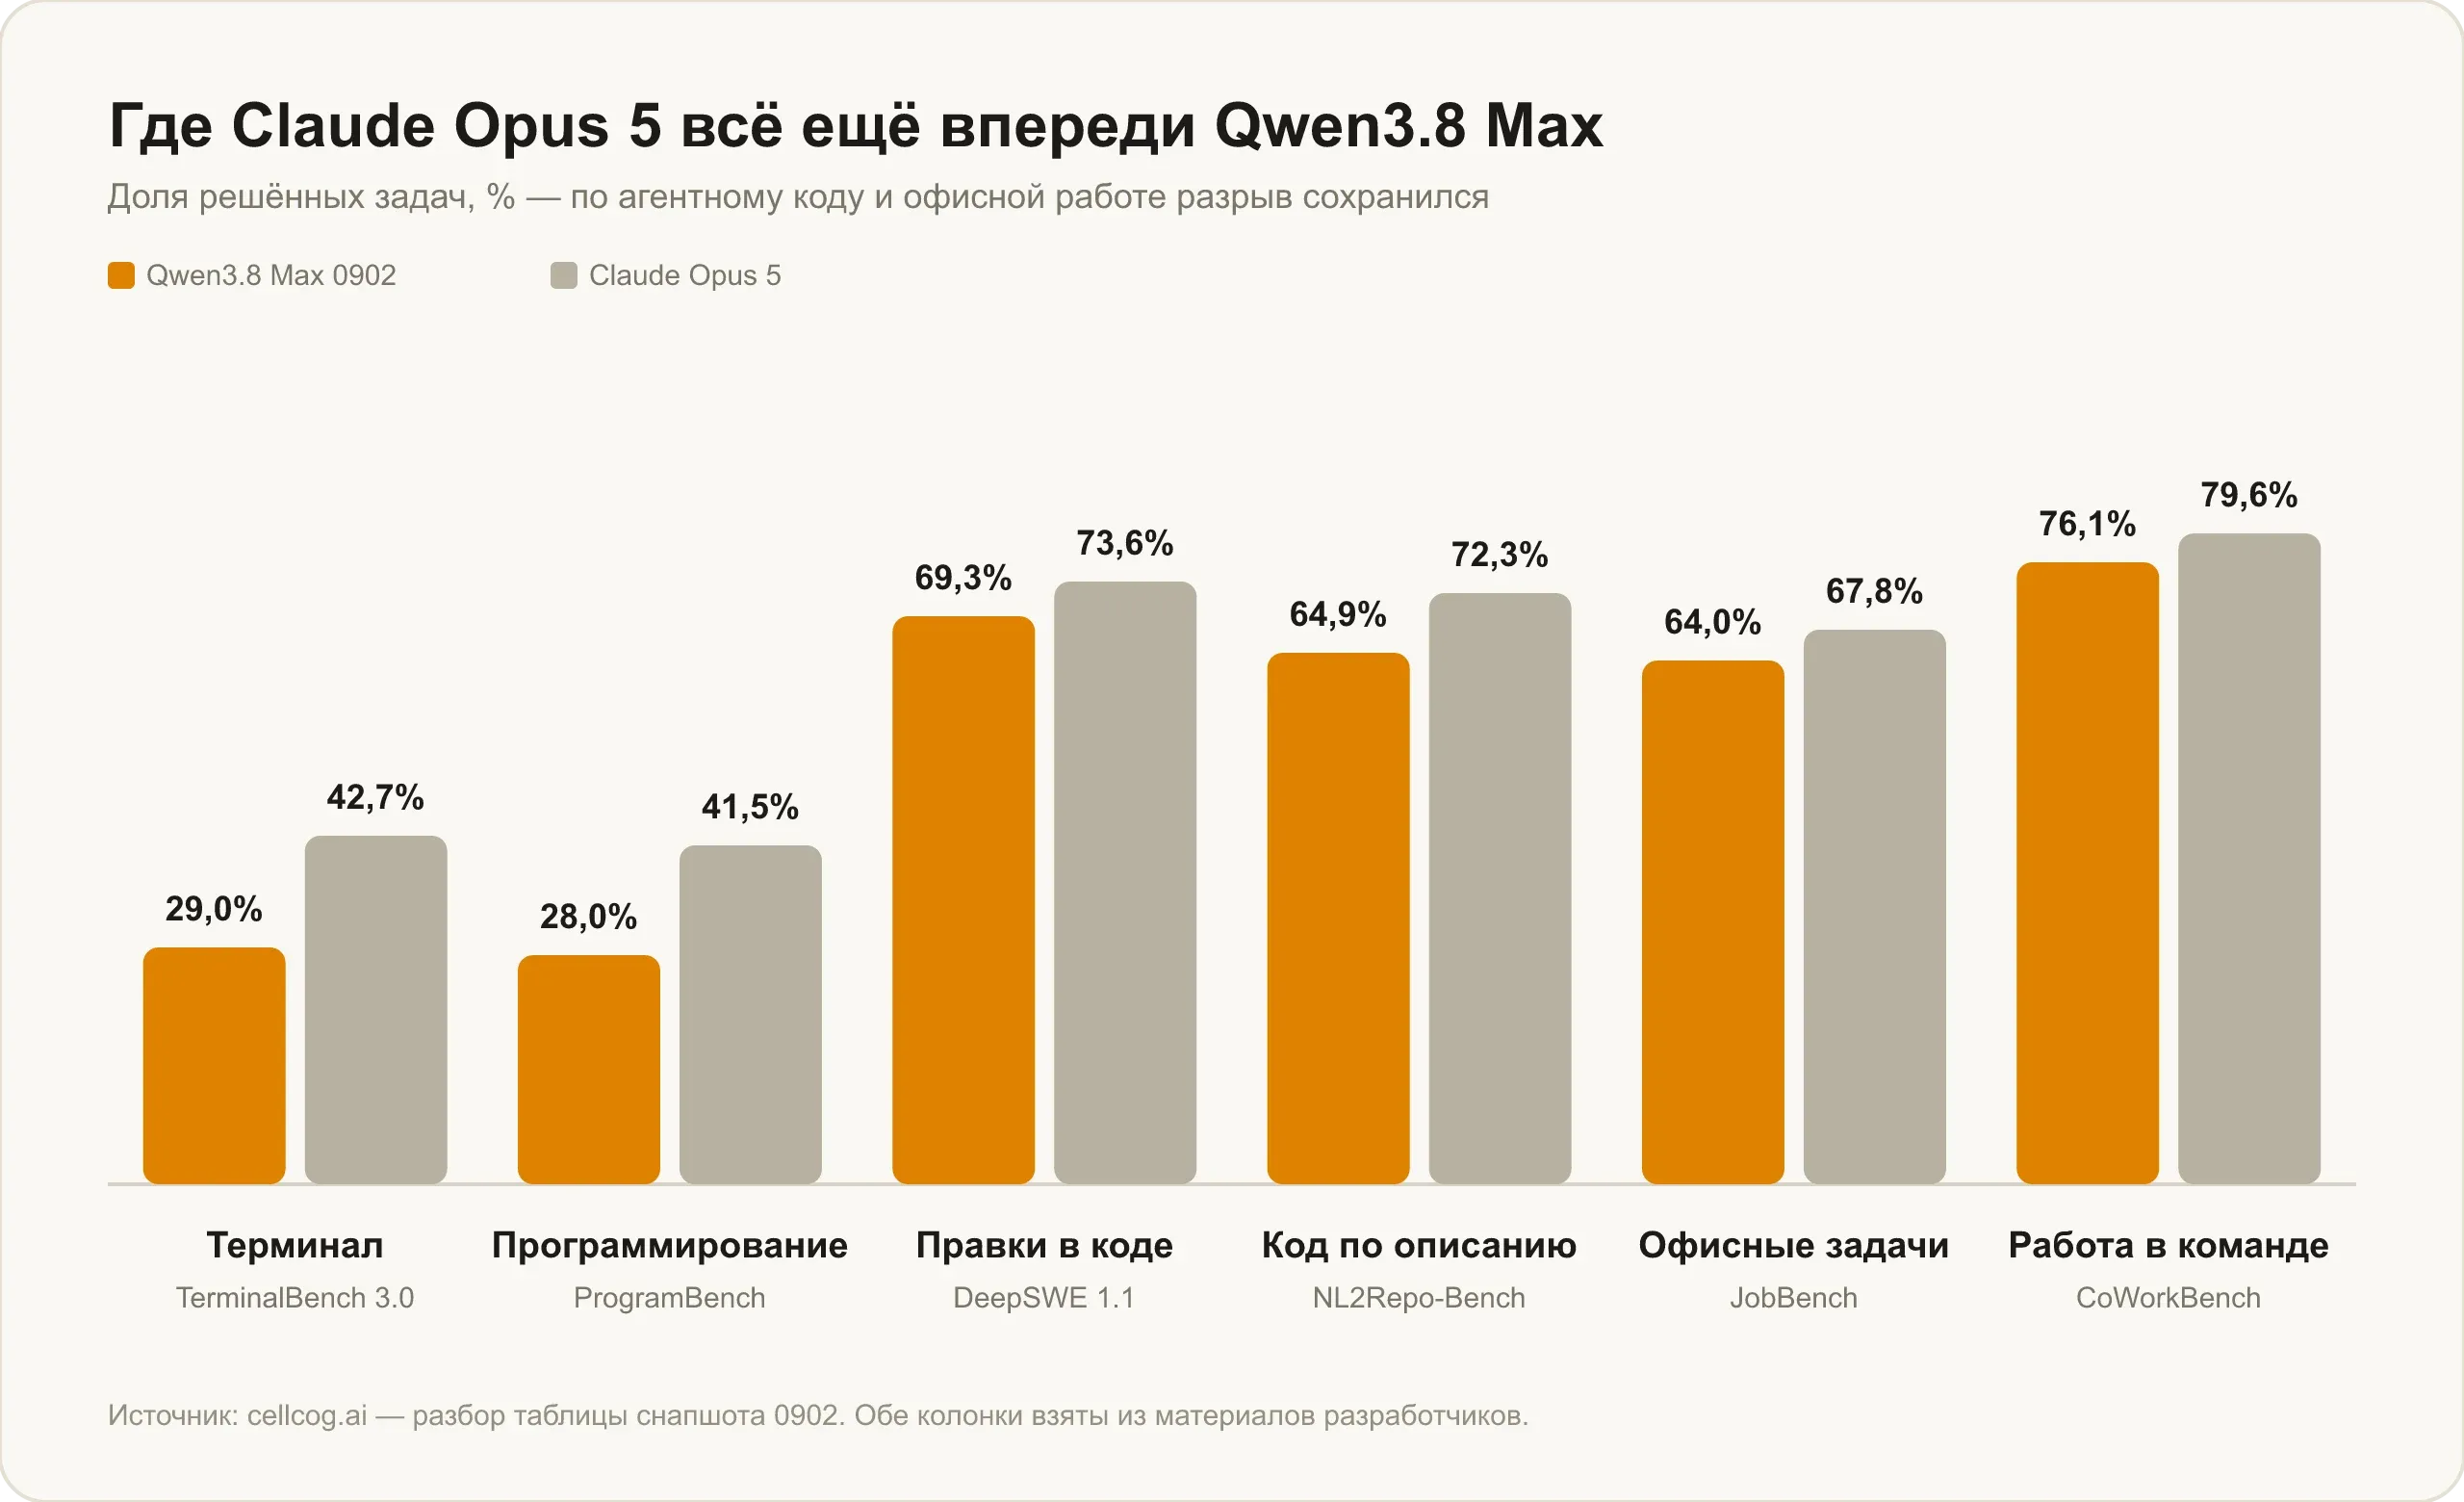
Первое место в вебе не означает, что модель обошла конкурентов везде. В той же сентябрьской таблице Claude Opus 5 остаётся впереди почти по всем агентным строкам: работа в терминале (TerminalBench 3.0) — 42,7% против 29,0%, программирование (ProgramBench) — 41,5% против 28,0%, правки в коде (DeepSWE v1.1) — 73,6% против 69,3%, генерация кода по описанию (NL2Repo-Bench) — 72,3% против 64,9%, офисные задачи (JobBench) — 67,8% против 64,0%, совместная работа (CoWorkBench) — 79,6% против 76,1%.
Впереди китайская модель оказывается в паре узких мест: вопросы по кодовой базе (SWE-Atlas QnA) — 66,3% против 63,2%, автоматизация рутины (AutomationBench) — 50,8% против 50,3%. В первом случае разрыв около трёх пунктов, во втором он в пределах погрешности; общую картину это не меняет.
Отдельная зона провала — широкие знания. На Humanity's Last Exam у Qwen 3.8 Max 43,6%, последнее место среди четырёх флагманов того периода. И следование инструкциям просело: 82,8% на IFBench, тоже худший результат в четвёрке. На практике это выглядит как модель, которая хорошо делает работу, но своевольничает с формой ответа — просили список, получили эссе.
Медленная и многословная
Ещё одно свойство, которое не видно в процентах, но заметно с первой минуты. По замерам Artificial Analysis скорость выдачи у модели — 39,2 токена в секунду: 153-е место в их рейтинге по быстроте. На прогон одного индекса агрегатора модель израсходовала 190 млн токенов, и на задачу у неё уходит около 64 шагов против 14 у предыдущего поколения.
Сводный индекс интеллекта у Artificial Analysis — 45,4 балла. Для сравнения на той же версии шкалы: у Claude Fable 5.1 — 53,4, у GPT-6 Astra — 52,7, у Grok 4.7 — 46,4 (Artificial Analysis).
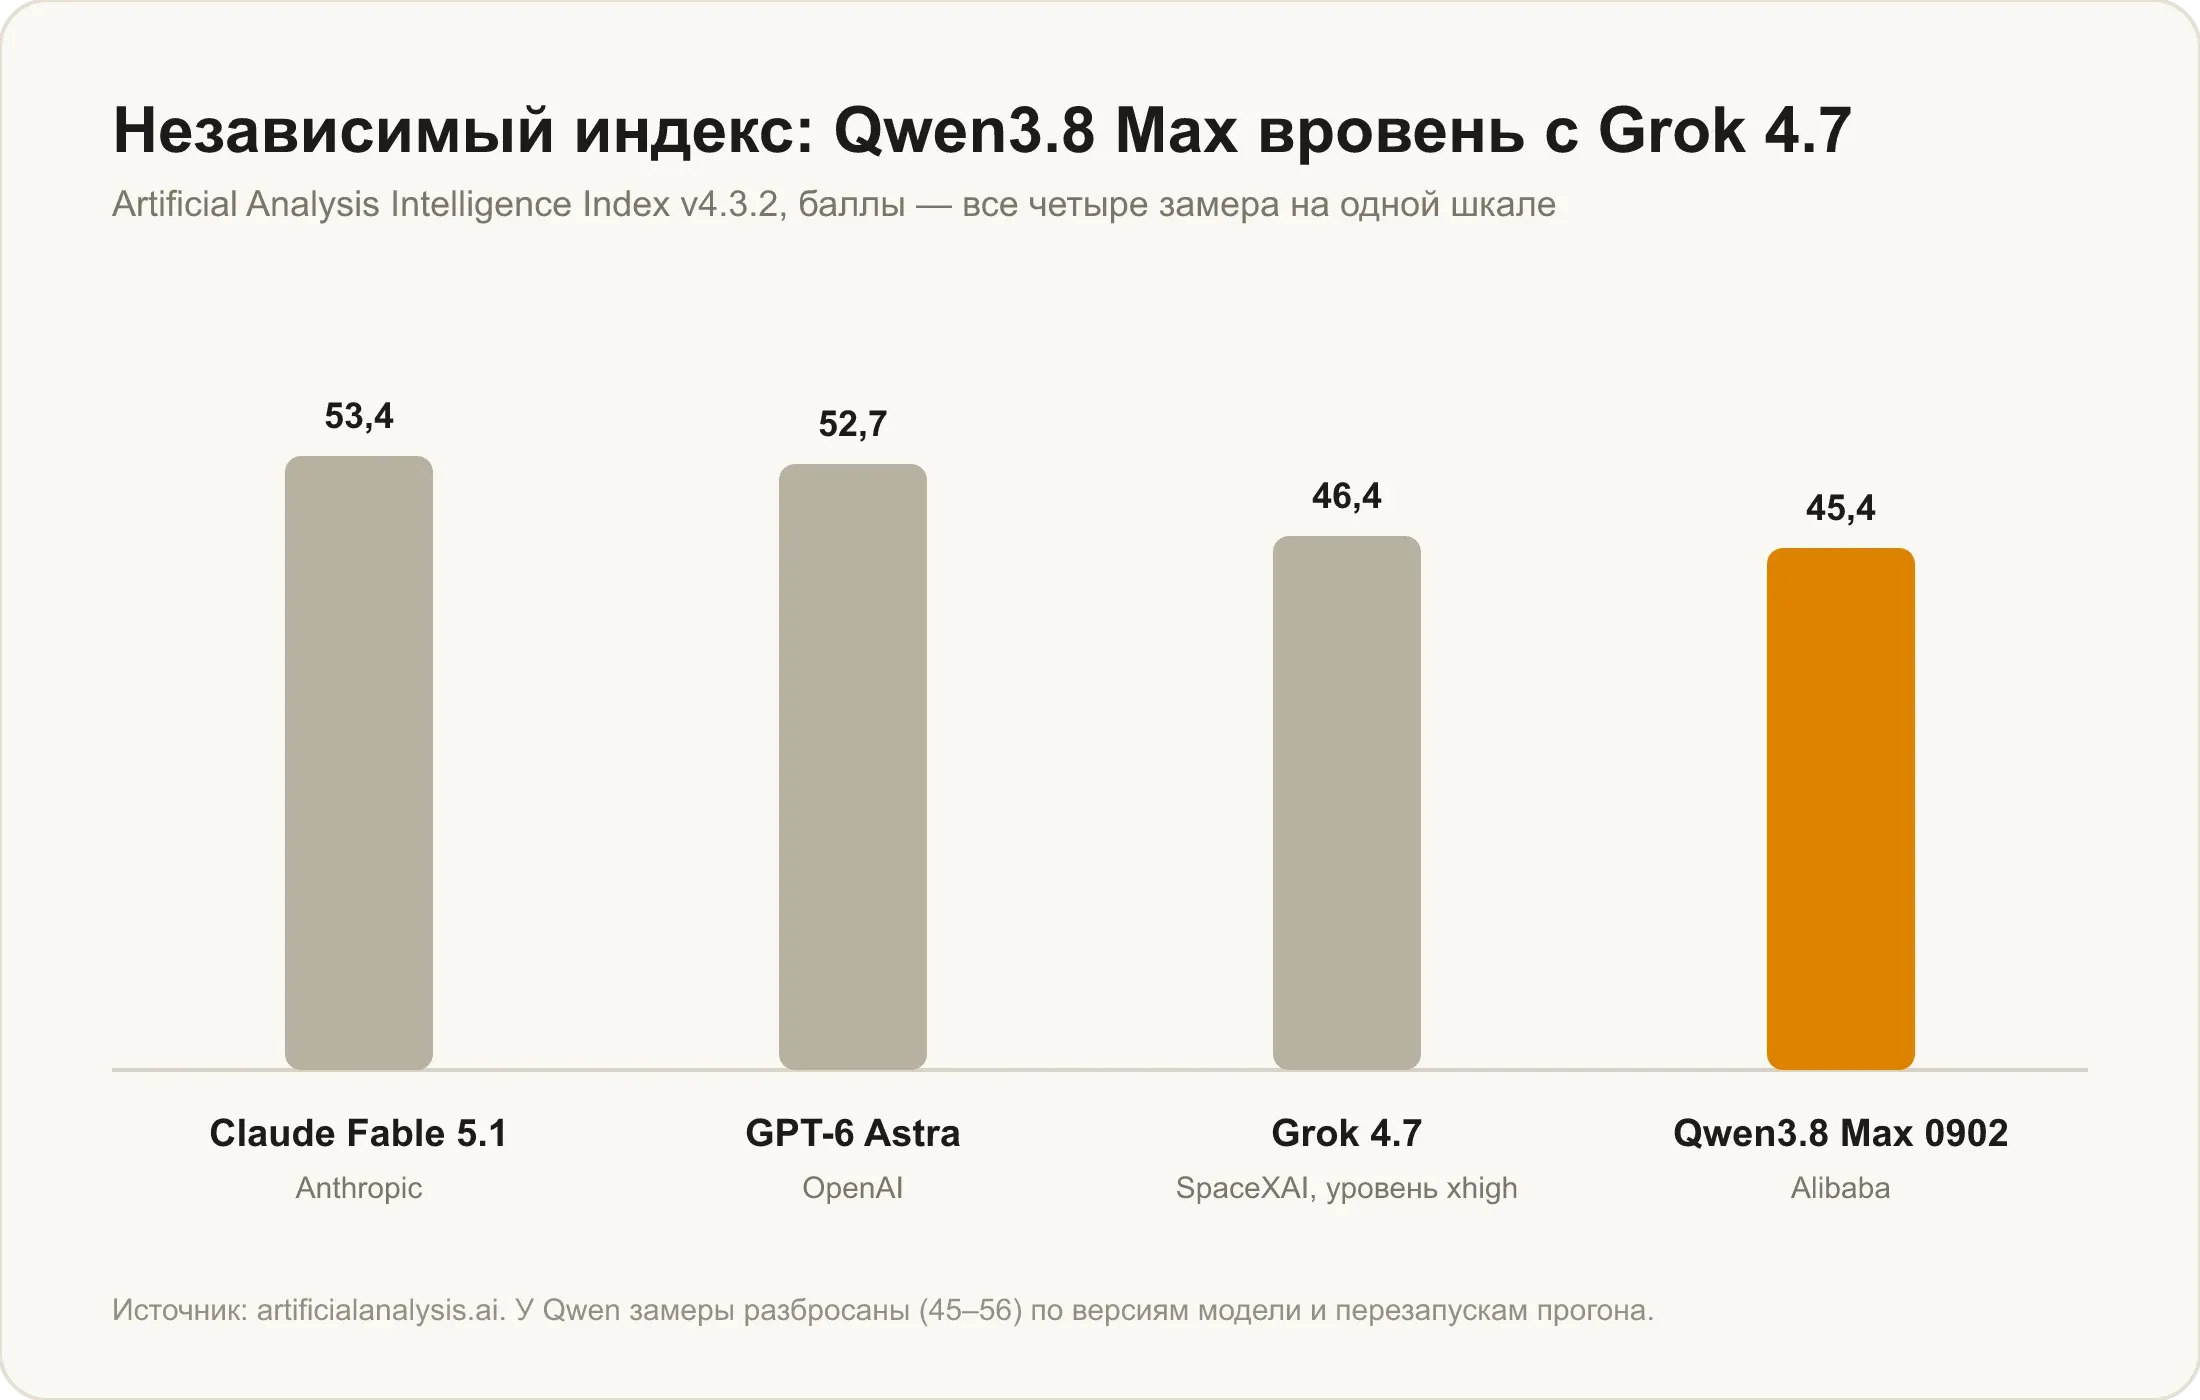
Тут нужна оговорка, без которой легко сделать ложный вывод. По обзорам ходит цифра «56 баллов», и она не ошибка: у этой модели замеры агрегатора разбросаны примерно от 45 до 56 в зависимости от версии модели и прогона, часть тестов перезапускали из-за проблем с эндпойнтом. Плюс сменилась сама шкала — индекс переехал на версию 4.3.2 с более тяжёлыми задачами, и баллы съехали вниз у всех моделей сразу. Так что одной цифрой Qwen 3.8 Max описывать рано. Историю со сменой шкалы мы разбирали в материале про Grok 4.7.
Все цифры в статье актуальны на 22 сентября 2026 года.
И последнее про достоверность цифр. Вся августовская таблица бенчмарков прогонялась самой Alibaba, независимого воспроизведения нет. Сторонних замеров два: Code Arena и индекс Artificial Analysis. Читать таблицу разработчика как факт не стоит ни у китайской компании, ни у американской.
Для каких задач модель подходит, а для каких избыточна
Из цифр складывается довольно конкретная картина. Qwen 3.8 Max стоит брать под работу с документами и интерфейсами: разбор отчёта со сложной вёрсткой, вытаскивание данных из скана, агент, который сам кликает по программе и доводит цепочку до конца. Сюда же попадает видео на входе — пересказ записи совещания или поиск фрагмента в длинном ролике.
Агентная работа в коде после снапшота 0902 тоже в списке, особенно фронтенд: первое место в разделе WebDev на Code Arena — внешняя оценка, а не самоотчёт. Хотя на тяжёлых инженерных сценариях Claude Opus 5 всё ещё впереди на несколько пунктов.
Для короткого бытового вопроса модель избыточна: она медленная, и даже с выключенными рассуждениями ответ придёт не сразу. Там, где важна скорость, логичнее переключиться на модель полегче в том же чате.
Вопросы на эрудицию и задачи, где критична точность формы ответа, — не её сильная сторона. Последнее место по широким знаниям и худший балл по следованию инструкциям среди флагманов сами по себе не приговор, но подсказывают, что результат придётся перепроверять чаще обычного.
Как попробовать Qwen 3.8 Max в Veruna AI
Qwen 3.8 Max заведена в каталог моделей Veruna AI и открыта на подписке Pro и выше — актуальные условия смотрите на странице тарифов. Без VPN, оплата в рублях, подключение такое же, как к остальным моделям каталога. Про сам процесс доступа из России подробно — в статье как пользоваться Qwen 3.8 Max.
Смысл платформы не в отдельной модели, а в том, что их можно переключать в одном окне. Тяжёлую Qwen логично брать под разбор документа или многошаговую агентную работу, а на короткий вопрос переключаться на что-нибудь быстрое, не открывая второй сервис. Рядом в каталоге лежит Grok 4.7 того же ценового класса — удобно, если хочется прогнать одну задачу через обе и сравнить; такое сопоставление мы сделали в статье Qwen 3.8 Max против Grok 4.7.
Короткие сценарии
Разбор годового отчёта или многостраничного PDF со сложной вёрсткой — 92,1% на OmniDocBench 1.5 и контекст на миллион токенов без наценки за длину промпта.
Агент, работающий в интерфейсе программы, — 86,1% на OSWorld-Verified, лучший результат среди сопоставленных флагманов.
Задача по фронтенду с генерацией целого приложения — первое место в разделе WebDev на Code Arena, оценка внешней площадки, а не вендора.
Быстрый вопрос или разовая правка текста — здесь медленная выдача только добавит ожидания, разумнее взять модель полегче.
Частые вопросы
Что умеет Qwen 3.8 Max? Держит в контексте до миллиона токенов, читает текст, изображения и видео, вызывает функции, ищет в интернете и выполняет код. Сильная сторона — работа за компьютером и разбор документов со сложной вёрсткой, а после снапшота 0902 ещё и агентный код. Генерации картинок и видео у неё нет, на выходе только текст.
Для каких задач подходит квен 3.8? Для разбора документов и отчётов, для агентных сценариев, где модель сама работает в интерфейсе, и для задач по фронтенду. На коротких бытовых запросах её преимущества не проявляются, зато проявляется медленная выдача.
Умеет ли Qwen 3.8 Max работать с видео? Да, видео поддерживается на входе: по документации до 64 роликов за раз, суммарной длительностью примерно до двух часов. Ответ модель при этом возвращает только текстом.
Правда ли Qwen 3.8 Max лучше всех в коде? Нет. Первое место у неё только на лидерборде Code Arena в разделе WebDev. В сентябрьской таблице Claude Opus 5 остаётся впереди по терминалу (42,7% против 29,0%), правкам в коде (73,6% против 69,3%) и генерации кода по описанию (72,3% против 64,9%).
Где Qwen 3.8 Max слабее западных флагманов? В широкой эрудиции — 43,6% на Humanity's Last Exam, последнее место среди флагманов того периода. В следовании инструкциям — 82,8% на IFBench. И в скорости: 39,2 токена в секунду по замеру Artificial Analysis, 153-е место в их рейтинге по быстроте.