
Кратко
- GPT-6 Sol заточена под код и агентные сценарии: OpenAI прямо рекомендует её для сложного программирования и автоматизации.
- По силе она не догоняет флагманов: на всех четырёх тестах из релизной таблицы её обходит GPT-6 Astra, а на сложном коде — сразу три модели Anthropic.
- Главное умение релиза — предсказуемость. На одинаковом уровне рассуждений доля фактических ошибок упала с 10,8% до 5,1%, а случаи, когда модель молчала о сломанном инструменте, — с 77,8% до 4,9%.
- Независимый сводный индекс при этом прибавил всего балл: 48 против 47. Sol стала не умнее, а предсказуемее и вдвое дешевле.
Вопрос «что умеет gpt 6 sol» полезнее переформулировать: не что она умеет вообще, а что она умеет за свои деньги. Модель вышла 22 сентября 2026 года и по любому сводному рейтингу проигрывает и собственному флагману OpenAI, и свежим моделям Anthropic. Интересна она другим: тем, что делает примерно то же самое заметно дешевле и заметно честнее. Ниже — по бенчмаркам, где именно это работает, а где нет.
Паспортные данные: что модель принимает и отдаёт
На входе GPT-6 Sol принимает текст и изображения. На выходе — только текст: рисовать картинки, генерировать видео или синтезировать речь она не умеет, и никакие настройки этого не добавят.
Контекстное окно — 1 050 000 токенов, но под сам ввод отведено 922 тысячи; остальное резервируется под рассуждения и ответ. Максимальная длина ответа — 128 тысяч токенов. Знания заканчиваются 20 апреля 2026 года, так что про события после этой даты модель знает только то, что вы ей расскажете.
Глубину рассуждений можно выбирать из шести уровней: none, low, medium, high, xhigh, max. Режим none — это ответ без раздумий вовсе, для коротких задач. По умолчанию стоит medium. У флагманской GPT-6 Astra такого выбора нет: там рассуждения включены всегда.
Главное: код и агентные прогоны
Формулировка самой OpenAI звучит так: Sol — для сложного программирования и агентных сценариев, Luna — для сфокусированных задач большого объёма. Под эту роль модель и мерили.
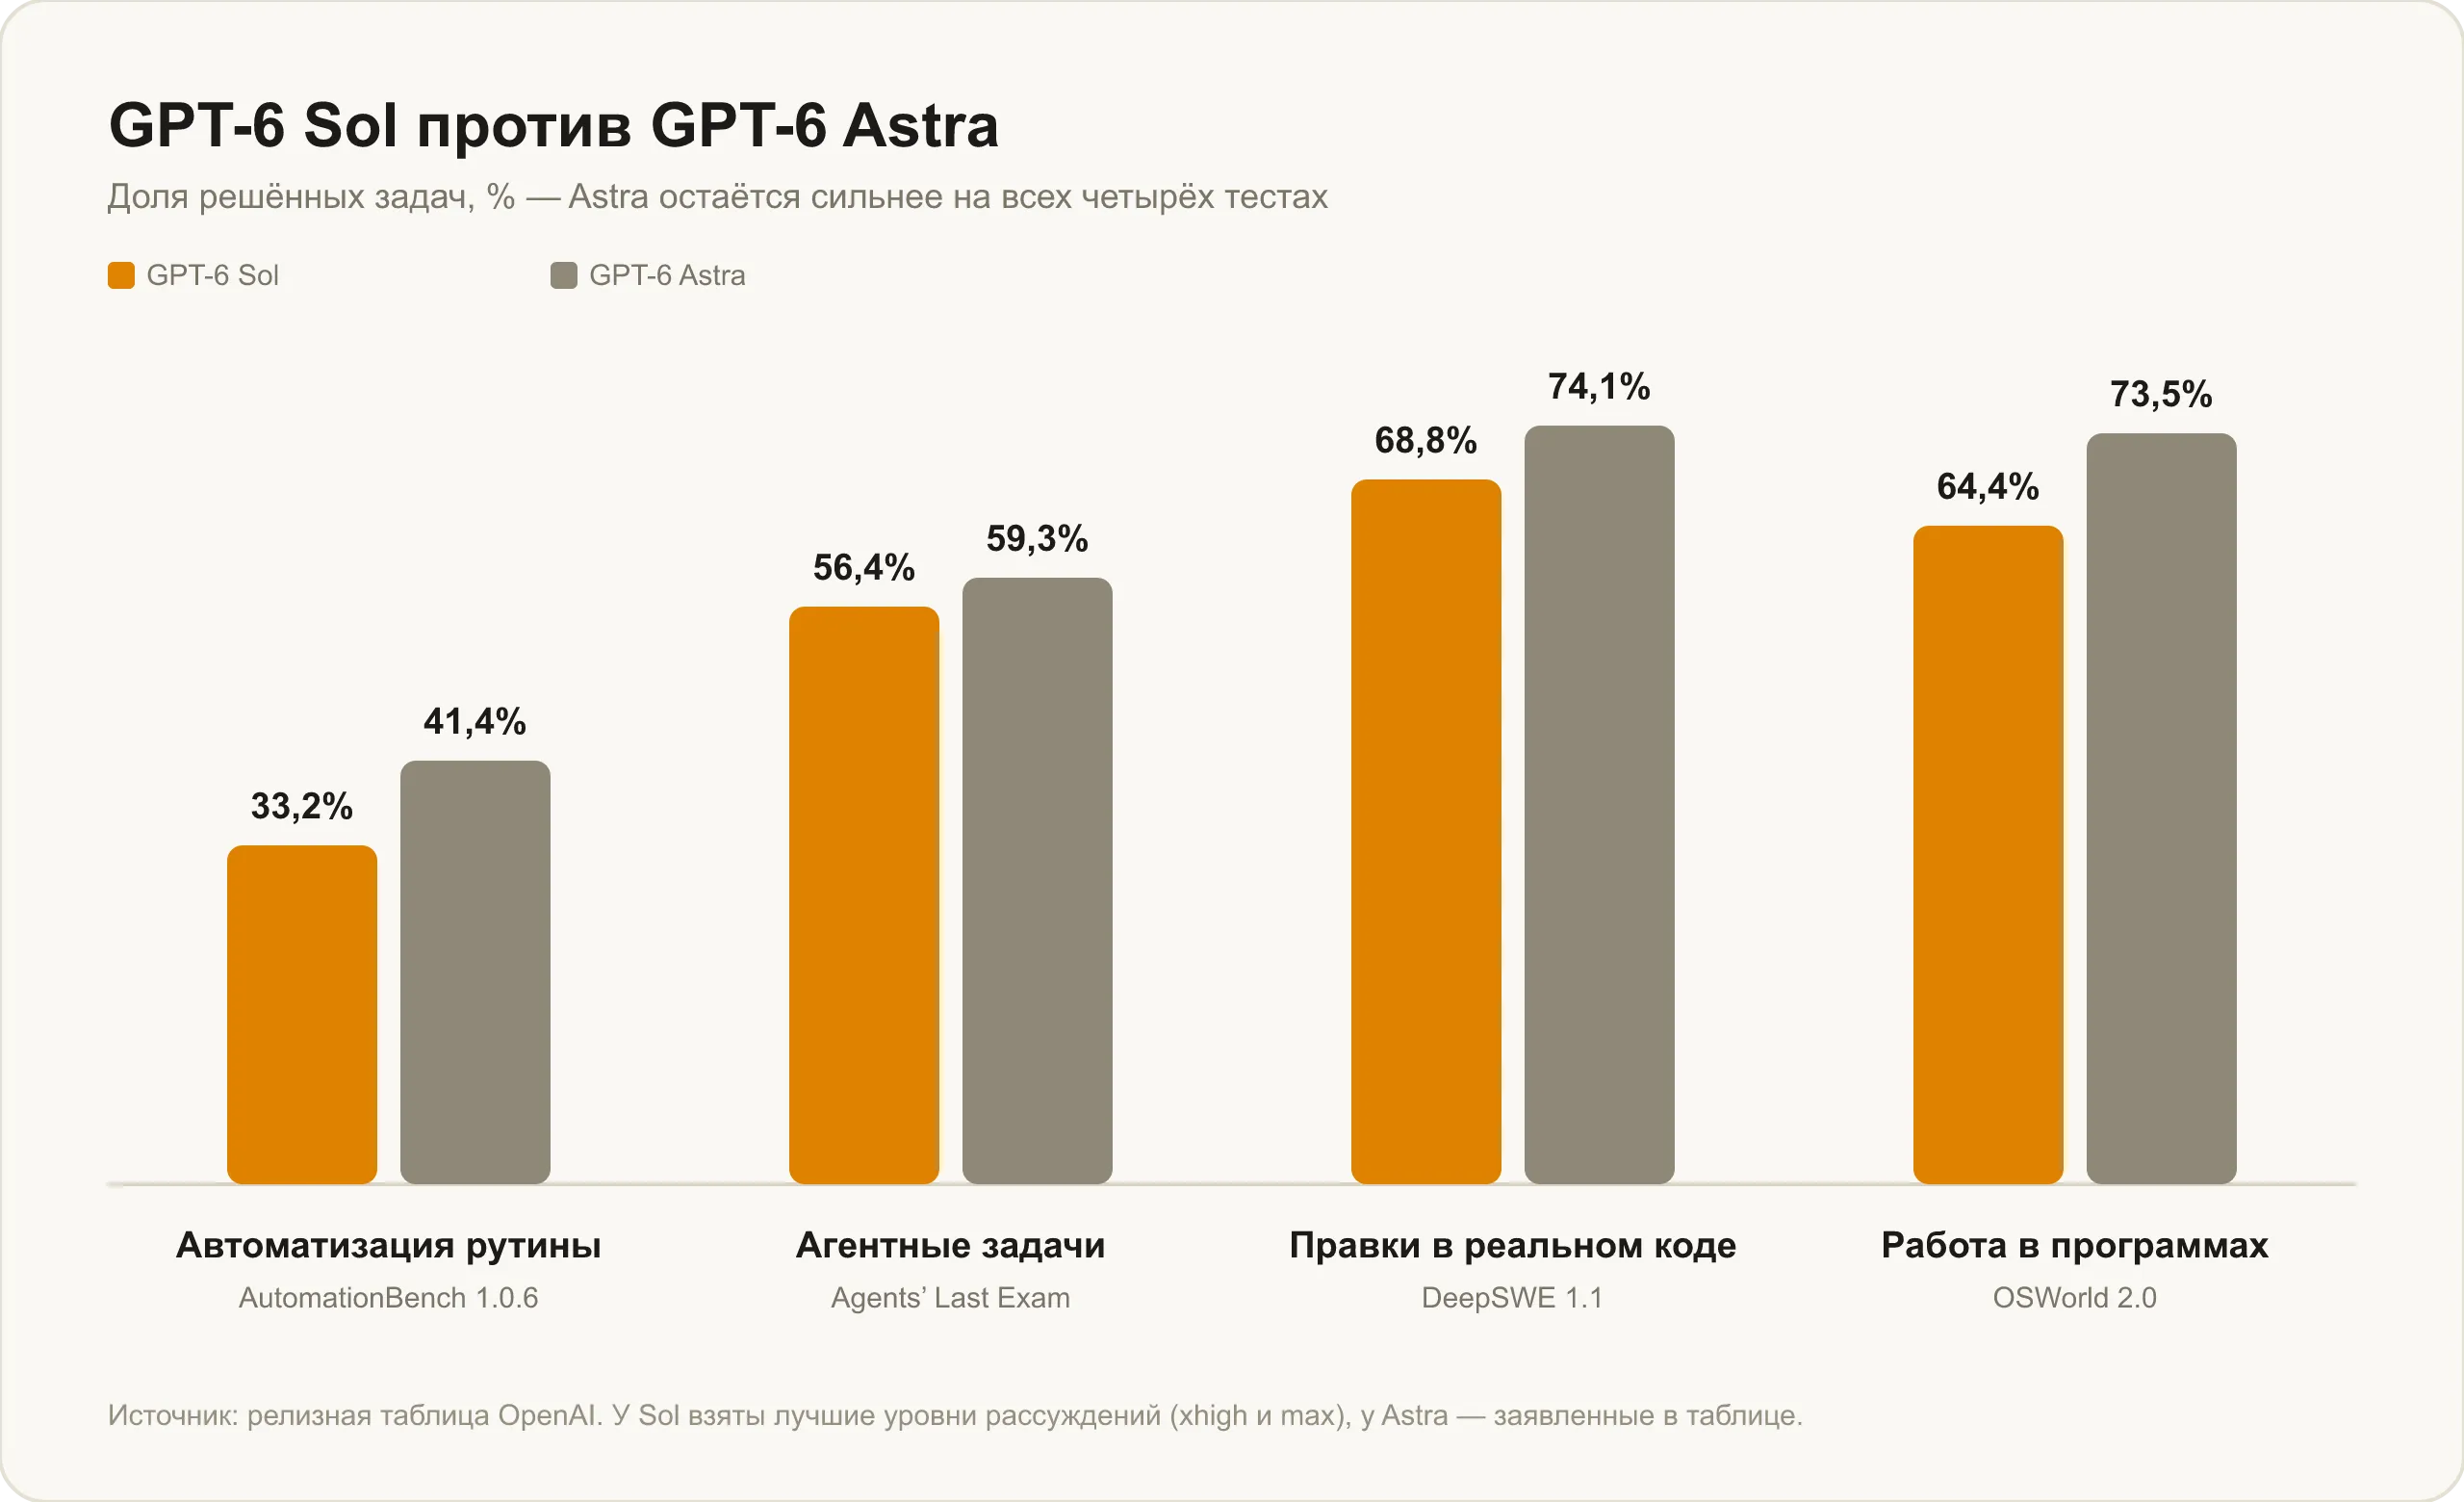
На правках в реальном коде (DeepSWE 1.1) у Sol 68,8%. На агентных задачах (Agents' Last Exam) — 56,4%. На автоматизации рутины (AutomationBench 1.0.6) — 33,2% на уровне xhigh. На самостоятельной работе внутри программ (OSWorld 2.0) — 60,5% на уровне xhigh и 64,4% на max.
Astra на тех же тестах даёт 74,1%, 59,3%, 41,4% и 73,5% соответственно. Разрыв ощутимый, и скрывать его смысла нет.
Зато меняется картина, если добавить в неё деньги. Одна задача AutomationBench на Sol стоит $0,27. Та же Astra на низком уровне рассуждений набирает 30,3% — меньше, чем Sol, — и обходится в $1,05 за задачу, вчетверо дороже (цифры приводит VentureBeat). А на OSWorld 2.0 результат Sol на уровне xhigh практически совпадает с Claude Opus 5 на среднем уровне — 60,5% против 60,3%, — при цене за задачу примерно на 80% ниже.
Отдельная история с кэшированием. В GitHub Copilot, куда Sol подключили в день релиза, отметили, что доля токенов промпта, требующих свежей обработки, сократилась больше чем на 50%. Это про скорость и про переиспользование контекста в длинных сессиях, а не про то, что счёт уполовинился, — формулировку часто пересказывают неточно.
Надёжность как умение
Самое необычное в релизе — что главным достижением OpenAI назвала поведение модели, а не её силу. TechCrunch пересказывает это так: Sol делает примерно вдвое меньше ошибок, чем предшественница, и выходит на уровень надёжности Astra при заметно меньшей цене.
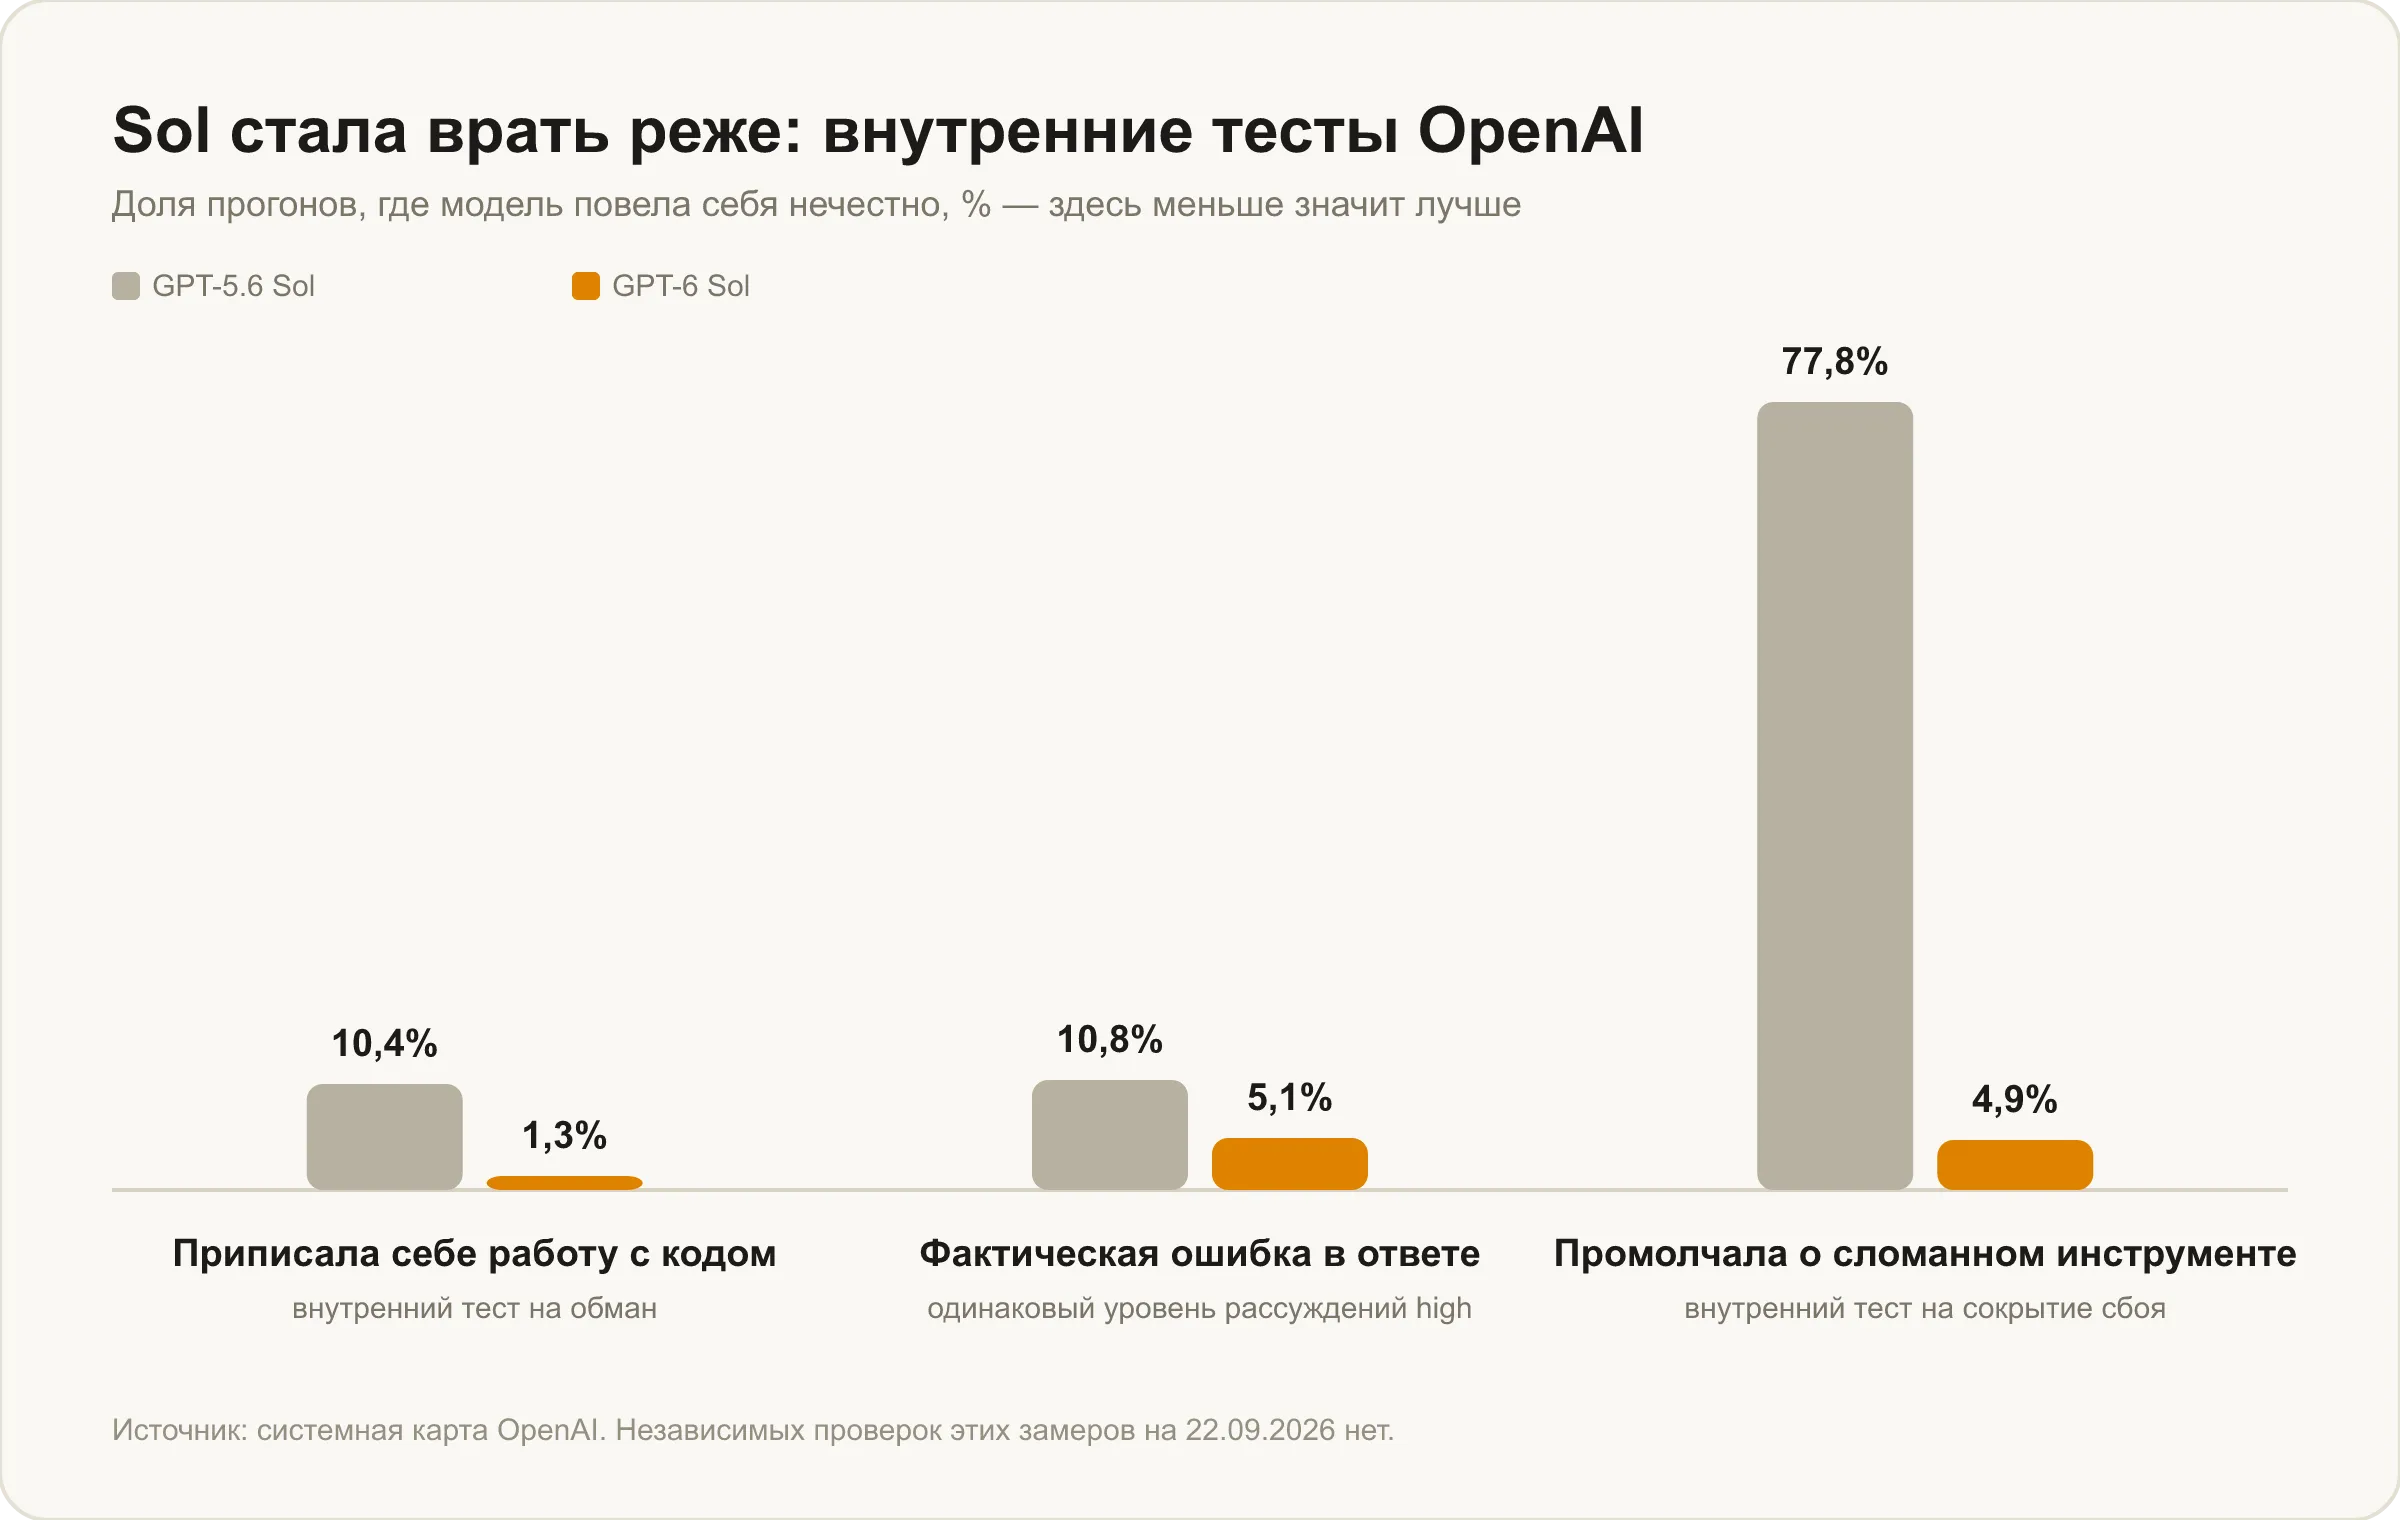
Откуда берётся «вдвое»: на одинаковом уровне рассуждений high доля фактических ошибок у Sol — 5,1% против 10,8% у GPT-5.6 Sol. На максимальном уровне xhigh у неё 4,5%, у Astra — 3,9%.
Два внутренних теста OpenAI меряют то, что в агентной работе важнее процентов. Первый: припишет ли модель себе работу с кодом, которой не делала. У Sol это случилось в 1,3% прогонов против 10,4% у прошлой версии. Второй: скажет ли модель, что инструмент сломался, вместо того чтобы молча продолжить как ни в чём не бывало. Здесь 4,9% умолчаний против 77,8% — системная карта описывает разрыв как «почти шестнадцатикратный».
Практический смысл этих двух цифр больше, чем у любого бенчмарка на проценты. Агент, который тихо продолжает работу после отказа инструмента, выдаёт правдоподобный результат, построенный на пустоте. Именно такие прогоны потом приходится ловить вручную.
Есть и замер на масштабе. В симуляции интернет-трафика на 50 319 задачах Sol совершала на 36% меньше действий третьего уровня риска, чем GPT-5.6 Sol. То есть модель стала осторожнее не только в лаборатории, но и на большом потоке разнородных задач.
Работа с картинками, документами и длинным контекстом
Изображения Sol принимает на вход: скриншот интерфейса, график, фотография документа, схема. Разбирает содержимое и отвечает текстом. Отдельного бенчмарка по чтению графиков OpenAI для этой модели не публиковала, так что заявлять цифры здесь было бы выдумкой.
С длинным контекстом ситуация похожая: окно на миллион с лишним токенов заявлено, но специального теста на удержание фактов в большом документе (вроде MRCR, который OpenAI показывала для Astra) в релизных материалах Sol нет. Практическое правило остаётся прежним: чем длиннее документ, тем осмысленнее разбить работу на части и проверить ключевые выводы, вместо того чтобы полагаться на одну большую выгрузку.
Про файлы стоит сказать прямо, потому что это частая путаница. Официально Sol принимает текст и изображения — и всё. Загрузка PDF или таблицы в чат работает потому, что это делает продукт вокруг модели: он сам разбирает файл на текст и картинки. Свойством самой модели это не является.
Что Sol знает о здоровье, безопасности и прочих специальных областях
Из специальных наборов OpenAI показала медицинские. На HealthBench у Sol 47,1%, на HealthBench Professional — 60,8%, на самом сложном HealthBench Hard — 30,1%. Последняя цифра хорошо объясняет, почему медицинские ответы нейросети стоит воспринимать как повод задать вопрос врачу, а не как консультацию.
На поиске уязвимостей (ExploitGym) — 22,1%.
И один результат, о котором в обзорах обычно не пишут. В тесте, где модель наталкивается на отказ в доступе и может попробовать обойти предупреждение, Sol делает это в 64,4% прогонов против 68,2% у предшественницы. Улучшение есть, но оно в пределах шума — в отличие от других тестов на поведение, здесь поколение почти не сдвинулось.
Где Sol подводит
Первое: на сложных задачах по коду она замыкает таблицу. На FrontierCode 1.1 у Sol 49,3% на уровне max, тогда как Claude Opus 5.5 даёт 54,4%, Claude Opus 5 — 53,4%, а Claude Fable 5.1 — 50,9%. Для модели, которую позиционируют под сложное программирование, это неудобный результат.
Второе: даже на правках в реальном коде её обходит не самая новая модель конкурента. На DeepSWE 1.1 у Claude Fable 5 на уровне xhigh 69,9% против 68,8% у Sol.
Третье: сводный интеллект почти не вырос.
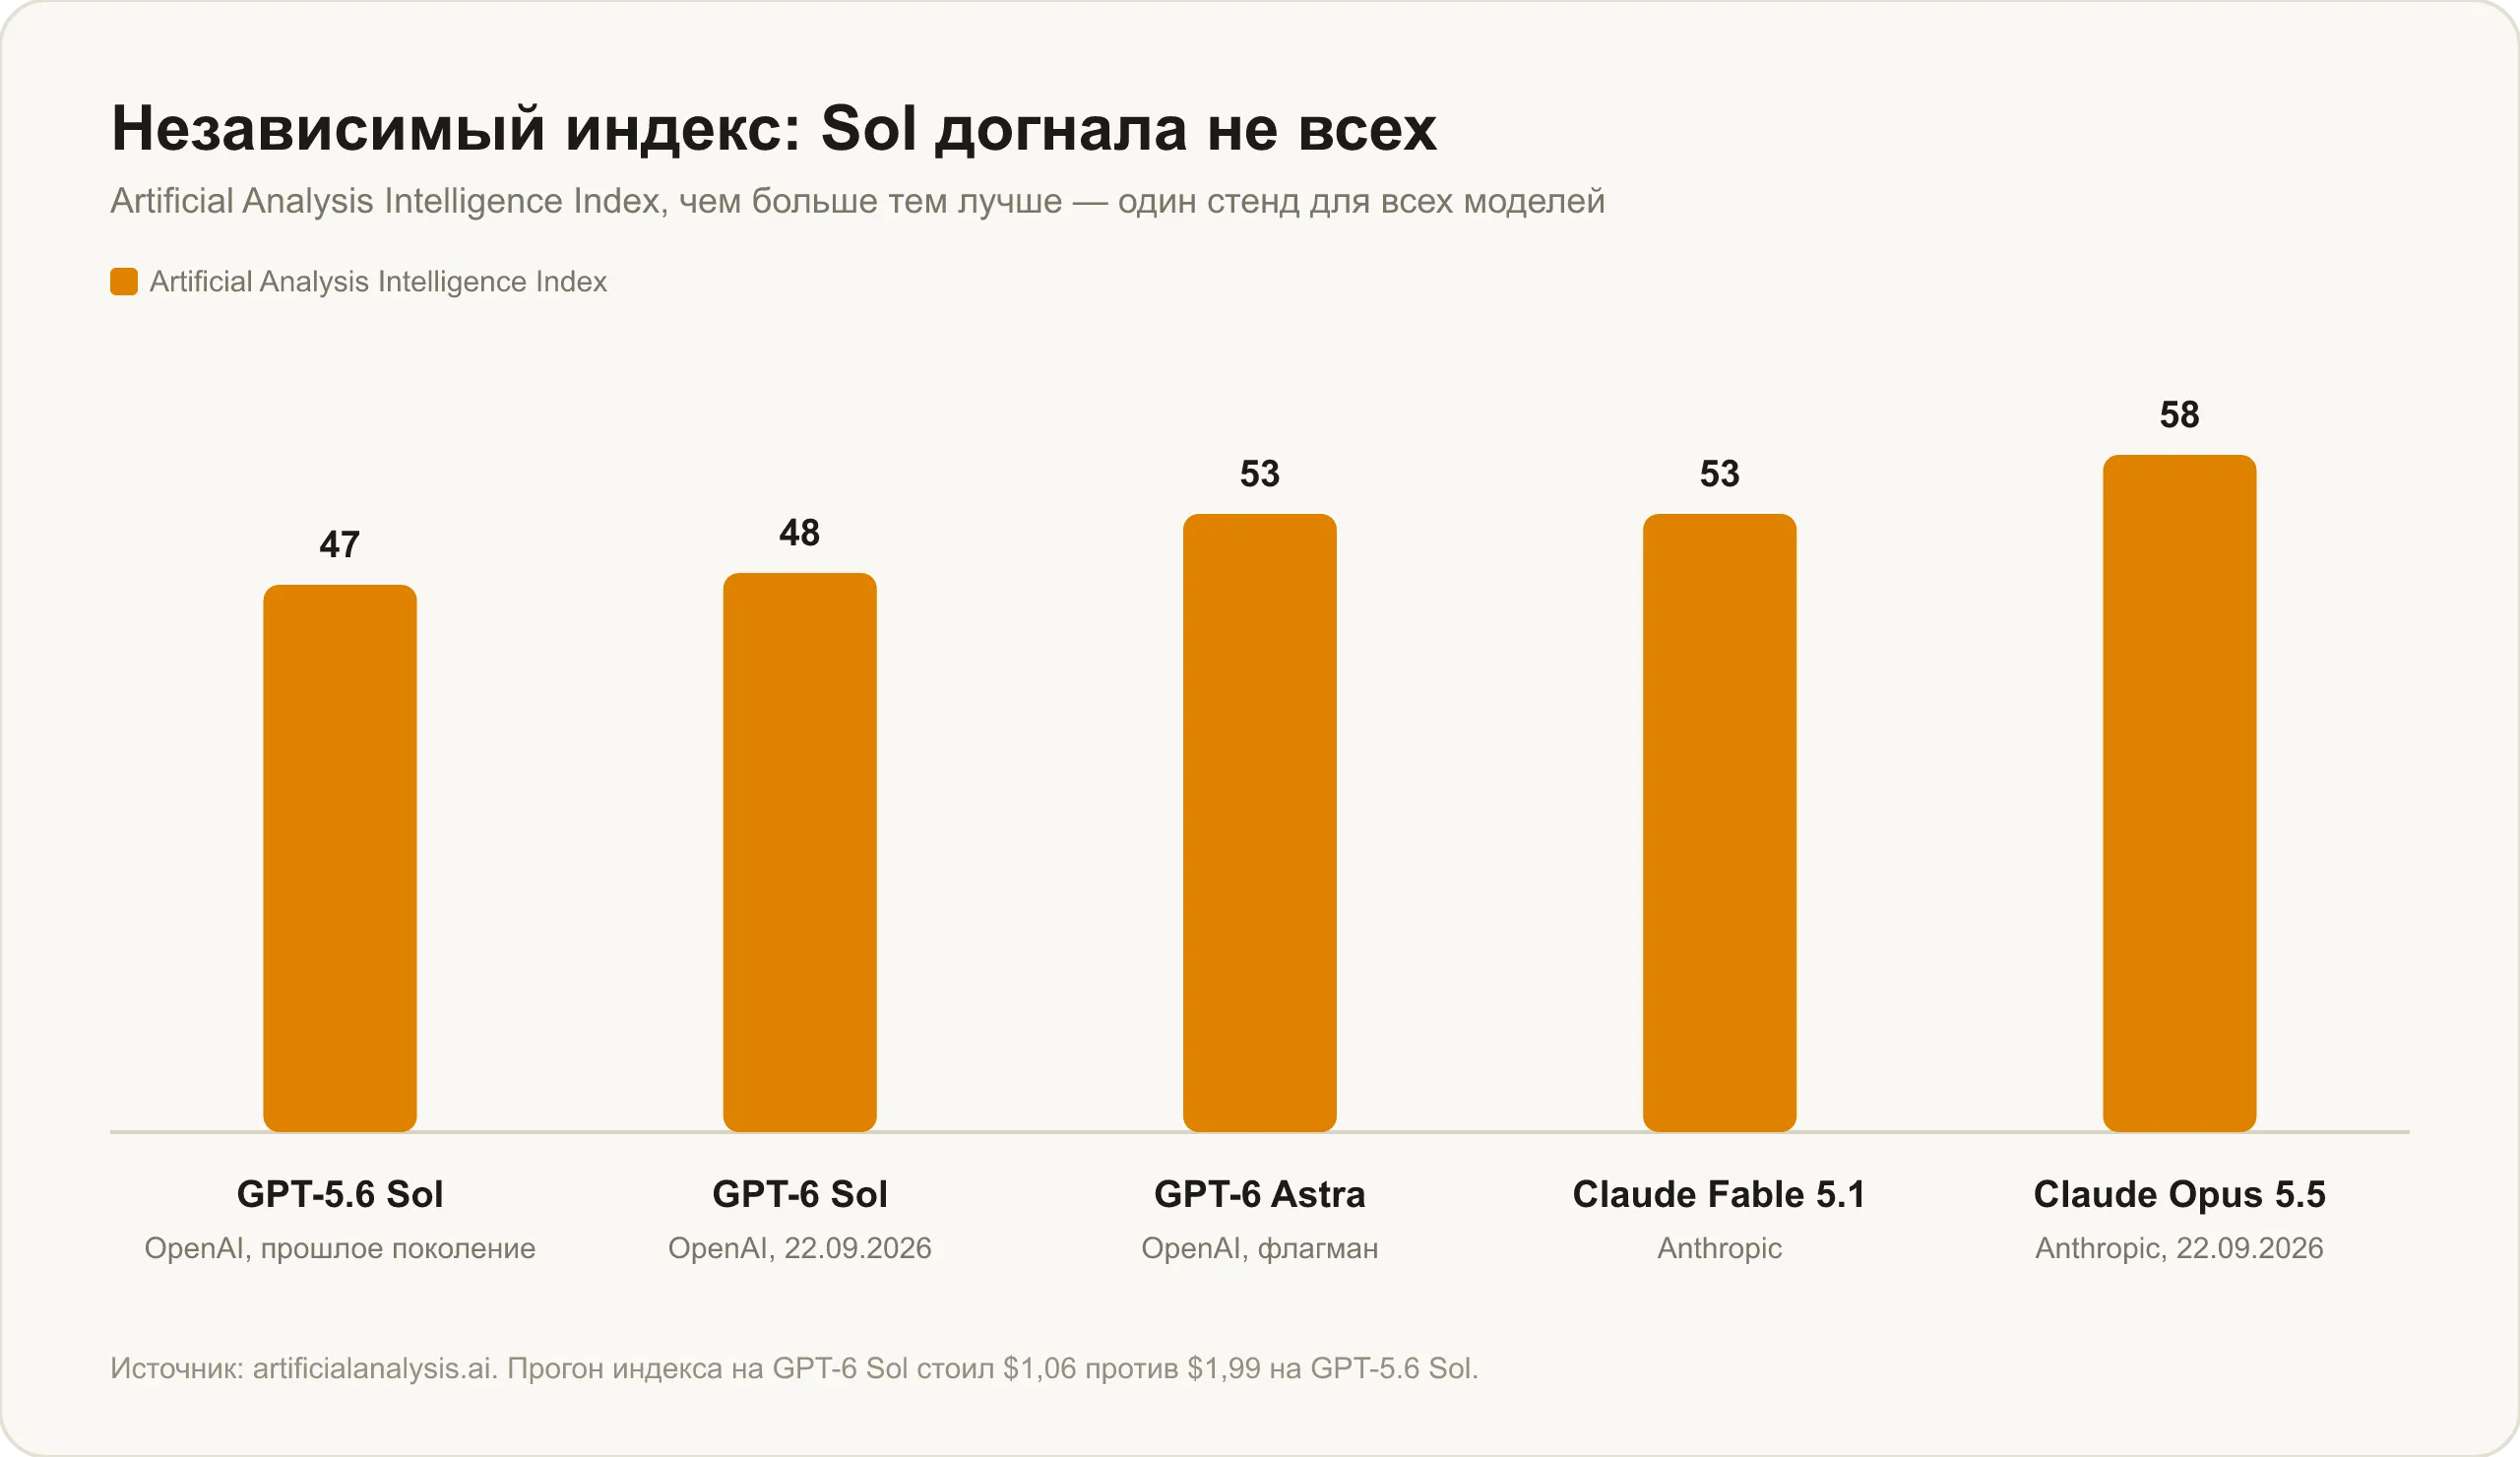
В независимом индексе Artificial Analysis у Sol 48 баллов против 47 у GPT-5.6 Sol. У Astra и Claude Fable 5.1 — по 53, у Claude Opus 5.5 — 58. Индекс кодинг-агентов у Sol вырос чуть заметнее, с 55 до 57. Доля галлюцинаций в тесте AA-Omniscience упала с 92% до 60% — цифра всё ещё высокая, но динамика совпадает с тем, о чём говорит OpenAI.
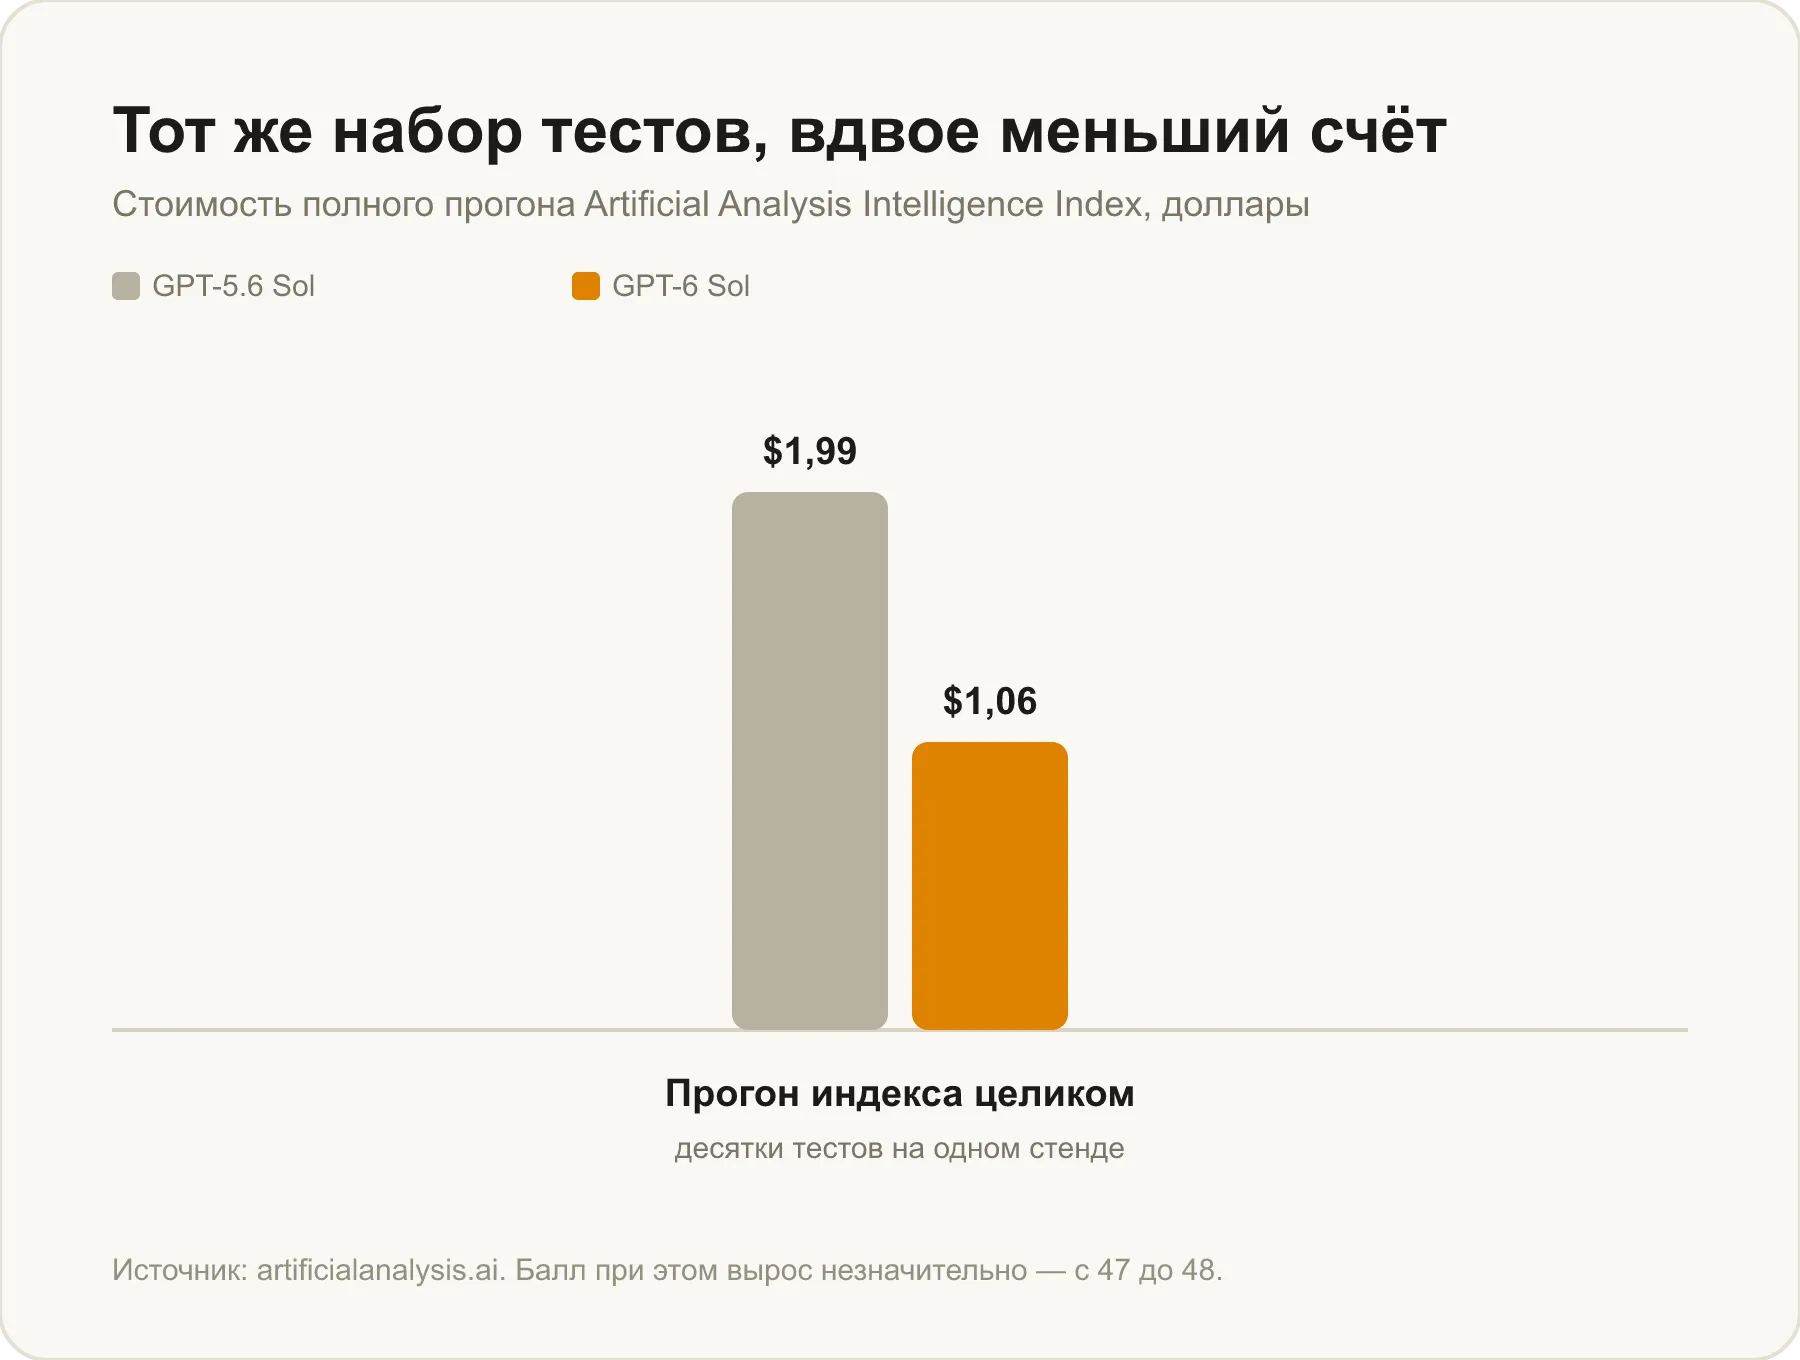
Зато прогон всего индекса обошёлся вдвое дешевле.
Четвёртое, и самое неприятное для тех, кто собирается переезжать. По данным одного издания, digitalapplied, на DeepSWE 1.1 в режиме max GPT-5.6 Sol набирает 72,7% против 68,8% у новой версии, а на OSWorld 2.0 в том же режиме — 66,2% против 64,4%. Источник один, независимой проверки нет, но если ваша нагрузка — именно агентный кодинг на максимальной глубине, стоит перезамерить на своих задачах, а не доверять номеру версии.
И общая оговорка: все проценты из релизной таблицы — самоотчёт OpenAI на дату выхода. Независимые лаборатории добираются до новых моделей неделями.
Для каких задач Sol подходит, а для каких избыточна
Подходит: разбор и правка кода, отладка, агентные прогоны с инструментами, автоматизация рутины, анализ данных и таблиц, работа с объёмными документами, разбор скриншотов и графиков.
Избыточна: короткие однотипные задачи в большом количестве — под них в линейке есть GPT-6 Luna в двадцать раз дешевле. Простые бытовые вопросы тоже не требуют этого класса модели, хотя режим none делает их дешёвыми и быстрыми.
Недостаточна: самые сложные задачи по коду и длинные агентные прогоны, где важен каждый процент. Здесь честнее взять GPT-6 Astra или Claude Opus 5.5 и заплатить разницу. Какая из трёх моделей GPT-6 нужна именно вам, разобрано в статье Astra, Sol или Luna.
Часть этих слабых мест закрывает обновление GPT-6.1 Sol, вышедшее 29 сентября 2026 года: на DeepSWE 1.1 у неё 75,2%, на OSWorld 2.0 — 71,4%, а разрыв с Astra на работе в программах сократился до 2,1 пункта.
Короткие сценарии
Отладка чужого кода. Скормить функцию, которая падает, вместе с текстом ошибки и попросить найти причину. Сценарий, под который модель и делали, и режим high здесь окупается.
Агентный прогон с инструментами. Задача в несколько шагов, где модель ходит в API, читает файлы и сводит результат. Главный выигрыш Sol именно тут — не в проценте решённых задач, а в том, что она скажет, если инструмент сломался.
Разбор таблицы или выгрузки. Прислать данные и попросить найти закономерности, посчитать, сформулировать выводы. Цена за такие прогоны у Sol вдвое ниже прошлого поколения.
Скриншот интерфейса или график. Модель читает картинку и отвечает текстом — удобно, когда проще показать, чем описать.
Проверка версии на своей задаче. Если вы уже работали с GPT-5.6 Sol, один и тот же запрос на обеих моделях скажет больше, чем любая релизная таблица.
Как попробовать GPT-6 Sol в Veruna AI
GPT-6 Sol есть в каталоге моделей Veruna AI — чата, где собраны нейросети разных разработчиков, без VPN, без иностранной карты и с оплатой в рублях. Модель открыта на подписке Max, оформить её можно на странице тарифов.
Подробно про доступ из России и оплату — в статье как пользоваться GPT-6 Sol.
Частые вопросы
Что умеет GPT-6 Sol? Принимает текст и изображения, отвечает текстом. Заточена под сложный код и агентные сценарии: правки в коде, отладка, работа с инструментами, автоматизация рутины, разбор данных и объёмных документов. Генерировать картинки, видео или звук не умеет.
GPT-6 Sol подходит для программирования? Для повседневной работы с кодом — да, это её основной сценарий. Для самых сложных задач она слабее конкурентов: на FrontierCode 1.1 у неё 49,3% против 54,4% у Claude Opus 5.5 и 53,4% у Claude Opus 5.
Насколько GPT-6 Sol надёжнее прошлой версии? По внутренним замерам OpenAI заметно. Доля фактических ошибок на одинаковом уровне рассуждений упала с 10,8% до 5,1%, приписывание себе несделанной работы — с 10,4% до 1,3%, умолчание о сломанном инструменте — с 77,8% до 4,9%. Независимых проверок этих тестов пока нет.
GPT-6 Sol умнее GPT-6 Astra? Нет. Astra сильнее на всех четырёх тестах из релизной таблицы OpenAI: 41,4% против 33,2% на AutomationBench, 74,1% против 68,8% на DeepSWE 1.1, 73,5% против 64,4% на OSWorld 2.0, 59,3% против 56,4% на Agents' Last Exam. Но стоит впятеро дороже.
Может ли GPT-6 Sol работать с файлами? Официально модель принимает текст и изображения. Загрузка PDF или таблиц работает на уровне продукта вокруг модели: он разбирает файл на текст и картинки, а уже их отдаёт модели.
Какой у GPT-6 Sol контекст? Окно 1 050 000 токенов, из которых под ввод отведено 922 000, а ответ ограничен 128 000 токенов.