
Кратко
- Главное умение Opus 5.5 — длинная самостоятельная работа в коде: на работе в терминале 66,4% против 52,3% у Opus 5, на правках в редакторе 57,8% против 46,6%.
- Фокус релиза не в потолке, а в настройках по умолчанию: по замерам Anthropic, на среднем уровне рассуждений модель повторяет или обходит Opus 5 на высоком, тратя меньше шагов и меньше токенов.
- Картинки она читает заметно точнее: на чтении графиков 89,0% против 83,4%, причём на самом низком уровне рассуждений точнее, чем Opus 5 на самом высоком.
- Слабое место задокументировала сама Anthropic: на длинной задаче модель склонна закончить ход отчётом о проделанном, и агент без присмотра на этом останавливается.
Что умеет Claude Opus 5.5 — или, как её уже ищут в рунете, «клод опус 5.5» и просто «опус 5.5» — за вычетом релизных формулировок? Смысл релиза в другом, чем «потолок стал выше»: то, ради чего на Opus 5 приходилось выкручивать рассуждения на максимум и платить за это токенами, Opus 5.5 делает на настройках из коробки. Ниже — цифры бенчмарков, отзывы ранних тестировщиков и раздел документации Anthropic, где компания перечисляет, что у модели идёт не так. Про дату выхода, прайс и характеристики мы писали отдельно в материале про релиз Claude Opus 5.5, здесь только про умения.
Паспортные данные: контекст, модальности, пределы
Контекстное окно Claude Opus 5.5 — 1 000 000 токенов, около 555 тысяч слов на текущем токенизаторе (паспорт модели в документации). Максимальная длина одного ответа — 128 000 токенов, через пакетный Batch API в бета-режиме до 300 000. Знания актуальны по июнь 2026 года. На входе модель принимает текст и изображения, на выходе выдаёт только текст.
Паспорт совпадает с предшественницей до цифры: то же окно, тот же предел ответа. Разница вся в поведении. Рассуждения у Opus 5.5 включены всегда и выключить их нельзя ни на каком уровне, а глубину задаёт один параметр — effort с пятью ступенями: low, medium, high, xhigh, max. По умолчанию стоит medium, тогда как у Opus 5 по умолчанию был high. Anthropic описывает назначение модели коротко: длительная агентная работа с кодом и умственный труд, где задача растягивается на много шагов.
Главное умение: длинная работа в коде
Нагляднее всего прирост виден там, где модель действует много шагов подряд, а не отвечает одним сообщением. По релизной таблице Anthropic, на работе в терминале (Terminal-Bench 4.0) Opus 5.5 набирает 66,4% против 52,3% у Opus 5. На сложных задачах по коду (FrontierCode v1.1) — 54,4% против 48,0%. На правках в редакторе кода (CursorBench 4.0) — 57,8% против 46,6%. В самостоятельной работе внутри программ (OSWorld 2.0) — 81,8% против 74,0%. В широкой эрудиции с инструментами (Humanity's Last Exam) — 67,7% против 63,6%.
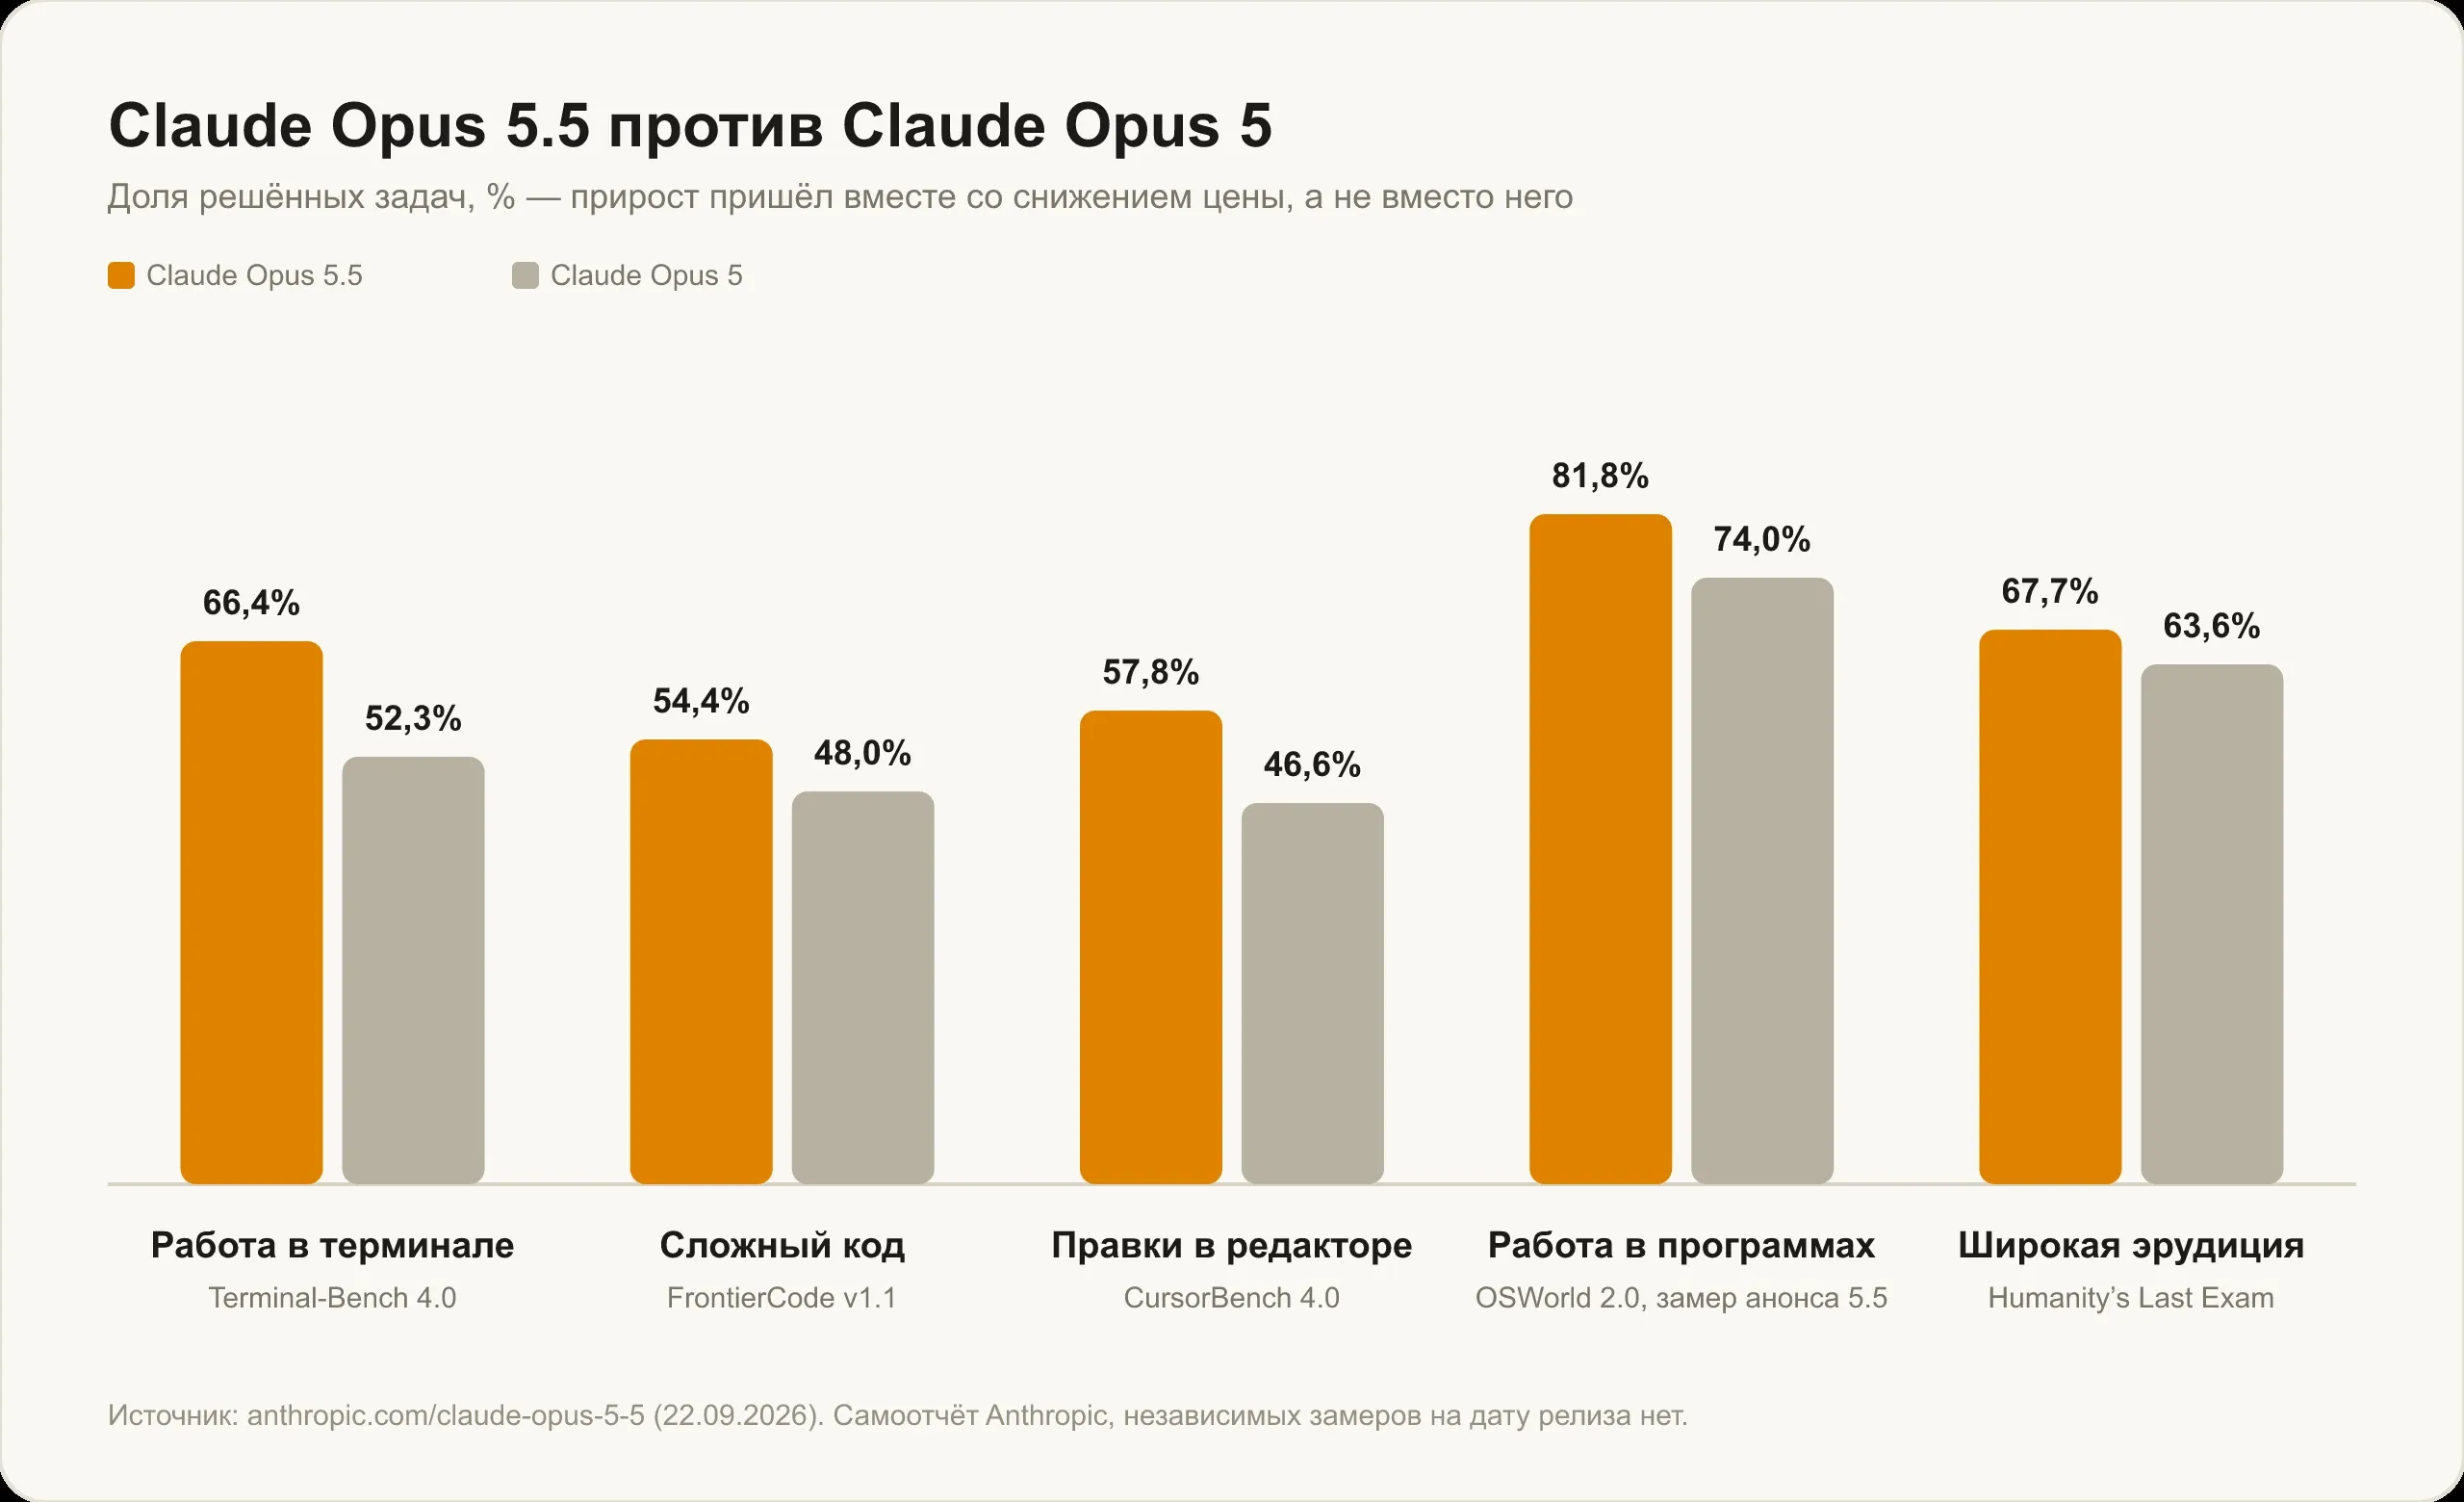
Если вы сверяете эти проценты с нашим разбором Opus 5, не пугайтесь расхождений. Тесты тут идут в версиях из релизной таблицы Opus 5.5 — CursorBench 4.0 и FrontierCode v1.1 вместо 3.2.0 и Main, а OSWorld 2.0 в этом прогоне даёт Opus 5 74,0% вместо 70,2% в обычном режиме её собственного релиза. Это разные прогоны одного теста, а не исправленные цифры.
В руководстве по промптам Anthropic формулирует прирост не через проценты, а через настройки: на своём тестировании модель на уровне medium повторяла или обходила Opus 5 на уровне high — при меньшем числе шагов и меньшем расходе токенов. На части задач по коду к этому результату подбирается даже low. На практике одинаковое качество теперь стоит дешевле по двум причинам сразу: упал прайс и модель меньше думает ради того же ответа.
Вторая часть того же сюжета — выносливость. Anthropic отдельно отмечает, что Opus 5.5 лучше предшественницы держится в многочасовых автономных прогонах: аудиты и миграции больших кодовых баз, запущенные от начала до конца с параллельными субагентами и почти без надзора. В анонсе Anthropic приводит и отзывы про ревью кода: багов находится больше, чем на Opus 5, ложных срабатываний меньше, а правки модель объясняет человеческим языком.
Opus 5.5 против Claude Fable 5.1: что показывает таблица
Отдельного разговора стоит сравнение с Claude Fable 5.1 — моделью, которая вышла тремя неделями раньше и стоит в два с половиной раза дороже. В релизной таблице Opus 5.5 обходит её на всех приведённых тестах: терминал — 66,4% против 55,8%, научные задачи в терминале (Terminal-Bench-Science 0.1) — 58,7% против 52,6%, автоматизация рутины (AutomationBench) — 40,0% против 31,4%, работа в программах — 81,8% против 80,7%, чтение графиков (Chartography) — 89,0% против 88,4%.
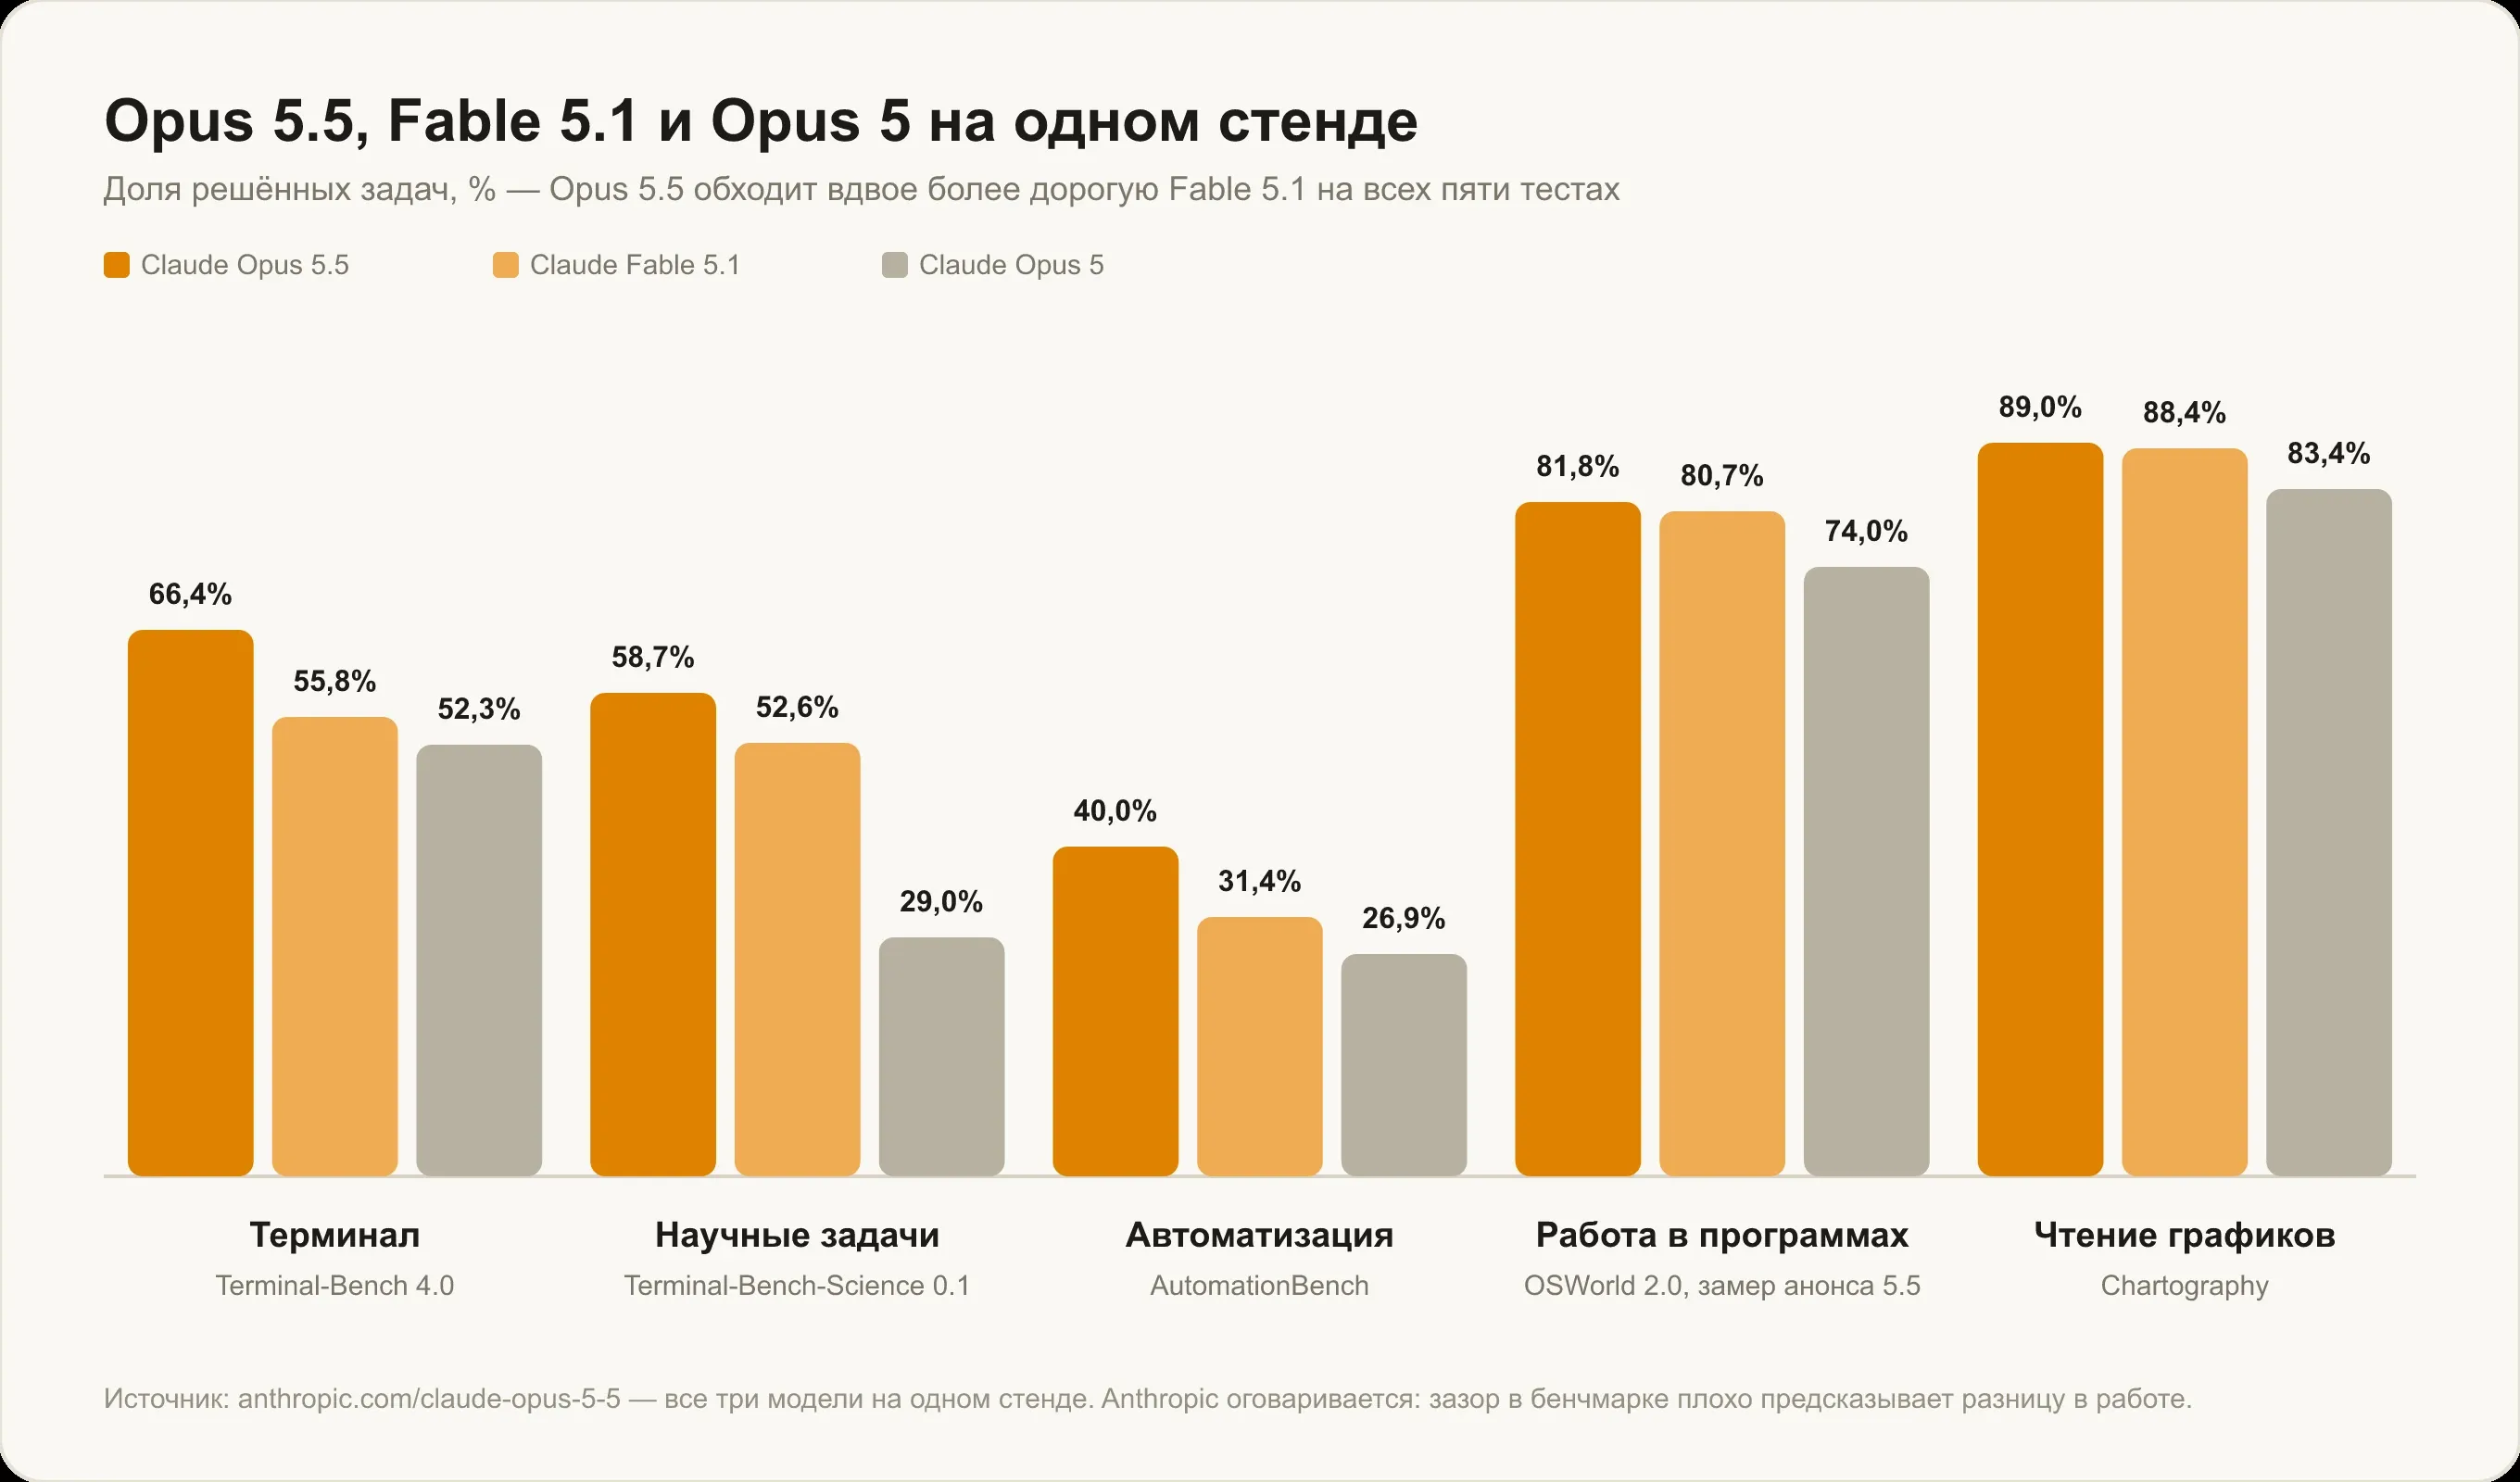
Тут нужна оговорка, которую сама Anthropic и делает. В собственной документации компания по-прежнему советует брать Fable 5.1 под самые требовательные рассуждения и долгие агентные прогоны — а ещё в случаях, когда Opus 5.5 даже на повышенном уровне не дотягивает на ваших задачах. То есть таблица не отменяет Fable: она показывает, что для большинства работы её потолок перестал быть обязательным. Как выглядела линейка до этого релиза, мы разбирали в сравнении Claude Opus 5 против Claude Fable 5.1.
Картинки, графики и работа в интерфейсах
Opus 5.5 читает визуальный материал точнее предшественницы без всякой дополнительной обвязки: на тесте по чтению графиков у неё 89,0% против 83,4% у Opus 5. Anthropic уточняет, что на её замерах модель даже на самом низком уровне рассуждений снимала значения с плотных диаграмм точнее, чем Opus 5 на самом высоком, и тратила на это малую долю выходных токенов.
Отдельно компания отмечает задачи, где смысл держится на расположении, а не на подписях: какие блоки соединяет стрелка на схеме, что изменилось между двумя версиями диаграммы, во сколько ровно начинается и заканчивается встреча на скриншоте календаря. Раньше под такое приходилось городить костыли — кропать картинку, подсовывать инструменты для зума. Теперь Anthropic прямо рекомендует перепроверить, нужна ли вам эта обвязка вообще.
Похожая история с действиями в интерфейсах программ. На том же тестировании Opus 5.5 на уровне по умолчанию давала ту же долю успешных прогонов, которой Opus 5 достигала только на заметно более высоком уровне. Плюс к этому — устойчивость к чужим командам: Anthropic называет Opus 5.5 самой стойкой к косвенным инъекциям промпта из всех моделей Opus, то есть к инструкциям, которые приезжают в модель через результаты инструментов, веб-страницы и содержимое экрана.
Умственный труд: цифры, документы, таблицы
Вторая заявленная область — не код. Формулировка Anthropic тут короткая: модель заметно реже называет неверную цифру и заметно реже ссылается не на тот источник. Сюда же — финансовое моделирование: собрать модель и страницу выводов по сделке, найти и исправить ошибки в чужом файле с оценкой.
Ещё одно умение, которое сложно померить бенчмарком, но легко узнать по работе: модель вылавливает мелочи в большом входе. Она замечает дату в длинной переписке, которая падает не на тот день недели, или график в презентации, который расходится с таблицей под ним. Anthropic добавляет, что таблицы, слайды и документы на выходе требуют меньше правок перед отправкой, — заявление проверяемое, и проверять его стоит на своих файлах.
Из отзывов ранних тестировщиков ярче всего цифра от команды CoCounsel: на исследовательских задачах модель выдавала 86,6% того, что команда ищет в ответе, против 60,3% у Opus 5.
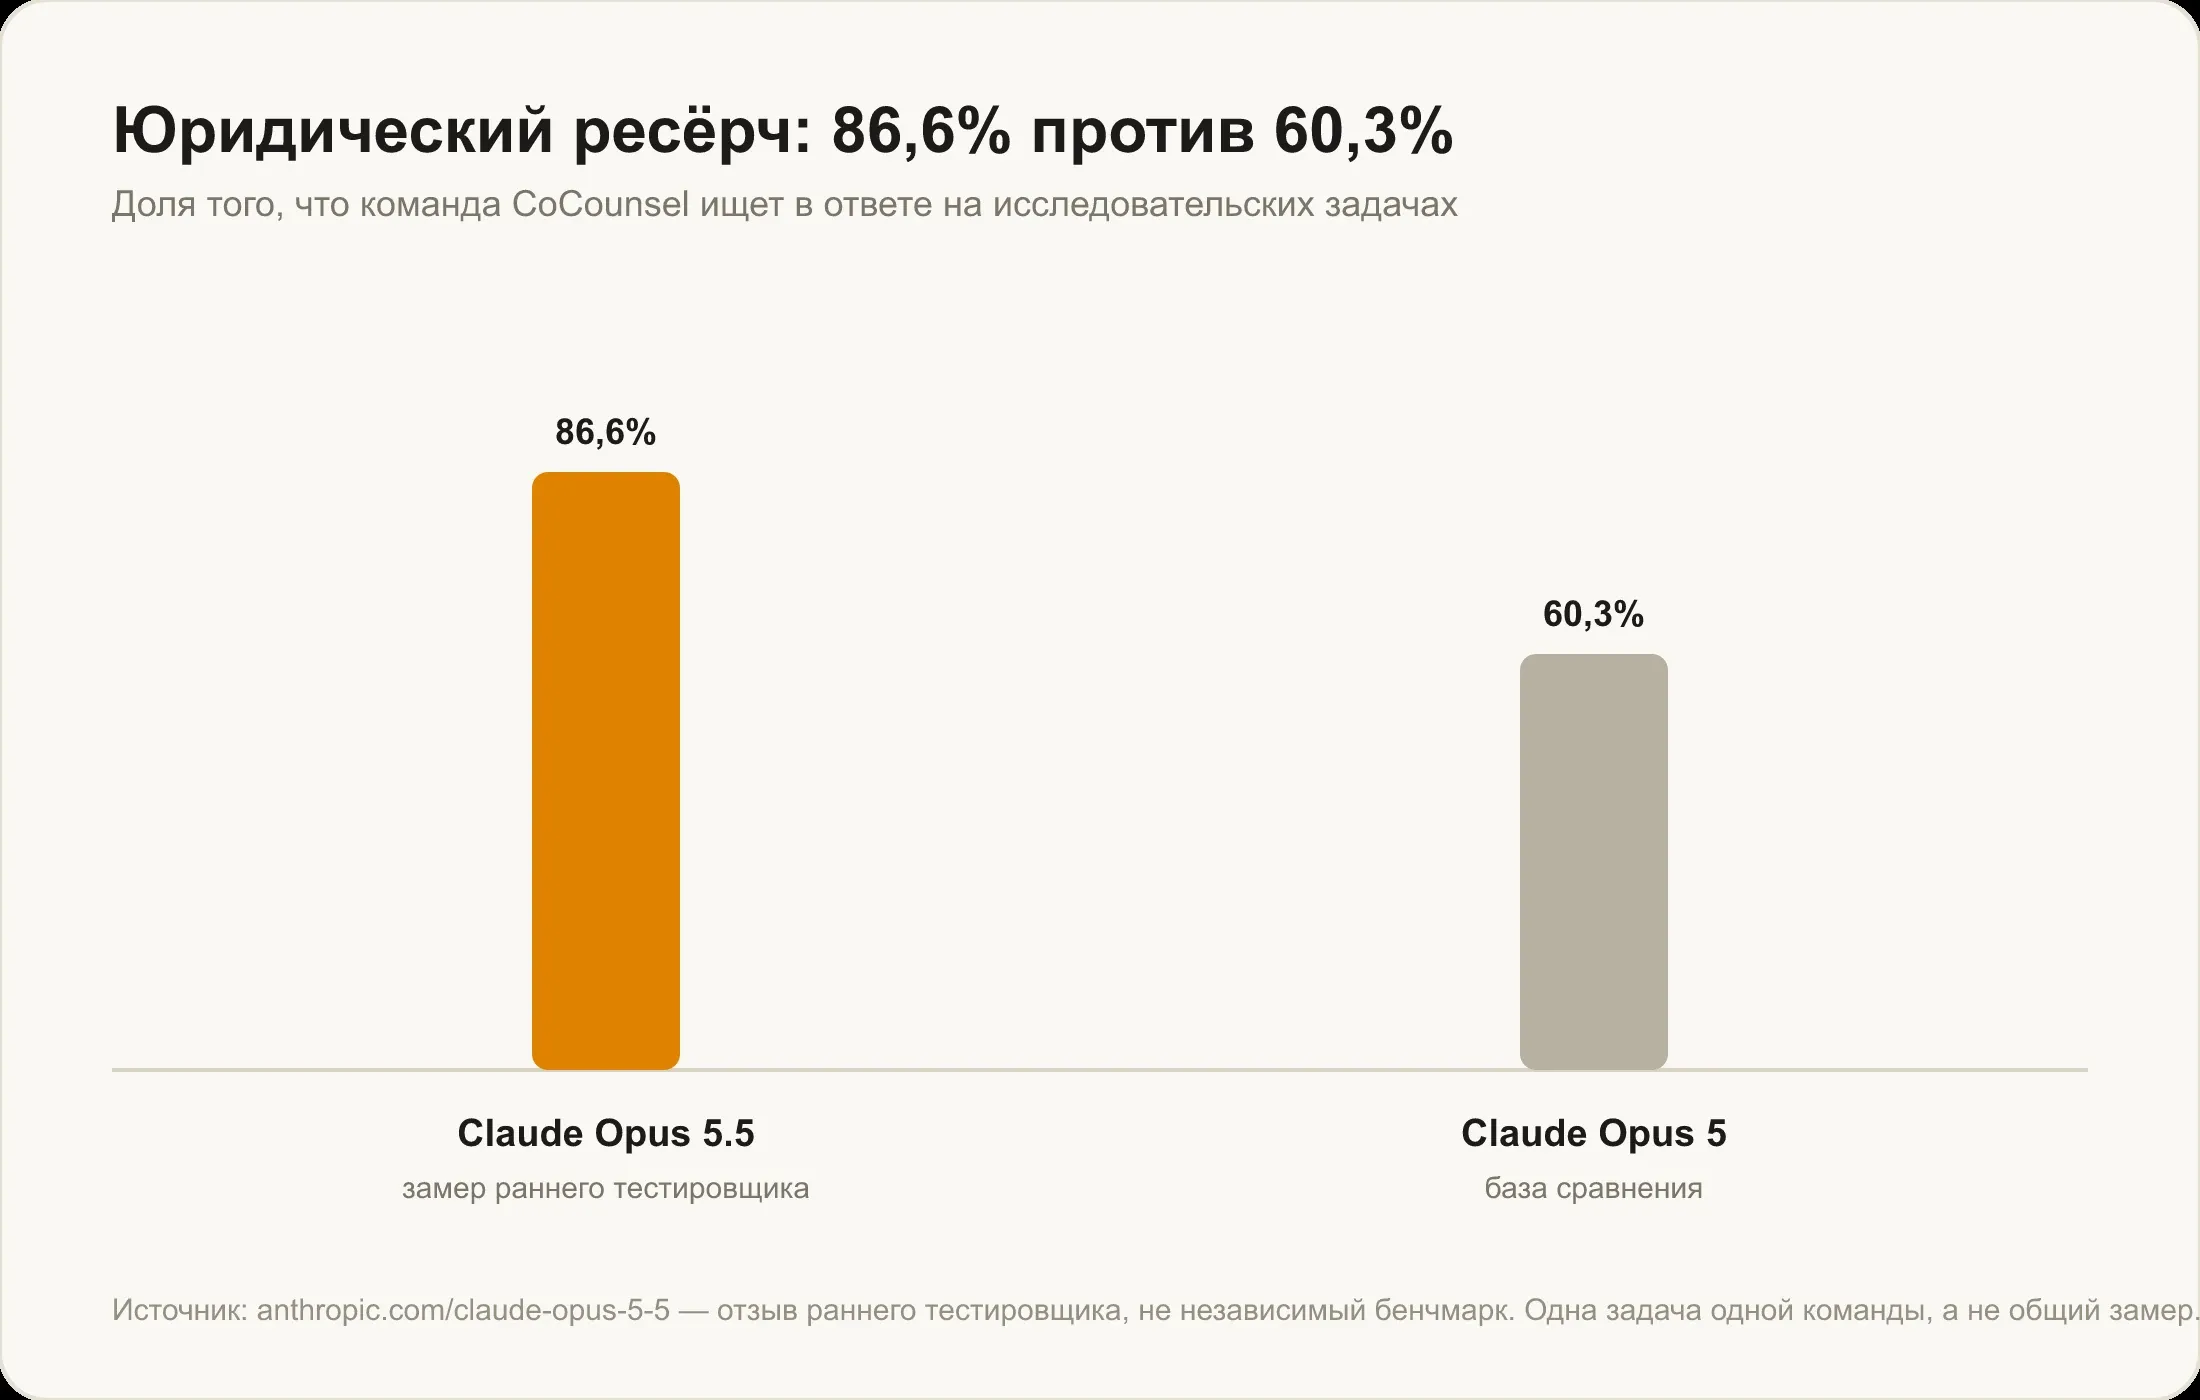
Это отзыв тестировщика, а не независимый бенчмарк: одна команда, свой набор задач, свой критерий «что мы ищем в ответе». Читать такое стоит как иллюстрацию, а не как замер.
Реальные задачи: что получилось у тестировщиков
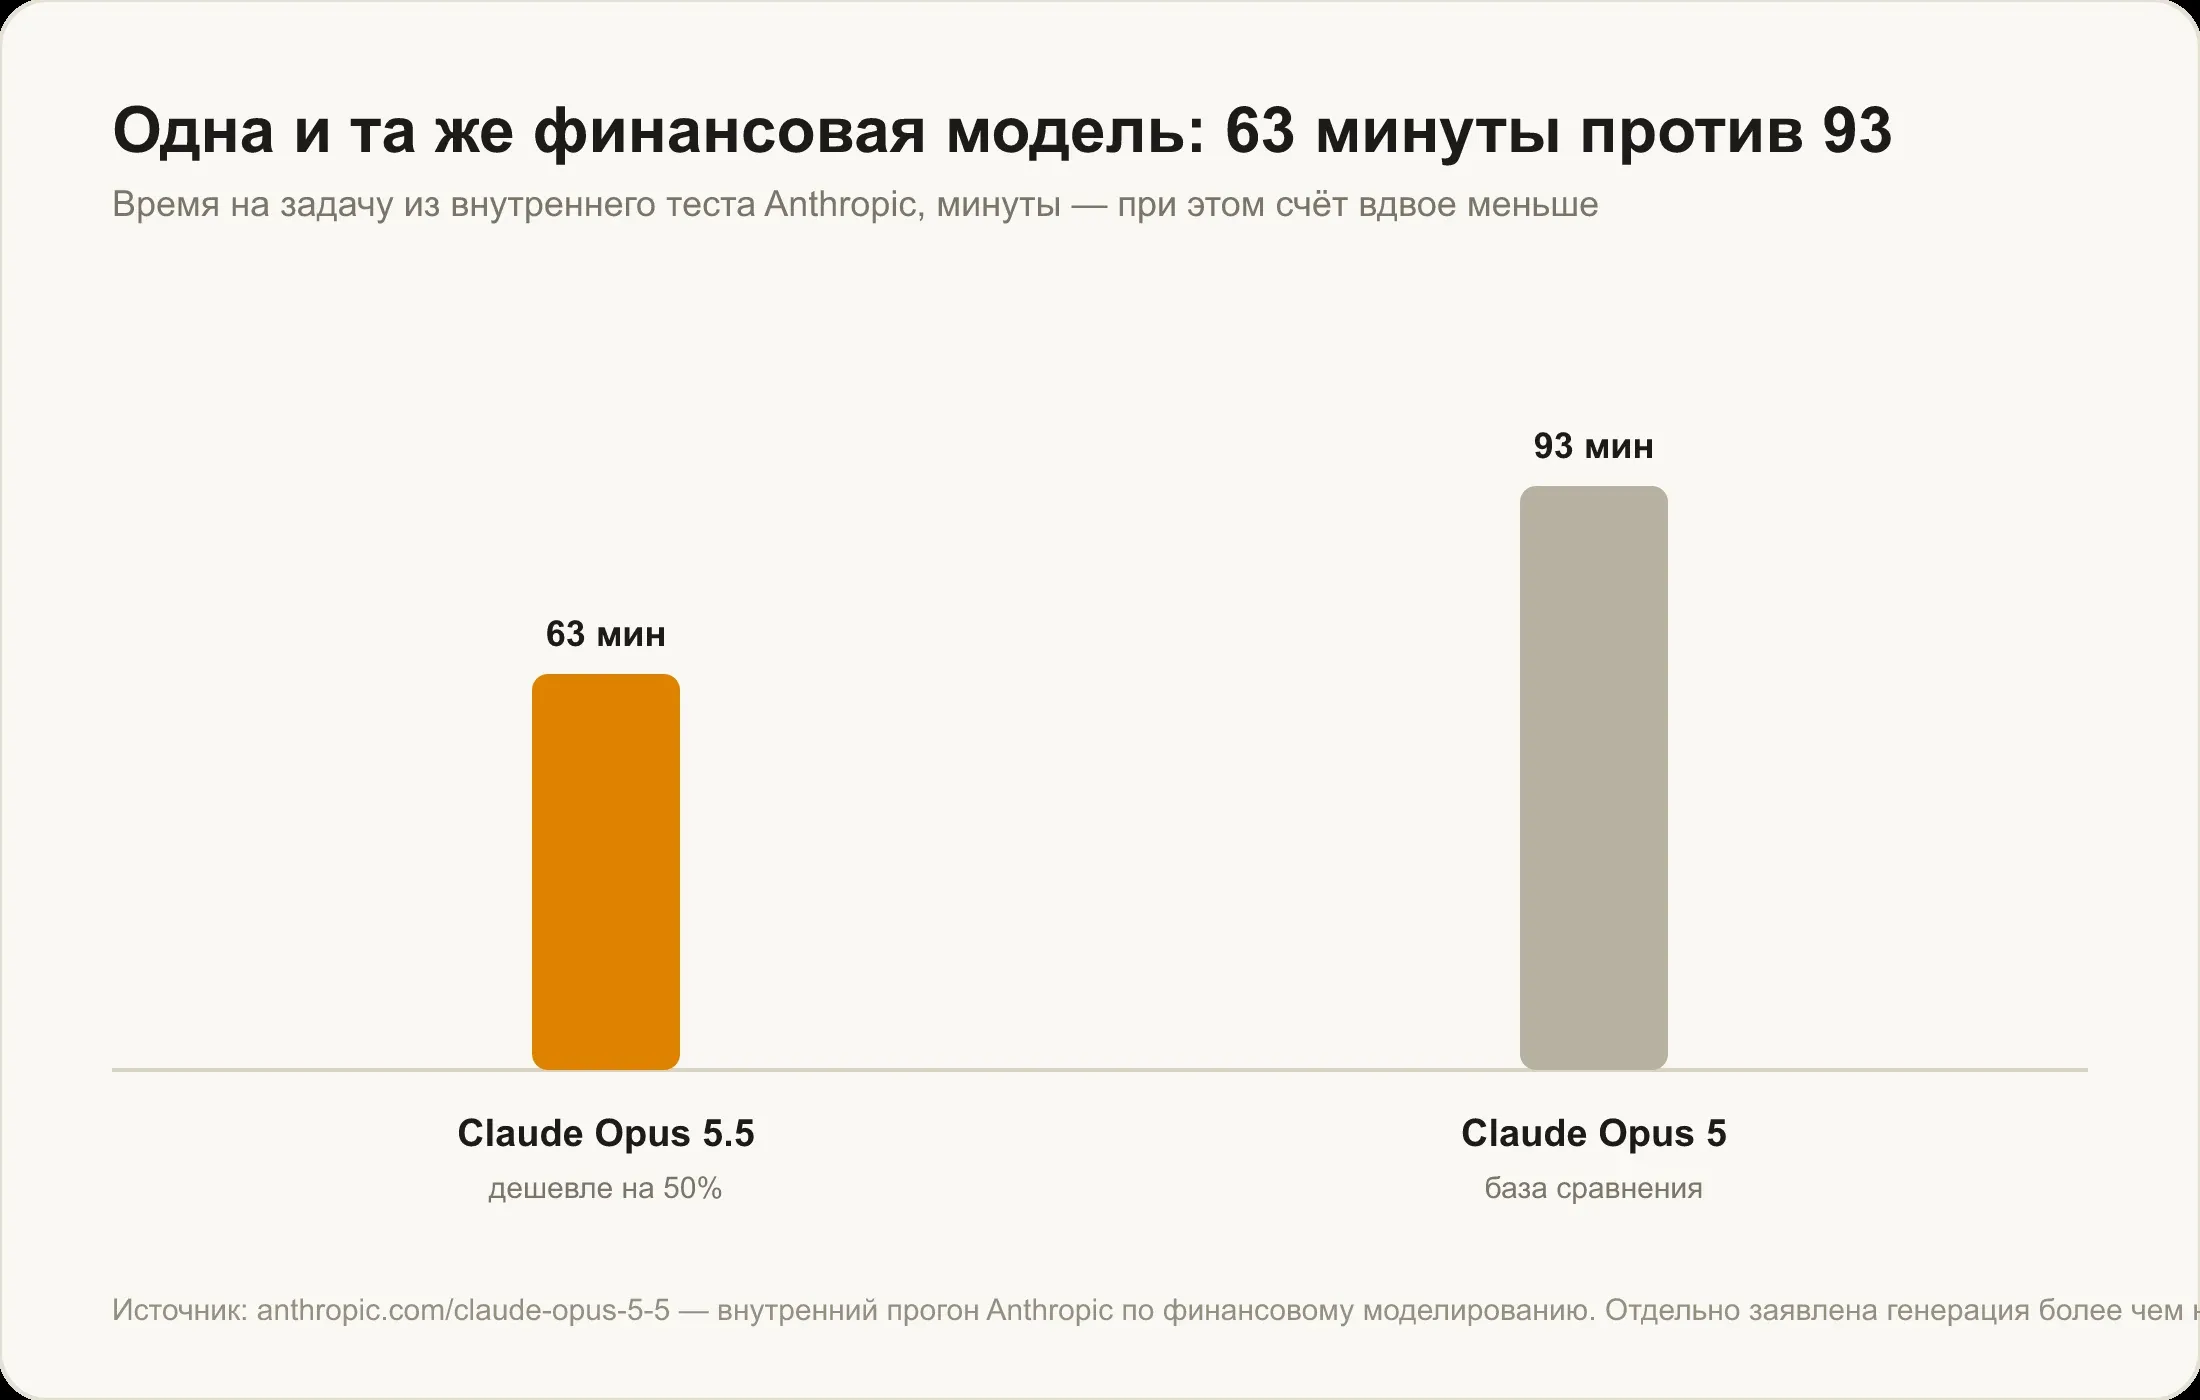
Anthropic собрала в анонсе несколько случаев из внутренних прогонов и от ранних пользователей. Кодовую базу на 680 тысяч строк мигрировали меньше чем за сутки. Проект на 200 тысяч строк модель проаудировала и починила меньше чем за три часа там, где Opus 5 потратила больше двадцати. Оптимизация веб-страницы удалась 39 раз из 40. Перевод конфигураций HAProxy за 9,5 часа против 12 у Fable 5.1 и на 51% дешевле по счёту. Финансовая модель по сделке слияния за 63 минуты против 93 у Opus 5 и вдвое дешевле. Генерация при этом, по заявлению компании, идёт более чем на 30% быстрее.
Все эти истории про одно умение: не бросать задачу на середине. К нему же относится и главная претензия к модели.
Где Opus 5.5 подводит
Независимых замеров на 22 сентября 2026 года, день выхода модели, нет: лаборатории вроде Vals AI и лидерборд DeepSWE добираются до новой модели неделями. Зато в документации по промптам есть раздел, где Anthropic сама перечисляет, что у модели идёт не так и что с этим делать.
Она останавливается, отчитавшись. На длинной задаче из нескольких частей Opus 5.5 держит пользователя в курсе и иногда заканчивает ход текстом, а не следующим действием. Человек в такой момент просто скажет «продолжай», а вот автоматический агент считает это концом задачи и встаёт. Anthropic советует держать список подзадач и пинать модель отдельным сообщением, если пункты остались открытыми, — то есть признаёт поведение как штатное.
На том же уровне она думает больше предшественницы. Особенно на xhigh и max. Если перенести конфигурацию с Opus 5 один в один, ходы станут длиннее, а выходных токенов — больше. Обещанная экономия относится к настройкам по умолчанию, а не к любому сценарию.
В диалоге она возвращается к уже сказанному. На следующих репликах, даже на коротком уточнении, модель иногда заново переосмысливает свой прошлый ответ, и отклик начинается позже. В документации для этого есть отдельная заплатка в системный промпт.
Фронтенд по умолчанию выглядит шаблонно. Без явного описания дизайна модель сваливается в несколько заученных стилей, а общая просьба «не делай как нейросеть» просто меняет один шаблон на другой. Помогает только перечисление конкретных приёмов, которых не надо.
Появились новые отказы. К прежним фильтрам добавились биология и «извлечение рассуждений»: запрос, который заставляет модель выписать ход своих мыслей в ответ, может вернуться отказом. Промпты в духе «сначала распиши рассуждение, потом ответ» под Opus 5.5 стоит переписать.
Для каких задач Opus 5.5 подходит, а для каких избыточна
Opus 5.5 стоит брать туда, где решение растягивается на много шагов и требует удержания плана без постоянного участия человека: многофайловый рефакторинг, аудит большого проекта, самостоятельные действия в интерфейсах программ, разбор документов с графиками и схемами, финансовые модели и многолистовые таблицы.
А для короткого бытового вопроса или разовой правки текста она избыточна, и причина конкретная: рассуждения включены всегда и отключить их нельзя вообще. Даже простейший запрос пройдёт через размышление и вернётся с задержкой. Для таких сценариев разумнее взять модель полегче — благо в одном чате их можно переключать, не теряя контекст разговора.
С 28 сентября у Opus 5.5 есть и вдвое более дешёвая соседка по поколению — Claude Sonnet 5.5. На чётко поставленных задачах, от исправления багов до отчётов и таблиц, она почти вровень с Opus, а на сложном коде заметно уступает. Что она умеет, мы разобрали в статье что умеет Claude Sonnet 5.5.
Как попробовать Claude Opus 5.5 в Veruna AI
Claude Opus 5.5 добавлена в каталог моделей Veruna AI и открыта на подписке Max — актуальные условия смотрите на странице тарифов. Без VPN и без иностранной карты, оплата в рублях: подключение устроено так же, как к остальным моделям каталога. Про сам процесс доступа из России мы подробно разобрали в статье как пользоваться Claude Opus 5.5.
Формат платформы тут кстати: модели переключаются в одном окне. Тяжёлую Opus 5.5 логично брать под многошаговую самостоятельную задачу, а на короткий вопрос переключаться на модель полегче, не открывая второй сервис. Рядом в каталоге лежат и соседи по линейке — Claude Opus 5 и Claude Fable 5.1, так что ответы на своей задаче можно сравнить в том же чате. Стоит ли вообще переезжать с предыдущей версии, мы посчитали отдельно — Opus 5.5 против Opus 5.
Короткие сценарии
Аудит или миграция большой кодовой базы. Заявленная сильная сторона: многочасовые автономные прогоны с параллельными субагентами. Тестировщик прошёл миграцию на 680 тысяч строк меньше чем за сутки.
Разбор документа с плотными графиками, схемой или скриншотом интерфейса. Область самого практичного прироста: 89,0% на чтении графиков против 83,4%, причём без дополнительной обвязки для картинок.
Финансовая модель или проверка чужого расчёта. Модель реже называет неверную цифру и вылавливает расхождения между графиком и таблицей под ним.
Быстрый бытовой вопрос. Рассуждения включены всегда и отключить их нельзя, поэтому короткий ответ всё равно придёт с задержкой. Разумнее переключиться на модель полегче.
Частые вопросы
Что умеет Claude Opus 5.5? Держать в контексте документ на миллион токенов, вести многошаговые задачи в коде и в интерфейсах программ без постоянного надзора, разбирать графики, схемы и скриншоты, собирать финансовые модели и многолистовые таблицы. На входе модель принимает текст и изображения, на выходе выдаёт только текст.
Чем возможности Opus 5.5 отличаются от Opus 5? Цифрами и настройками по умолчанию. Terminal-Bench 4.0 — 66,4% против 52,3%, CursorBench 4.0 — 57,8% против 46,6%, OSWorld 2.0 — 81,8% против 74,0%, чтение графиков — 89,0% против 83,4%. Плюс по замерам Anthropic модель на среднем уровне рассуждений повторяет Opus 5 на высоком, тратя меньше шагов.
Можно ли отключить рассуждения у Opus 5.5? Нет. У Opus 5 это было возможно на уровне high и ниже, у Opus 5.5 запрос с выключенными размышлениями возвращает ошибку на любом уровне. Единственный способ думать меньше — опустить уровень effort, по умолчанию стоит medium.
Где Claude Opus 5.5 подводит? Самое задокументированное — на длинной задаче модель иногда заканчивает ход отчётом вместо следующего действия, и автоматический агент на этом останавливается. Ещё на том же уровне рассуждений она думает больше Opus 5, особенно на xhigh и max, так что перенос настроек один в один увеличивает счёт. Плюс независимых замеров на дату релиза ещё нет.
Подходит ли Opus 5.5 для обычных задач вроде текстов и вопросов? Подходит, но избыточна. Рассуждения включены всегда, и любой ответ идёт через размышление — на коротком запросе это лишняя задержка. В каталоге Veruna AI модели переключаются в одном окне, так что тяжёлую разумнее оставить для многошаговых задач.