
Кратко
- Fable 5.1 обходит Opus 5 почти во всех сопоставимых тестах, но разрыв чаще всего в пределах двух-пяти пунктов, а не в разы.
- Исключение одно: на правках в реальном коде (DeepSWE v1.1) впереди Opus 5 — 74,0% против 70,0%.
- Токены Fable 5.1 вдвое дороже ($10 и $50 против $5 и $25), зато чтение из кэша у неё вдвое дешевле — $0,25 против $0,50.
- Единственное по-настоящему крупное различие в бенчмарках — научные задачи в терминале: 52,6% у Fable 5.1 против 29,0% у Opus 5.
Вопрос «claude opus 5 или claude fable 5» звучит странно только на первый взгляд: обе модели сделала Anthropic, обе лежат в одном каталоге, и выбор между ними сводится к тому, сколько вы готовы доплатить за лишние пункты в тестах. Claude Opus 5 (в рунете её ищут и как «клод опус 5», и просто как «опус 5») вышла 24 июля 2026 года, Claude Fable 5.1 — 1 сентября. Более свежая модель сильнее, это видно по цифрам. Вопрос в том, за что именно вы платите вдвое и в каких задачах эта переплата возвращается. Сравнение ниже построено по опубликованным бенчмаркам и прайсам, а не по заголовкам релизов.
Бенчмарки: Fable 5.1 впереди, но не везде одинаково
Общую картину проще всего взять у DataCamp: там релизные цифры обеих моделей собраны в один набор.
На научных задачах в терминале (Terminal-Bench-Science 0.1) разрыв действительно большой: 52,6% у Fable 5.1 против 29,0% у Opus 5, почти вдвое. А вот дальше разница схлопывается. На обычной работе в терминале (Terminal-Bench 4.0) — 55,8% против 52,3%. В автоматизации рутинных операций (AutomationBench) — 31,4% против 26,9%. В самостоятельной работе внутри программ (OSWorld 2.0, строгий режим) — 41,7% против 39,6%; в обычном режиме того же теста планка ниже, и цифры у обеих моделей заметно выше. На правках в редакторе кода (CursorBench 3.2.0) — 73,4% против 70,0%.
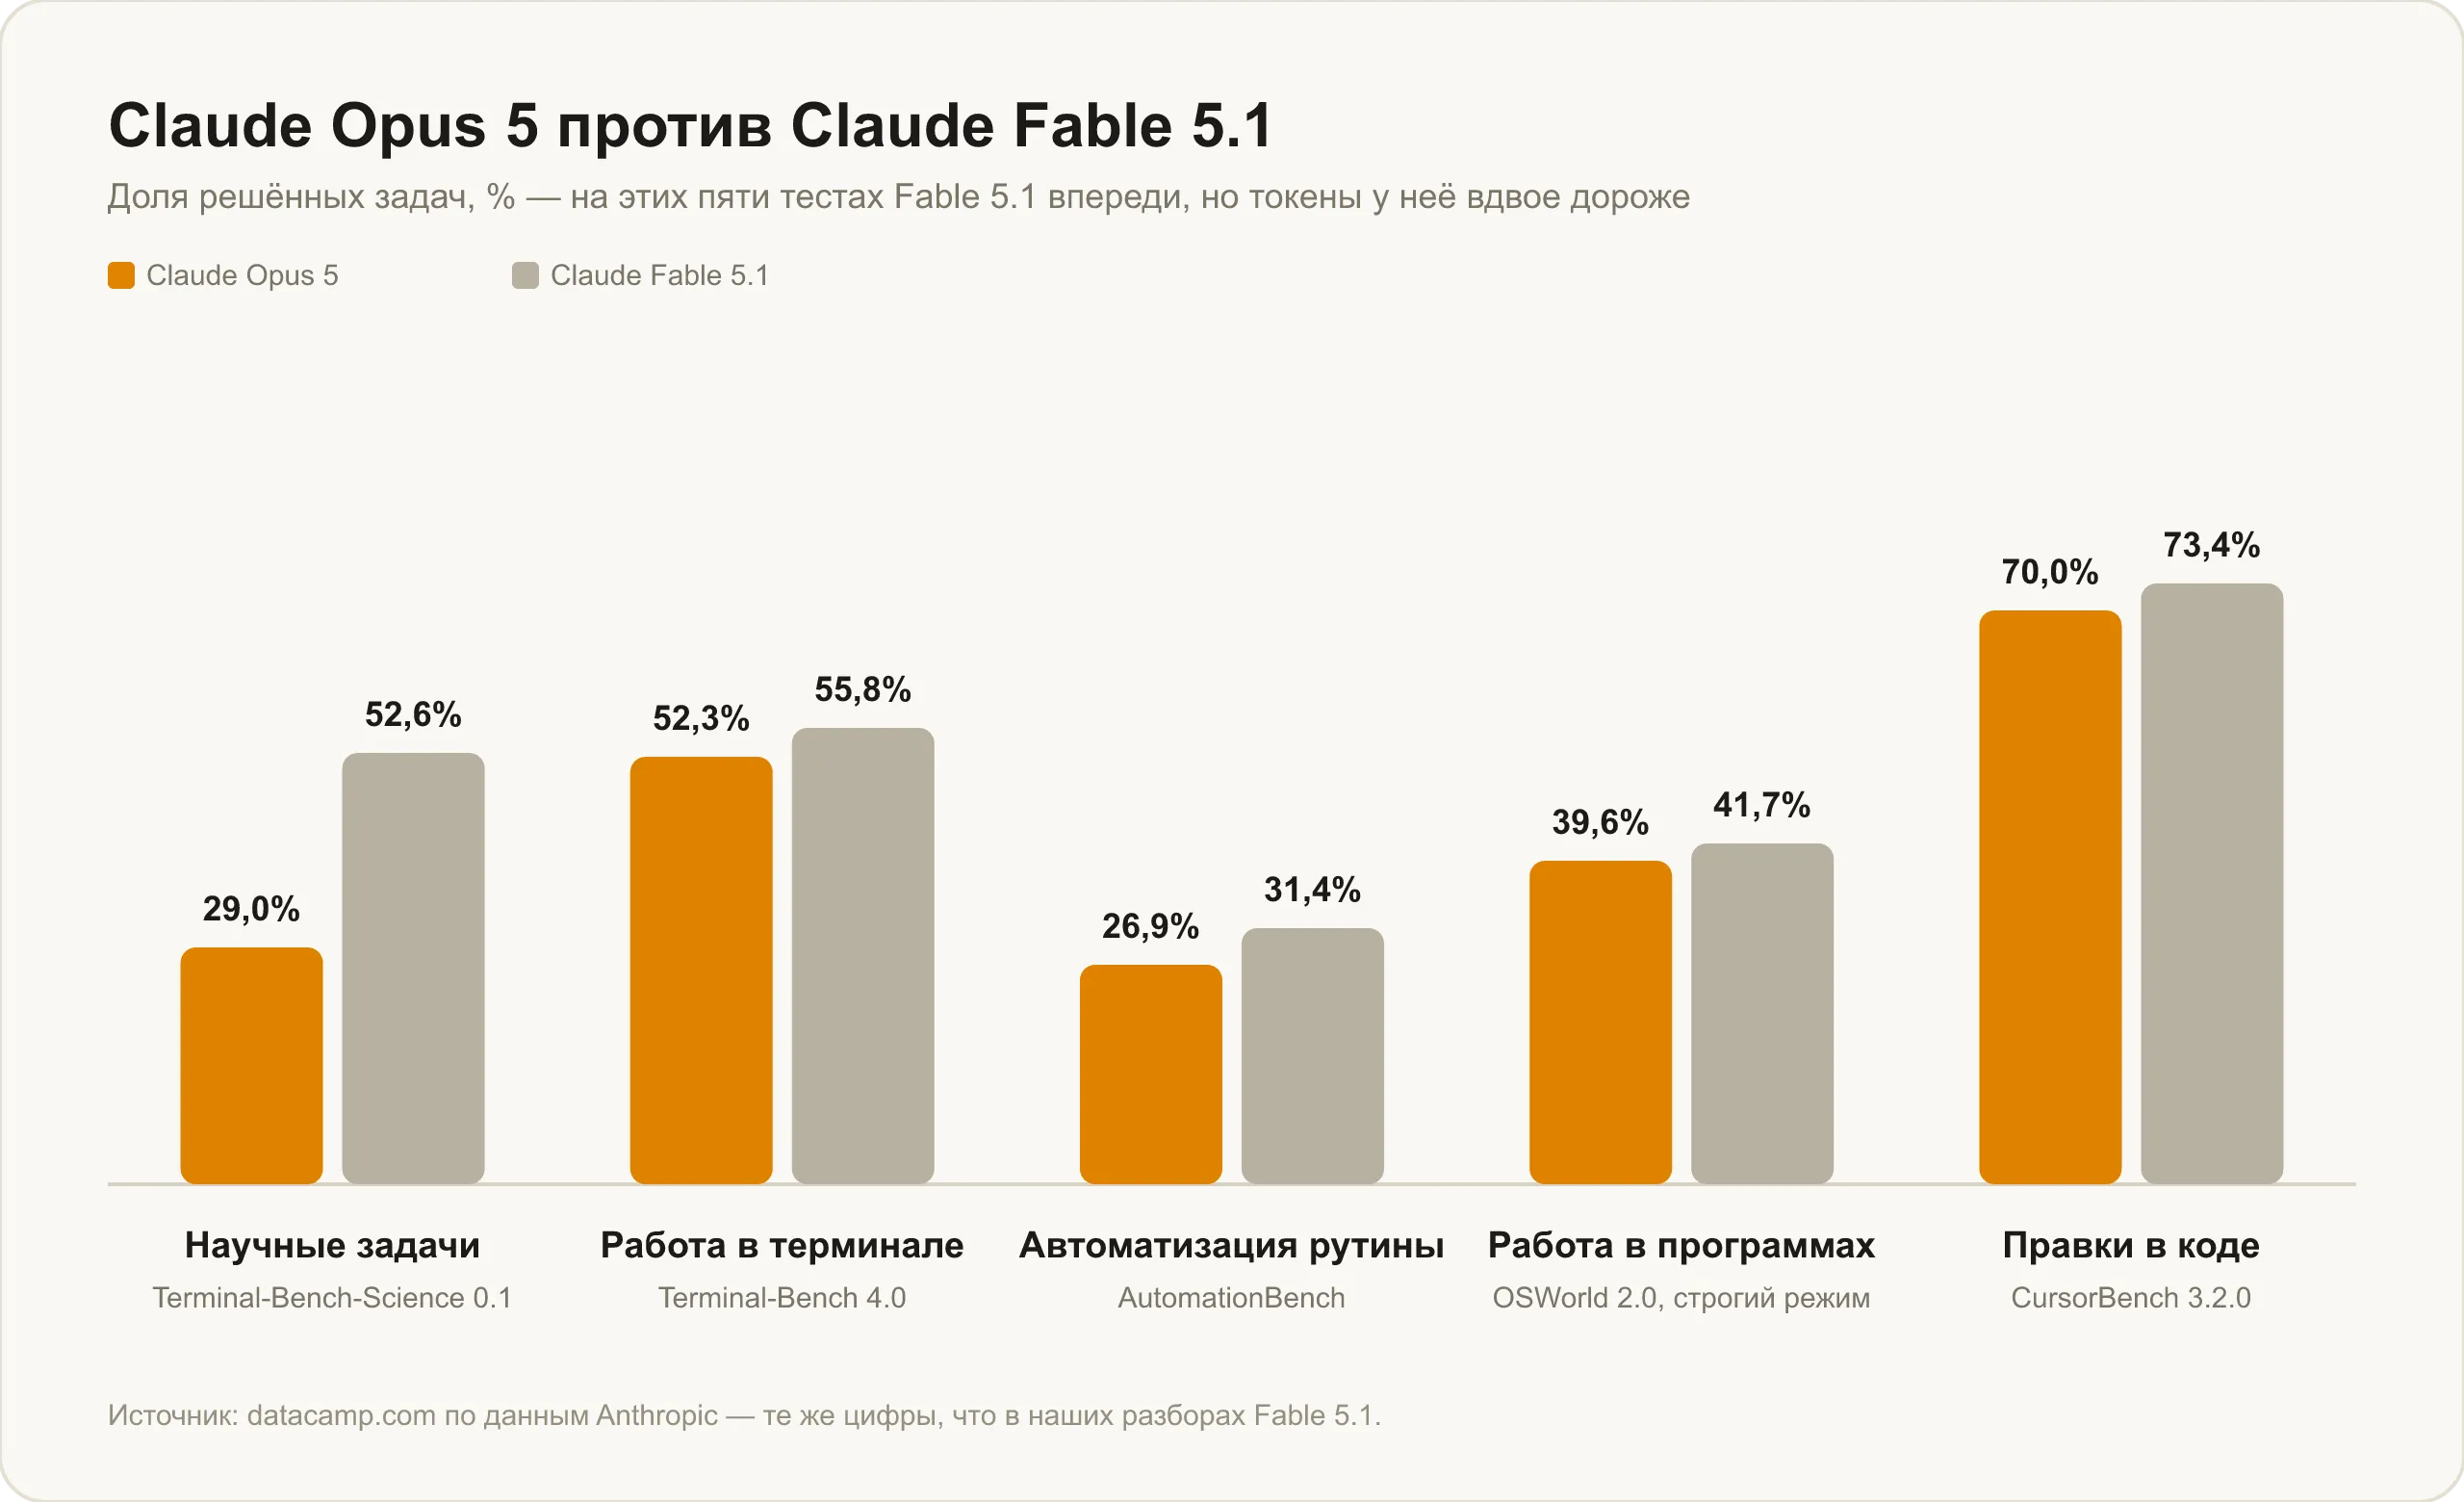
Картина получается неровной, и это важнее общего вывода «новая модель лучше». По запросу «opus 5 vs fable 5» ищут именно это: не общий рейтинг, а разницу по конкретным задачам. В одном узком сценарии — многоэтапных научных расчётах в терминале — Fable 5.1 действительно играет в другой лиге. В остальных четырёх разница укладывается в два-пять процентных пунктов, то есть в диапазон, который на реальном проекте легко перекрывается формулировкой промпта.
Один тест, где впереди более старая модель
Есть и обратный пример, про который в релизных материалах обычно не пишут. DeepSWE v1.1 — независимый тест на правки в реальных репозиториях, собранный так, чтобы модель не могла подсмотреть эталонное решение в истории проекта. На нём у Claude Opus 5 74,0%, у Claude Fable 5.1 — 70,0%.
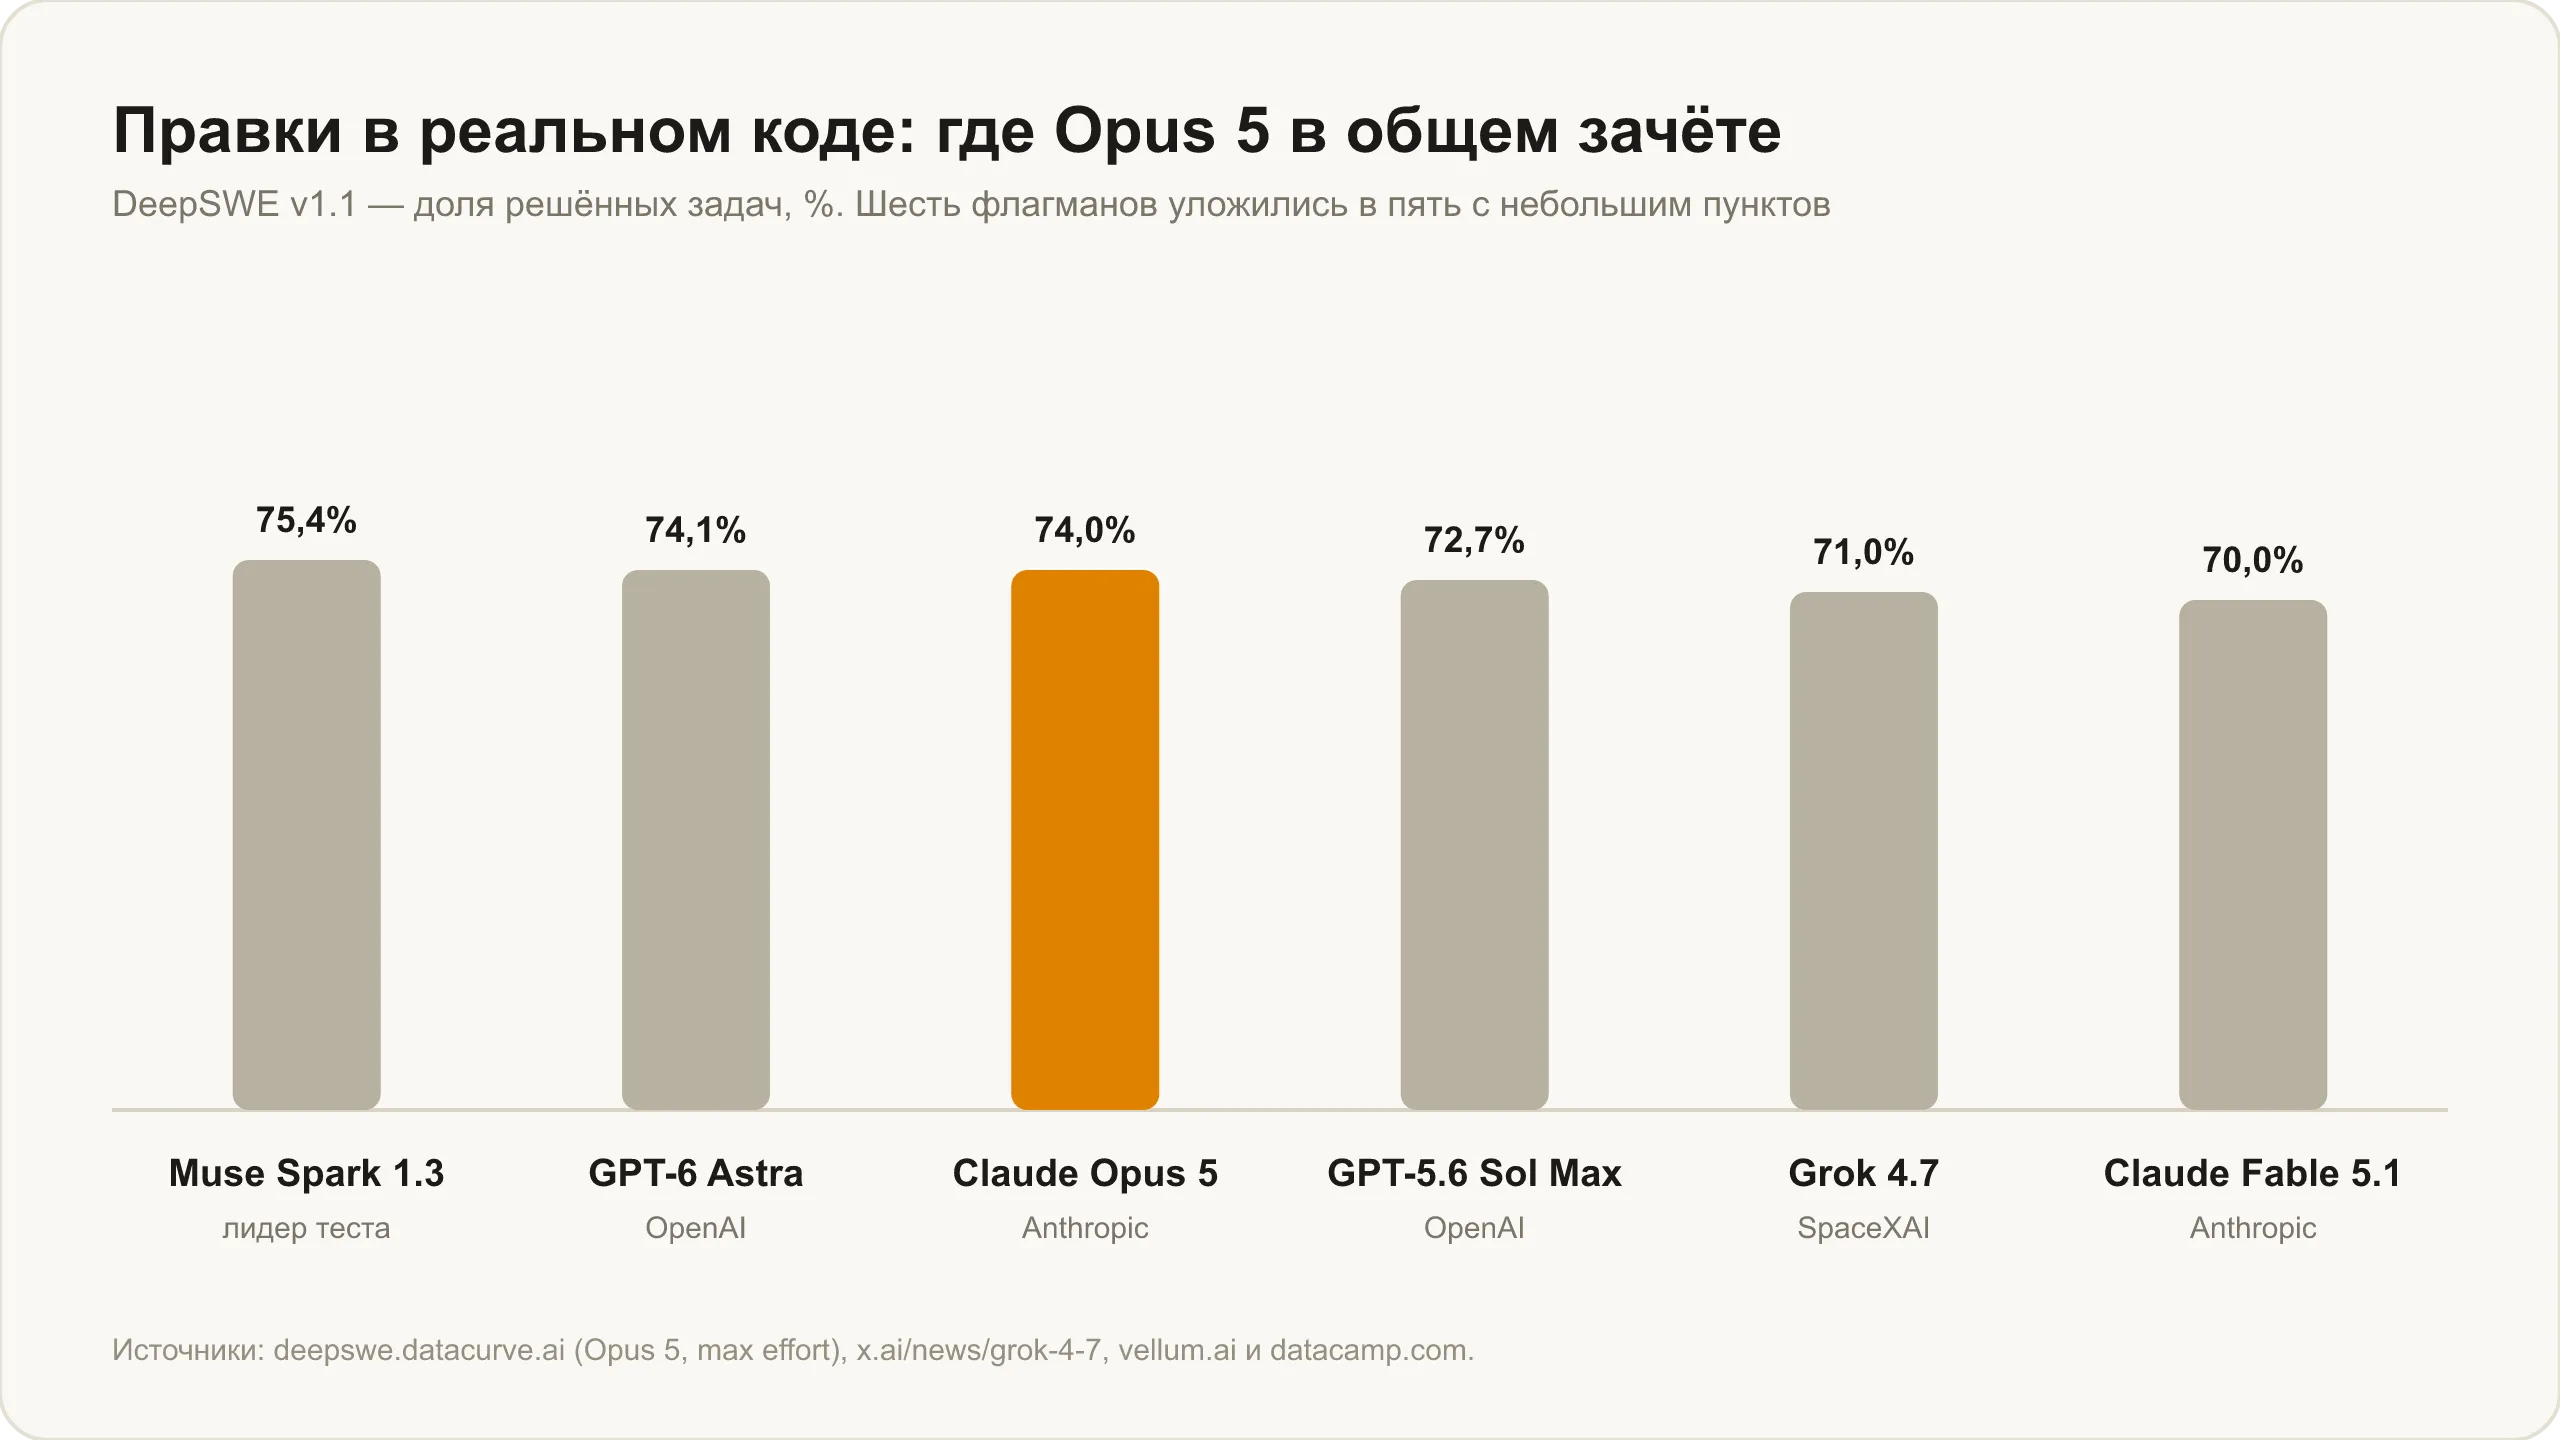
Это единственный из сопоставимых тестов, где более старая и вдвое более дешёвая модель оказывается впереди. Объяснение, скорее всего, в том, что релизные бенчмарки Anthropic и независимый лидерборд проверяют разные вещи: первые заточены под агентные и научные сценарии, второй — под обычную продуктовую работу с кодом. Практический смысл тот же: если задача — править код в существующем проекте, аргументов переплачивать за Fable 5.1 из цифр не следует.
Деньги: вдвое дешевле токены, вдвое дороже кэш
Разница в прайсе выглядит однозначной: $5 и $25 за миллион токенов у Opus 5 против $10 и $50 у Fable 5.1.
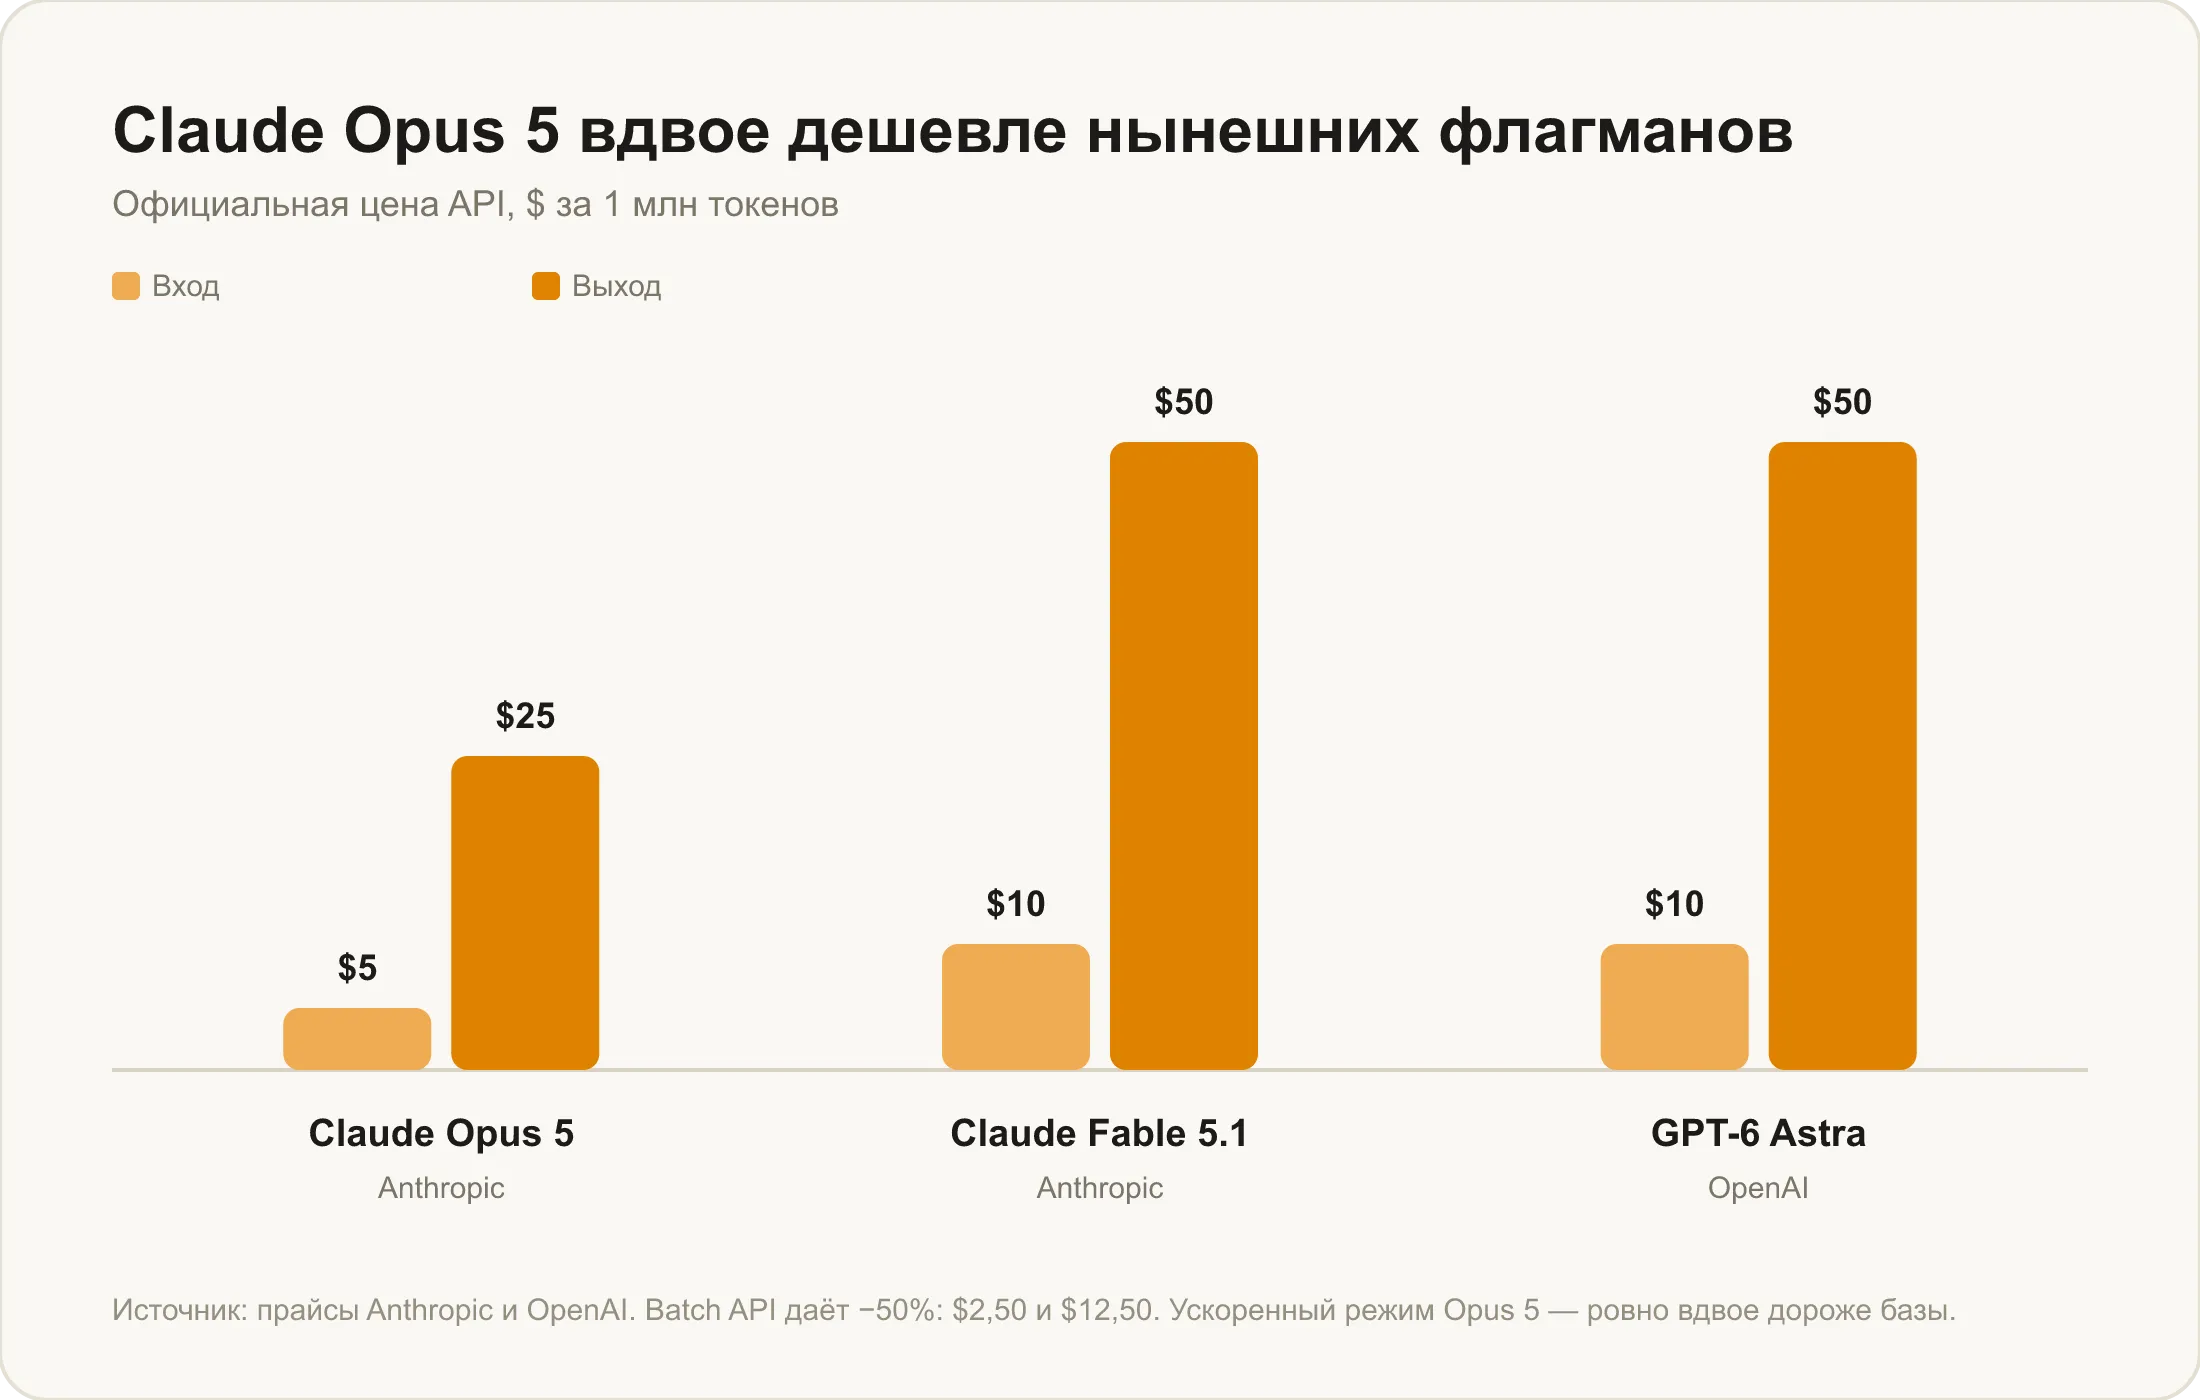
Но считать надо не за токен, а за сценарий, и здесь есть встречное движение. Чтение из кэша у Fable 5.1 стоит $0,25 за миллион токенов, у Opus 5 — $0,50, то есть вдвое дороже. В длинной агентной сессии, где модель десятки раз обращается к одному и тому же большому контексту — репозиторию, базе знаний, многостраничному документу, — основная часть счёта приходится именно на повторный ввод. На таких нагрузках разрыв в цене между двумя моделями заметно уже, чем следует из базового прайса, а по оценке самой Anthropic удешевление кэша даёт на агентных сценариях экономию до 45%.
Есть и деталь в пользу Opus 5, которой у Fable 5.1 нет вовсе: ускоренный режим fast mode. Он выдаёт ответ примерно в два с половиной раза быстрее за вдвое большую цену — то есть $10 и $50, ровно столько, сколько стоит обычный режим Fable 5.1. Работает он только через собственный API Anthropic, не через облачные платформы.
Характеристики: таблица
| Параметр | Claude Opus 5 | Claude Fable 5.1 |
|---|---|---|
| Дата выхода | 24 июля 2026 | 1 сентября 2026 |
| Идентификатор в API | claude-opus-5 | claude-fable-5-1 |
| Контекстное окно | 1 000 000 токенов | 1 000 000 токенов |
| Максимальный ответ | 128 000 токенов | 128 000 токенов |
| Дата знаний | май 2026 | июнь 2026 |
| Вход | текст, изображения | текст, изображения |
| Выход | только текст | только текст |
| Рассуждения | 5 уровней, можно выключить на high и ниже | 3 уровня, выключить нельзя |
| Ускоренный режим | есть | нет |
| Цена ввода | $5 за млн | $10 за млн |
| Цена вывода | $25 за млн | $50 за млн |
| Чтение из кэша | $0,50 за млн | $0,25 за млн |
| Научные задачи в терминале | 29,0% | 52,6% |
| Работа в терминале, Terminal-Bench 4.0 | 52,3% | 55,8% |
| Автоматизация, AutomationBench | 26,9% | 31,4% |
| Работа в программах, OSWorld 2.0, строгий режим | 39,6% | 41,7% |
| Правки в редакторе, CursorBench 3.2.0 | 70,0% | 73,4% |
| Правки в коде, DeepSWE v1.1 | 74,0% | 70,0% |
| Широкая эрудиция, Humanity's Last Exam | 63,6% | 65,0% |
Обратите внимание на строку с датой знаний: у Fable 5.1 она на месяц свежее. На практике это почти никогда не решает, потому что обе модели одинаково плохо знают то, что случилось после обучения, и обеим полезнее дать нужные факты прямо в контекст.
Рассуждения: практическая разница, которой нет в бенчмарках
Самое ощутимое в ежедневной работе различие не измеряется процентами. У Claude Fable 5.1 режим размышлений отключить нельзя — можно выбрать только глубину из трёх уровней, и даже на элементарный вопрос модель сначала думает. У Opus 5 уровней пять (low, medium, high, xhigh и max), по умолчанию стоит high, и рассуждения можно выключить полностью — правда, только на уровне high и ниже: с xhigh или max запрос вернёт ошибку.
Правило отсюда простое. Если в сценарии есть короткие и быстрые запросы вперемешку с тяжёлыми, Opus 5 гибче: её можно опустить на низкий уровень или вовсе отключить размышления и получить мгновенный ответ. Если сценарий целиком состоит из длинных многошаговых задач, эта гибкость не пригодится, и разница стирается.
Ещё одна деталь в ту же сторону: Anthropic советует убрать из промптов под Opus 5 унаследованные инструкции вида «в конце обязательно перепроверь результат». Модель делает это сама, и лишняя команда только раздувает ответ. У Opus 5 вообще есть репутация многословной — подробнее про претензии пользователей мы писали в разборе что умеет Claude Opus 5.
Что выбрать под задачу
- Многоэтапная научная или инженерная задача в терминале — Fable 5.1. Это единственный сценарий, где разрыв кратный: 52,6% против 29,0%, и переплата вдвое здесь оправдана прямо по цифрам.
- Длинная агентная сессия с одним большим контекстом — тоже Fable 5.1, но по другой причине: кэш у неё вдвое дешевле, и на десятках обращений к одному репозиторию разница в базовом прайсе частично отыгрывается назад.
- Правки в обычном продуктовом коде — Opus 5. На независимом DeepSWE v1.1 она впереди (74,0% против 70,0%) и при этом вдвое дешевле по токенам.
- Работа внутри программ, разбор документов с графиками, офисные задачи с таблицами — практически ничья, разница в два пункта. Здесь дешёвый прайс Opus 5 имеет прямой смысл.
- Смешанный сценарий, где короткие вопросы чередуются с тяжёлыми, — Opus 5: только у неё можно опустить уровень рассуждений или отключить их совсем.
- Нужен потолок качества независимо от счёта — Fable 5.1. Она выигрывает почти везде, пусть и небольшими долями, и в этом смысле выбор безопаснее — что именно она умеет, разобрано в материале что умеет Claude Fable 5.1.
Общий вывод получается таким: Fable 5.1 — это верхняя граница качества линейки, Opus 5 — её рабочая середина по соотношению цены и результата. Универсального чемпиона тут нет, и «взять ту, что новее» — плохое правило, когда почти во всех тестах, кроме научных задач в терминале, разница укладывается в несколько пунктов, а цена отличается вдвое. Как обе модели выглядят на фоне флагмана другого разработчика, мы разбирали в материале GPT-6 Astra против Claude Fable 5.1.
Как сравнить модели самому
Обе модели Anthropic уже в каталоге Veruna AI и переключаются в одном чате. Не нужно заводить аккаунт у Anthropic и разбираться с оплатой, чтобы прогнать одну и ту же задачу через две модели и сравнить ответы вживую — это честнее, чем полагаться на процент из чужого бенчмарка, потому что на вашей кодовой базе или вашем документе модели нередко ведут себя иначе, чем на тестовом наборе.
Работает без VPN, с оплатой в рублях. Opus 5 и Fable 5.1 открыты на подписке Max — оформить можно на странице тарифов. Как получить доступ из России и что с оплатой, разобрано подробно в статьях как пользоваться Claude Opus 5 и как пользоваться Claude Fable 5.1.
Частые вопросы
Что лучше — Claude Opus 5 или Claude Fable 5.1? Зависит от задачи. Fable 5.1 сильнее почти во всех тестах, но разрыв обычно в пределах двух-пяти пунктов, а токены у неё вдвое дороже. Кратная разница есть только в научных задачах в терминале — 52,6% против 29,0%. На правках в реальном коде впереди, наоборот, Opus 5.
Правда ли Fable 5.1 вдвое дороже? По базовому прайсу да: $10 и $50 за миллион токенов против $5 и $25 у Opus 5. Но чтение из кэша у Fable 5.1 вдвое дешевле — $0,25 против $0,50, — и в длинных агентных сессиях с одним большим контекстом разрыв в счёте оказывается меньше, чем следует из прайса.
Чем отличаются рассуждения у двух моделей? У Opus 5 пять уровней глубины (low, medium, high, xhigh, max), по умолчанию high, и размышления можно отключить на уровне high и ниже. У Fable 5.1 уровней три и отключить размышления нельзя вообще — даже короткий вопрос обрабатывается с задержкой.
У какой модели больше контекст? Одинаковый — 1 млн токенов у обеих, и предел ответа тоже совпадает: 128 тысяч токенов. Различается только дата знаний: май 2026 у Opus 5 против июня 2026 у Fable 5.1.
Можно ли сравнить обе модели на своей задаче? Да. Opus 5 и Fable 5.1 есть в каталоге Veruna AI, переключение между моделями происходит прямо в чате, без отдельного аккаунта у Anthropic. Это надёжнее, чем ориентироваться только на проценты из бенчмарков.