
Кратко
- Claude Sonnet 5.5 вышла 28 сентября 2026 года — второй моделью семейства Claude 5.5, через шесть дней после Opus 5.5.
- Цена не изменилась: $2 и $10 за миллион токенов, как у Sonnet 5. Это вдвое дешевле Opus 5.5.
- В релизной таблице Anthropic модель почти вровень с Opus 5.5, а в работе в терминале впереди: 70,6% против 66,4%.
- Для тех, кто работает через API, есть пять изменений, которые ломают код под Sonnet 5. Главное — рассуждения больше не выключаются параметром
disabled.
Claude Sonnet 5.5 — модель Anthropic с идентификатором claude-sonnet-5-5, пришедшая на смену Claude Sonnet 5. Если коротко отвечать на запрос «sonnet 5.5 что это»: это прямое обновление средней модели линейки, которое по цене осталось на месте, а по результатам подтянулось почти к флагману Claude Opus 5.5. В рунете её ищут как «сонет 5.5», «соннет 5.5» и «клод сонет 5.5». Дальше — дата выхода, паспорт модели, цифры из релиза и то, что в этих цифрах стоит читать с оговорками.
Дата выхода Claude Sonnet 5.5
Claude Sonnet 5.5 вышла в понедельник, 28 сентября 2026 года. В тот же день Anthropic опубликовала анонс и открыла доступ через Claude API, приложения Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry и Claude Platform on AWS. Вечером того же дня модель появилась на агрегаторе OpenRouter как anthropic/claude-sonnet-5.5, с контекстом в миллион токенов и тем же прайсом.
Это вторая модель семейства Claude 5.5. Первой 22 сентября вышла Opus 5.5, третьей, по словам Anthropic, станет Claude Haiku 5.5 для объёмных и чувствительных к цене задач — она обещана «в ближайшие недели».
Слухи до релиза ходили разные. В сети, например, писали про контекстное окно на 2 млн токенов, а заодно приписывали новой модели кодовое имя Fennec, хотя этим именем ещё до июньского релиза называли Sonnet 5. Окно в итоге осталось прежним — 1 млн токенов.
Характеристики Claude Sonnet 5.5
Паспорт модели по документации Anthropic:
| Параметр | Значение |
|---|---|
| Идентификатор в API | claude-sonnet-5-5 |
| Дата выхода | 28 сентября 2026 года |
| Контекстное окно | 1 000 000 токенов |
| Максимальный ответ | 128 000 токенов (до 300 000 через Batch API в бете) |
| Дата знаний | июнь 2026 года |
| Вход / выход | текст и изображения / только текст |
| Рассуждения | адаптивные, включены по умолчанию |
| Уровни глубины | low, medium, high, xhigh, max |
| Уровень по умолчанию | high в API, medium в приложениях Claude |
| Скорость | «быстрая» в классификации Anthropic (у Opus 5.5 — «средняя») |
| Цена ввода / вывода | $2 / $10 за млн токенов |
| Чтение из кэша | $0,20 за млн токенов |
| Batch API | $1 / $5 за млн токенов |
| Снятие с поддержки | не раньше 28 сентября 2027 года |
Миллион токенов на текущем токенизаторе — это около 555 тысяч слов. Токенизатор у Sonnet 5.5 тот же, что у Sonnet 5, поэтому один и тот же текст даёт то же число токенов, и пересчитывать бюджеты не нужно. Минимальная длина промпта для кэширования снизилась с 1024 до 512 токенов.
Цена: как у Sonnet 5
В прайсе Anthropic Sonnet 5.5 стоит $2 за миллион входных токенов и $10 за миллион выходных. Запись в кэш — $2,50 при пятиминутном хранении и $4 при часовом. Пакетная обработка — вдвое дешевле. Всё это совпадает с Sonnet 5 до цента.
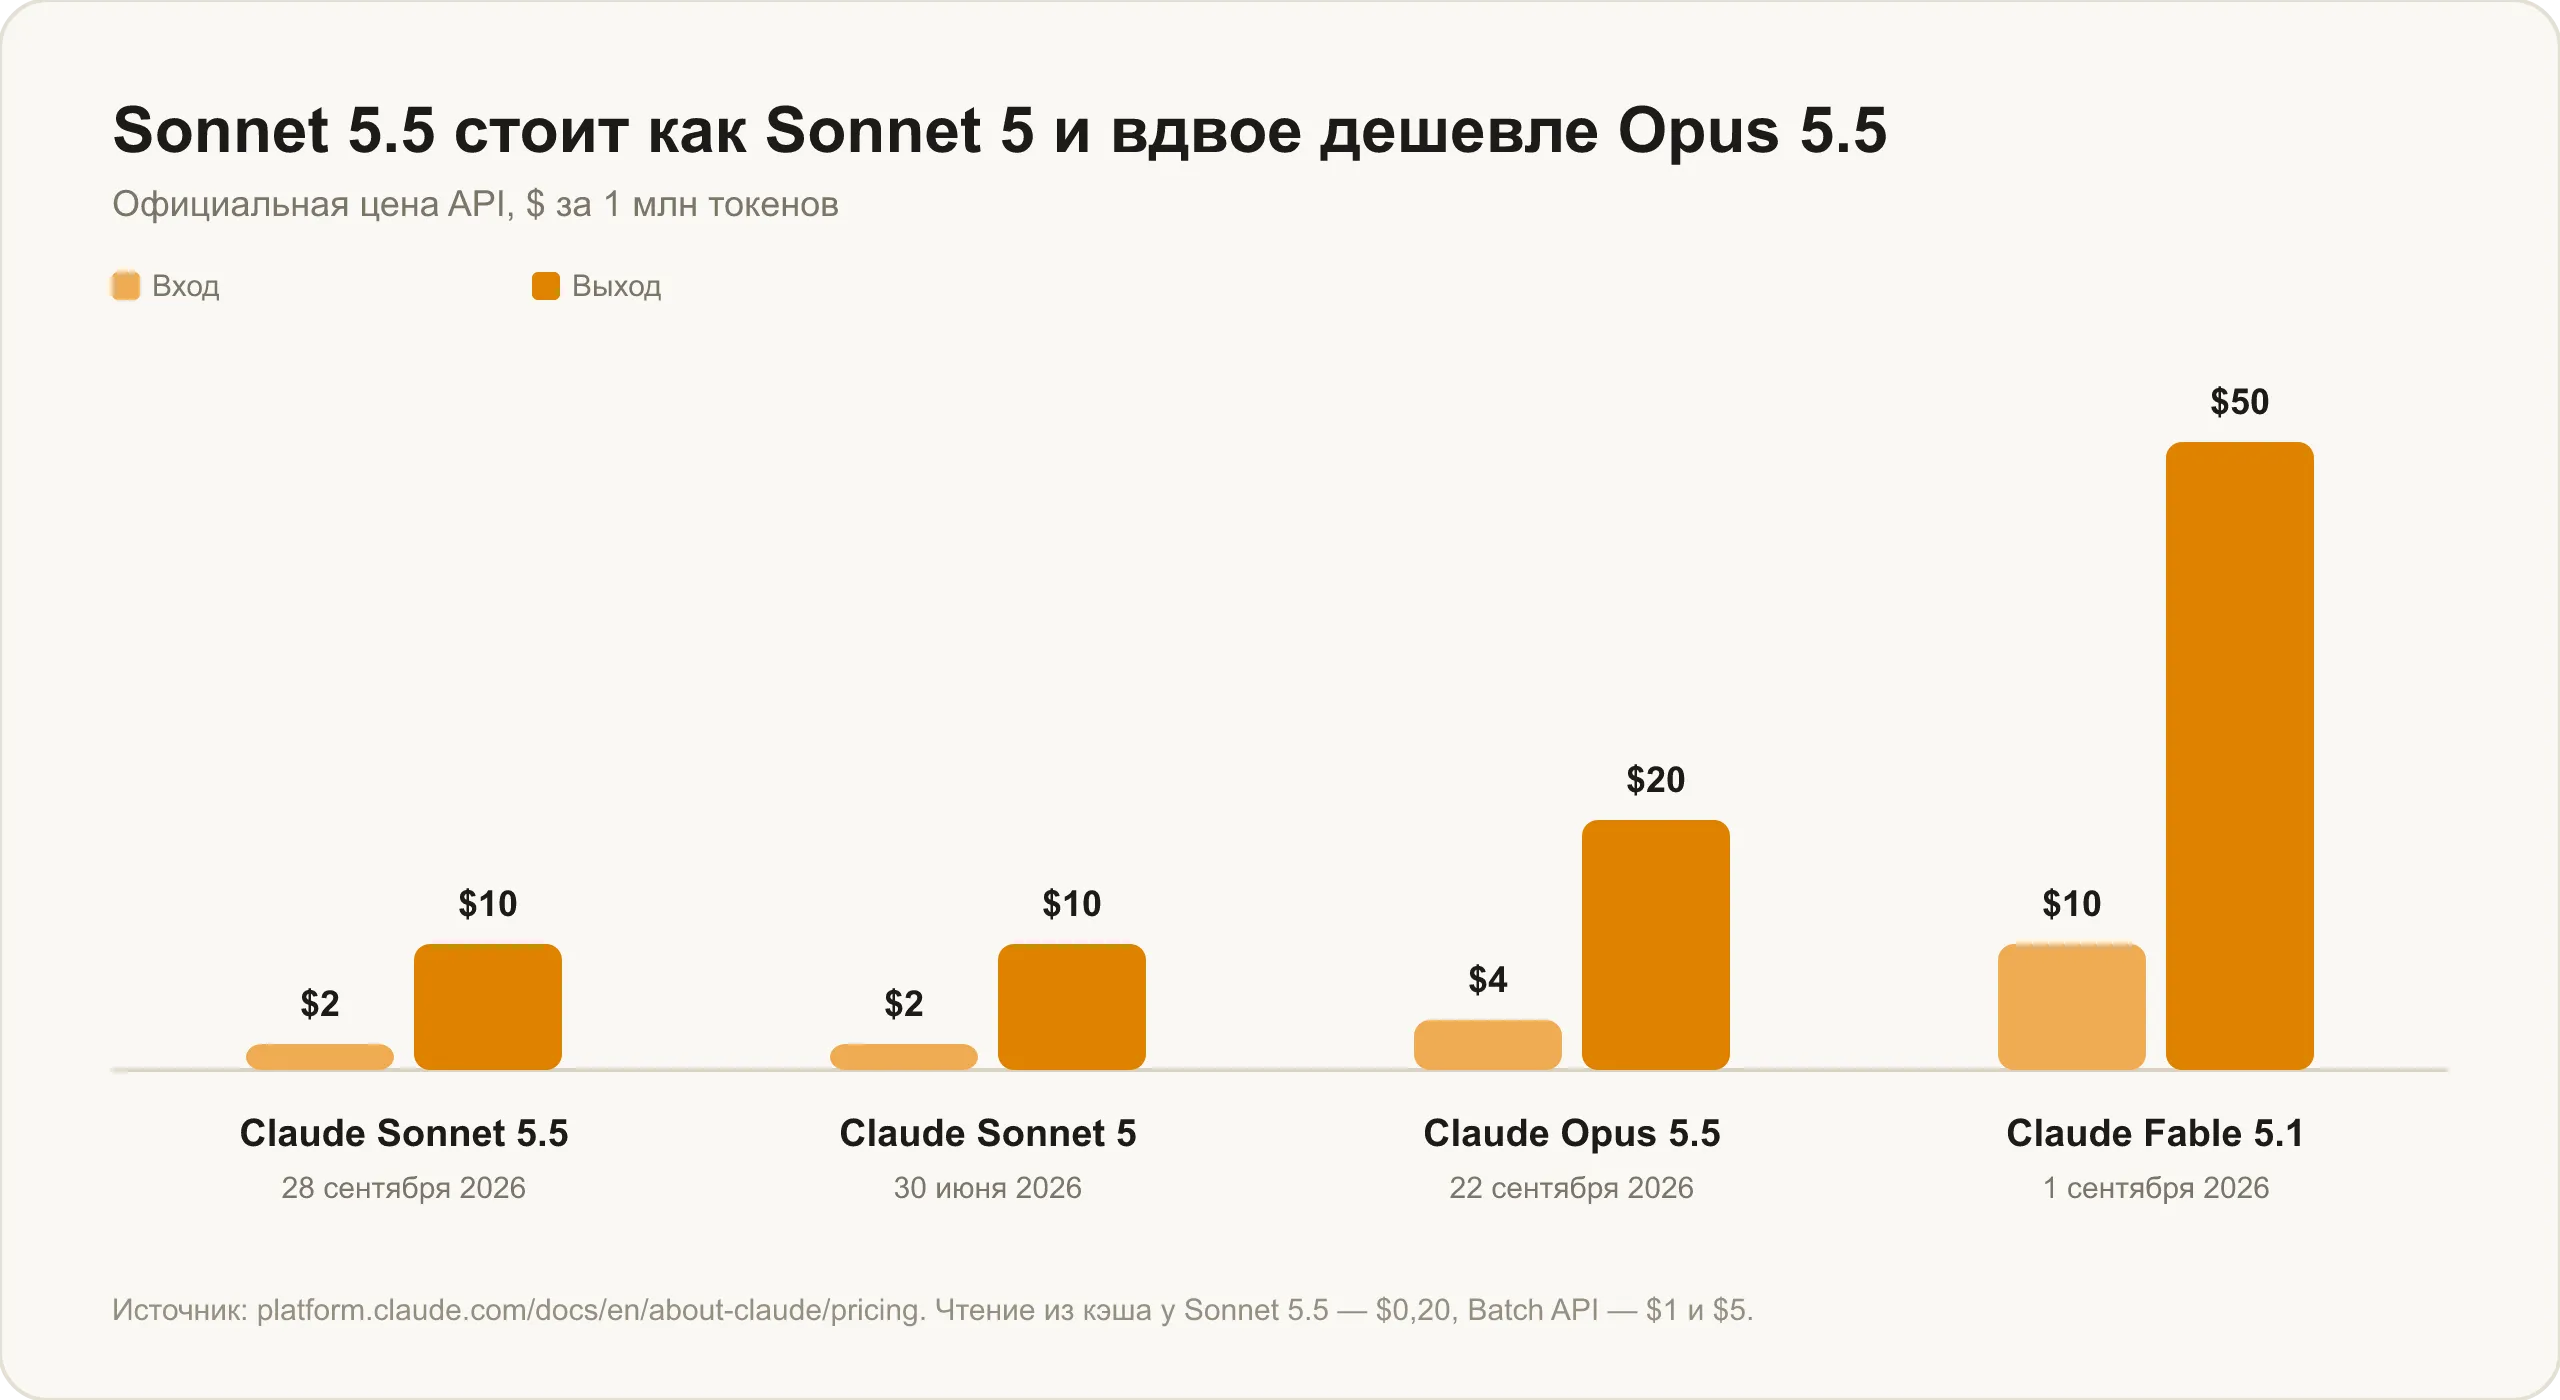
У этого прайса есть предыстория. Sonnet 5 в июне вышла по вводной цене $2 и $10, которая должна была действовать до 31 августа, а с 1 сентября подняться до $3 и $15. Повышения не случилось: теперь в прайсе прямо написано, что вводная цена стала стандартной. Sonnet 5.5 её сохранила.
Отдельно Anthropic обещает экономию не на прайсе, а на расходе: ответы генерируются более чем на 30% быстрее, чем у Sonnet 5, а одна задача обходится до 30% дешевле — за счёт меньшего числа токенов и вызовов инструментов.
Бенчмарки Claude Sonnet 5.5
В релизной таблице Anthropic Sonnet 5.5 выигрывает у Sonnet 5 на всех приведённых тестах. На правках в редакторе кода (CursorBench 4.0) — 55,5% против 34,1%. В самостоятельной работе внутри программ (OSWorld 2.1 в варианте partial) — 80,1% против 57,0%. На чтении графиков без инструментов (Chartography) — 61,6% против 15,6%. В широкой эрудиции с инструментами (Humanity's Last Exam) — 64,5% против 54,9%. На сложных задачах по коду (FrontierCode 1.1) — 46,2% против 42,4%.
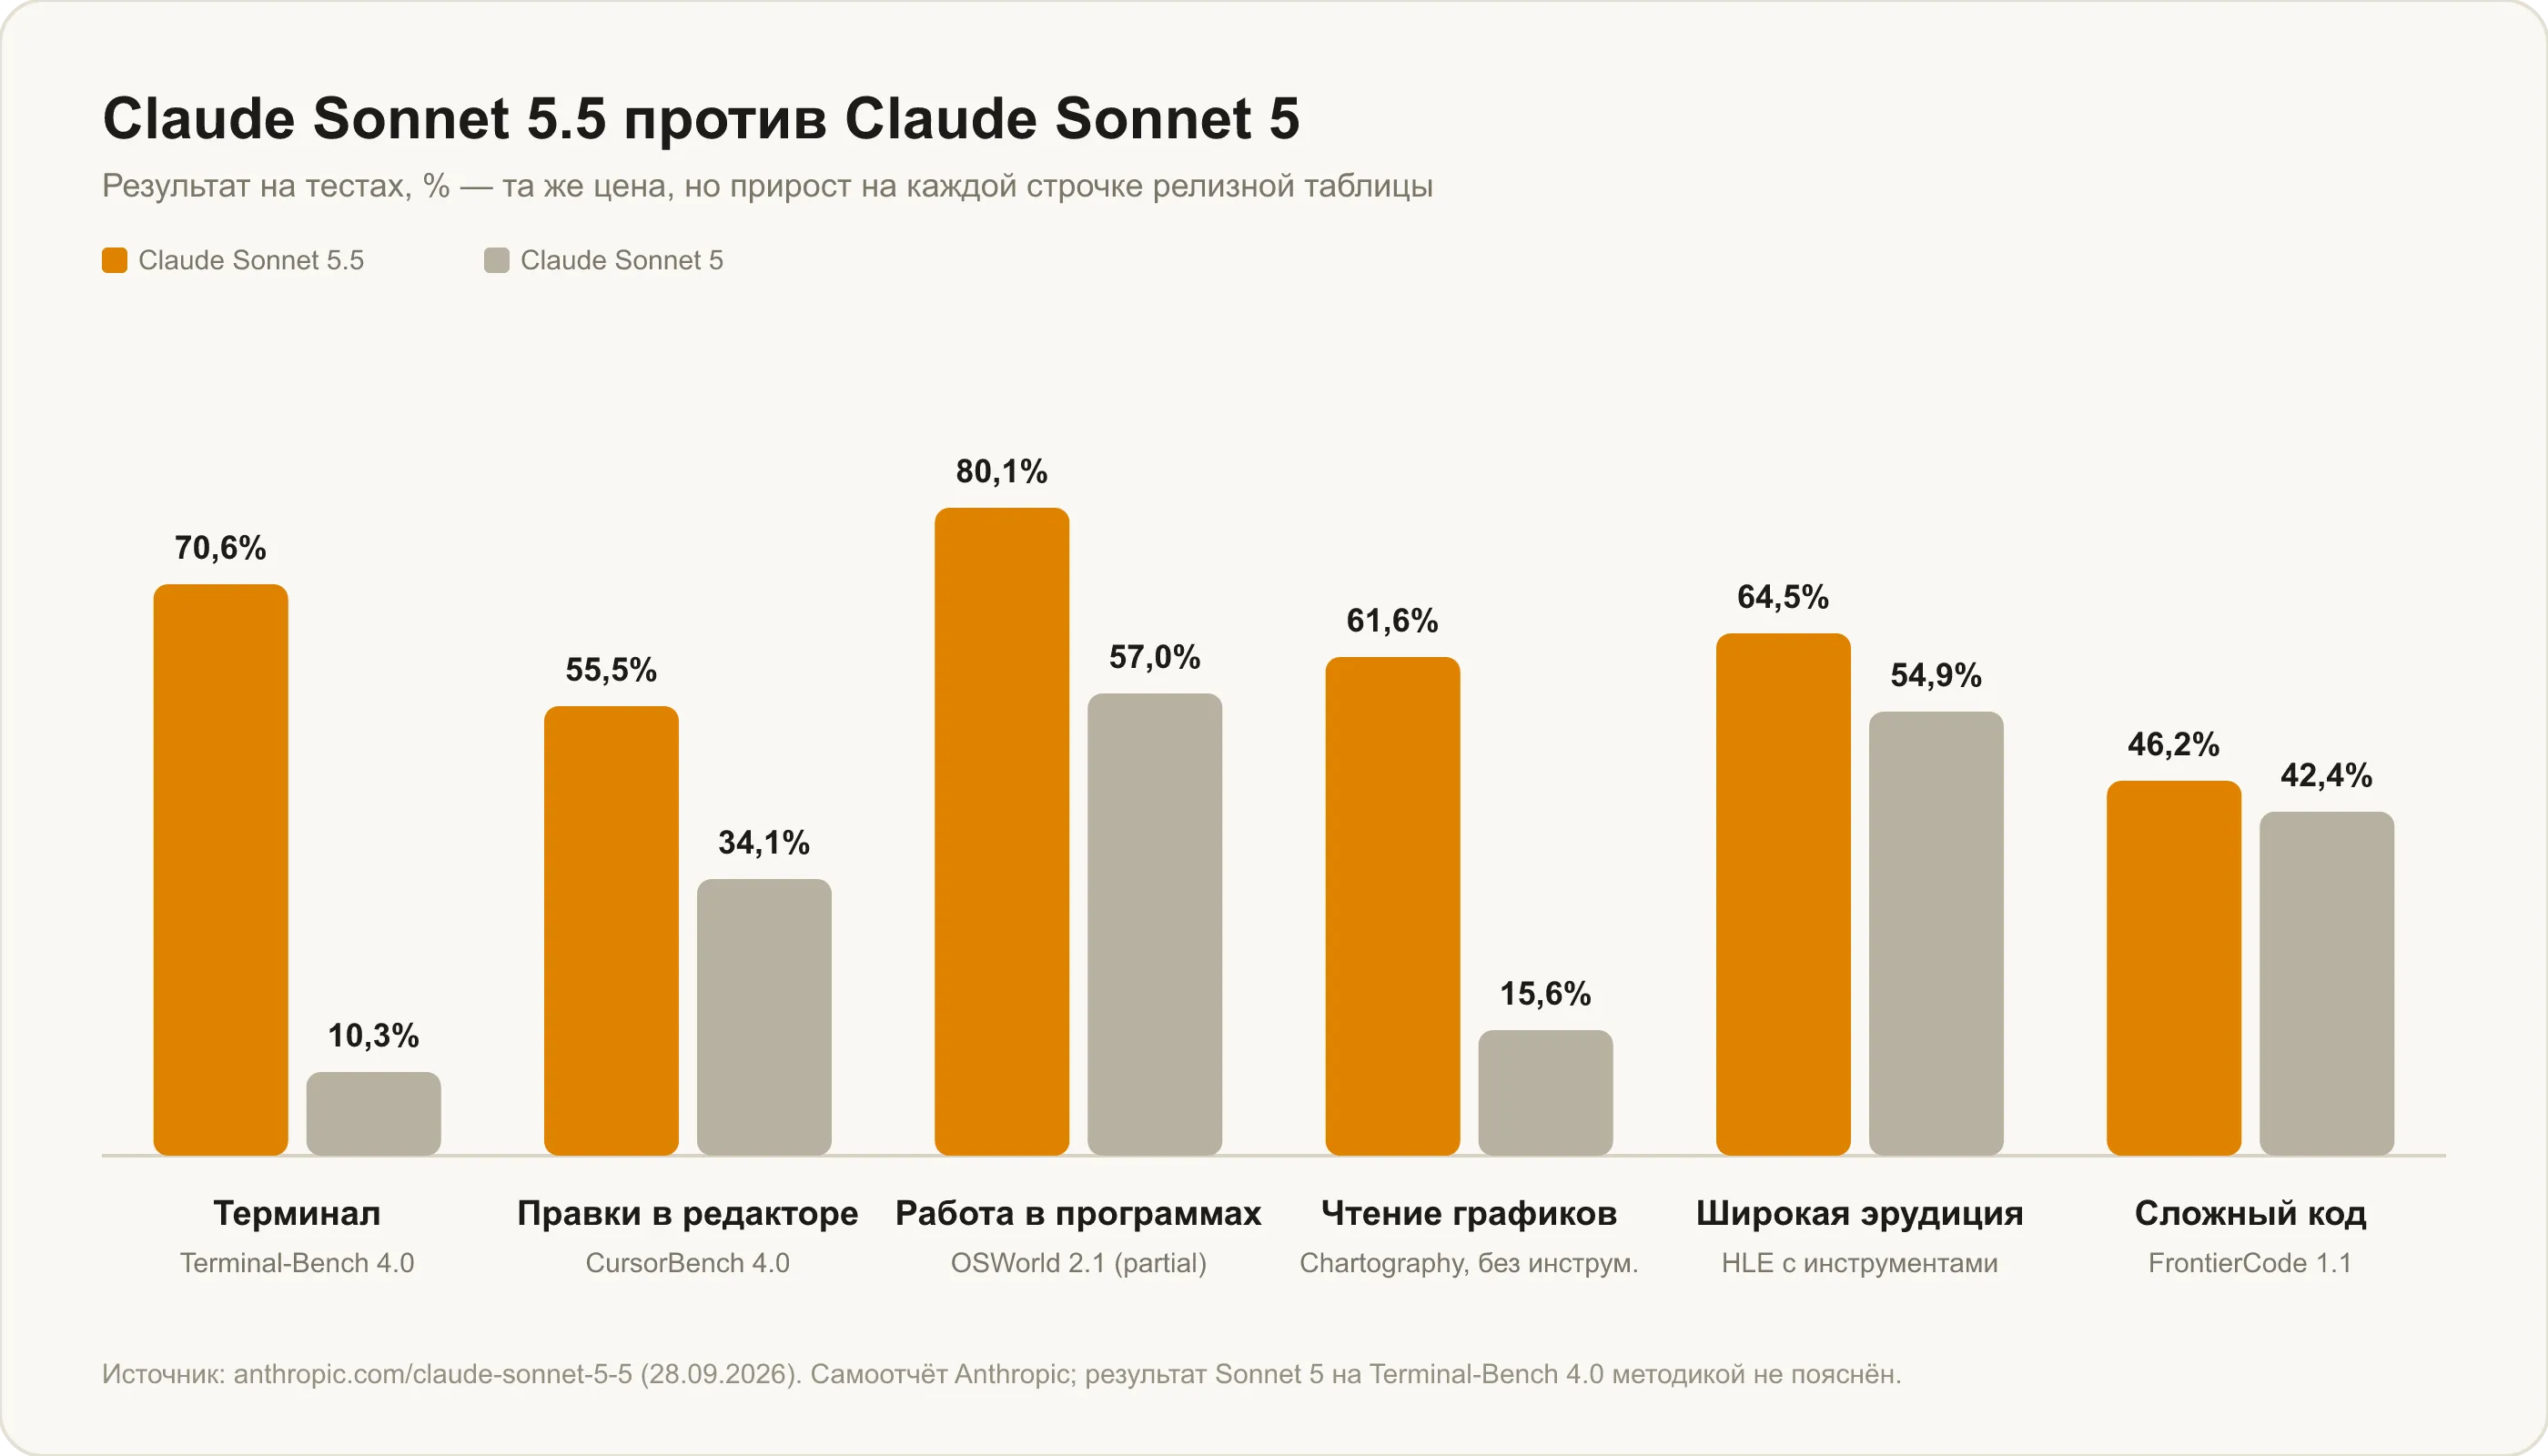
Самая громкая строчка — работа в терминале (Terminal-Bench 4.0): 70,6% против 10,3% у Sonnet 5. Тут нужна оговорка. Разрыв аномально большой, и Anthropic не объясняет, в каких условиях Sonnet 5 получила свой результат. Для сравнения: на прошлой версии теста, Terminal-Bench 2.1, у Sonnet 5 было 80,4%. Это разные версии бенчмарка, напрямую сравнивать их нельзя, но и «в семь раз лучше» из этой строчки выводить не стоит.
Интереснее сравнение с Opus 5.5 из той же таблицы. На терминале Sonnet 5.5 впереди — 70,6% против 66,4%. На остальных тестах Opus выше, но ненамного: работа в программах 80,1% против 81,8%, правки в редакторе 55,5% против 57,8%. Заметно отстаёт Sonnet только на сложном коде: 46,2% против 54,4%. Подробно это разобрано в сравнении Sonnet 5.5 или Opus 5.5.
Anthropic приводит и экономические цифры. На уровне medium, который стоит по умолчанию в приложениях Claude, Sonnet 5.5 далеко обходит лучший результат Sonnet 5 меньше чем за десятую долю цены одной задачи. На FrontierCode на уровне high она набирает на 10 пунктов больше Sonnet 5 при той же настройке и примерно в 15 раз дешевле по задаче. А ещё Sonnet 5.5 — первая модель Sonnet, которая прошла Pokémon Red, глядя только на скриншоты.
Пять изменений, которые ломают код под Sonnet 5
Этот раздел для тех, кто работает через API. В разделе «что нового» Anthropic перечисляет пять изменений, из-за которых код, рабочий на Sonnet 5, на Sonnet 5.5 упадёт с ошибкой 400.
Рассуждения выключаются по-новому. Запрос с thinking: {"type": "disabled"} возвращает ошибку. Вместо него нужно передавать between_tools — самый низкий режим, который убирает размышление перед ответом. Работает он только на уровнях low, medium и high; на xhigh и max выключить размышления нельзя.
Принудительный вызов инструмента не поддерживается. Варианты tool_choice any и tool возвращают ошибку. Вместо них — автоматический выбор плюс строгая схема вызова.
Блоки размышлений привязаны к модели и разговору. Sonnet 5.5 читает размышления Sonnet 5 и более старых моделей, но не Opus 5, Opus 5.5, Fable и Mythos. Её собственные блоки понимает только Opus 5.5, и только на Claude API и Google Cloud. Если история разговора отредактирована задним числом, запрос с её старыми размышлениями может упасть.
Старый инструмент управления компьютером не принимается на Claude API и Google Cloud, нужен новый набор инструментов. На Amazon Bedrock прежний вариант работает.
Часть «советников» отклоняется. В бета-инструменте advisor Sonnet 5.5 не принимает в роли советника Opus 4.8, Opus 4.7 и Sonnet 5.
Шестое изменение ничего не ломает, но меняет поведение. Текст, который модель пишет между вызовами инструментов, теперь приходит блоком размышлений, по умолчанию пустым. Приложение, которое показывало этот текст пользователю как отчёт о ходе работы, на длинном прогоне замолчит, пока его не перенастроят.
Безопасность: фолбэк на Sonnet 5
Sonnet 5.5 — первая модель Sonnet, на которую поставили защиту от кибер-злоупотреблений уровня старших моделей. Запросы повышенного риска в этой области заметно для пользователя уходят на Sonnet 5. Специалистам по защите Anthropic предлагает расширенный доступ через программу Cyber Verification.
Добавились и новые категории отказов. Модель может отклонить запрос, который помогает разрабатывать конкурирующие модели ИИ, и запрос, который просит выписать её внутренние рассуждения прямо в ответ. Промпты в духе «сначала распиши ход мыслей, потом ответ» под Sonnet 5.5 лучше переписать.
Что в этом релизе читать с оговорками
Все цифры в таблице — самоотчёт Anthropic. Первый независимый замер уже есть: Artificial Analysis поставила Sonnet 5.5 на второе место своего индекса с 56 баллами, в двух пунктах от Opus 5.5 и на 18 пунктов выше Sonnet 5. В работе в терминале у лаборатории получилось около 64% против 60% у Opus 5.5: цифры ниже, чем у Anthropic, но порядок моделей тот же.
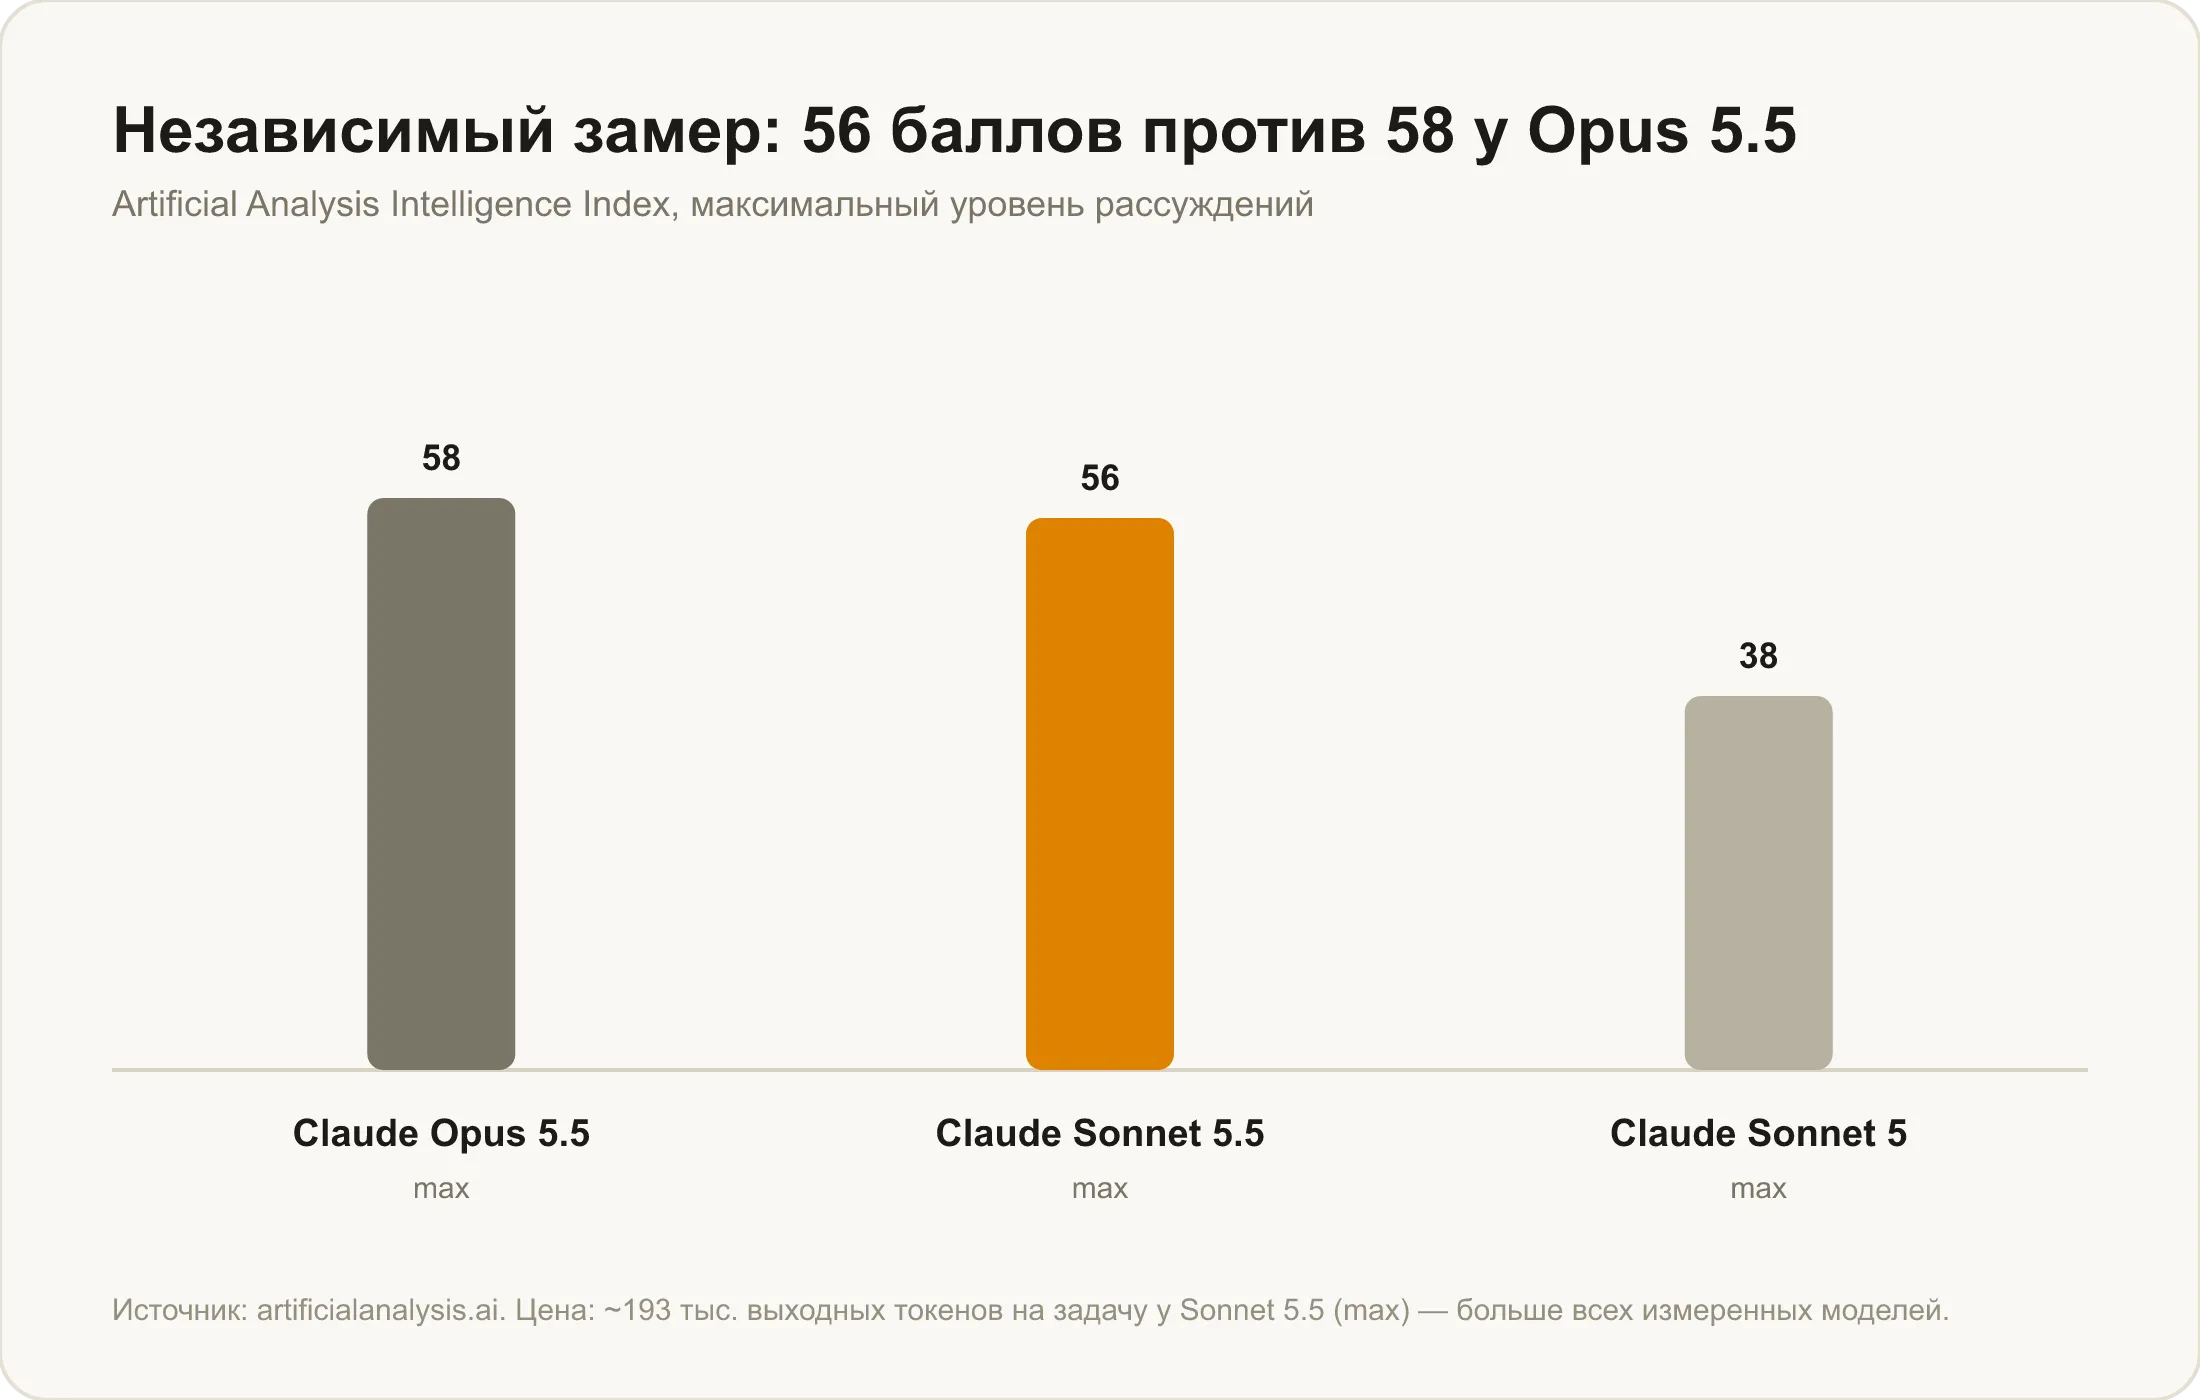
У того же замера есть обратная сторона. На максимальном уровне Sonnet 5.5 потратила около 193 тысяч выходных токенов на одну задачу — больше всех моделей, которые Artificial Analysis когда-либо измеряла, и примерно на 60% больше Opus 5.5. Задача обошлась в $7,60, примерно на 50% дороже, чем у Sonnet 5. То есть обещанные «до 30% дешевле на задачу» относятся к разумным уровням рассуждений, а на максимуме модель становится дороже предшественницы. Разработчик Саймон Уиллисон в своём тесте на max упёрся в лимит 128 тысяч токенов и не получил ответа вовсе, а на xhigh задача заняла 41 секунду.
И последнее. Anthropic прямо оговаривается, что бенчмарки не стоит считать точным прогнозом для любой рабочей нагрузки, а на сложной открытой работе Opus 5.5 остаётся заметно сильнее.
Как попробовать Claude Sonnet 5.5
Claude Sonnet 5.5 уже подключена в Veruna AI — сервисе, где в одном чате собраны нейросети разных разработчиков. Без VPN, без иностранной карты, оплата в рублях. Модель открыта на подписке Max, оформить её можно на странице тарифов. В селекторе рассуждений у модели три уровня: низкий (по умолчанию), средний и высокий. Выключить рассуждения в чате нельзя, как и у Opus 5.5.
Как получить доступ из России по шагам, разобрано в статье как пользоваться Claude Sonnet 5.5. А что модель умеет на практике и где подводит — в материале что умеет Claude Sonnet 5.5.
Частые вопросы
Когда вышла Claude Sonnet 5.5?
28 сентября 2026 года. В тот же день модель стала доступна в Claude API под идентификатором claude-sonnet-5-5, в приложениях Claude, в Amazon Bedrock, Google Cloud, Microsoft Foundry и на OpenRouter.
Что такое сонет 5.5? Модель среднего класса Anthropic, прямое обновление Sonnet 5. Контекст на 1 млн токенов, ответ до 128 тысяч, знания по июнь 2026 года, на входе текст и изображения, на выходе только текст.
Сколько стоит Claude Sonnet 5.5? В API Anthropic — $2 за миллион входных токенов и $10 за миллион выходных, как у Sonnet 5. Чтение из кэша — $0,20, пакетная обработка — $1 и $5. В Veruna AI модель доступна на подписке Max.
Чем Sonnet 5.5 отличается от Sonnet 5? При той же цене — заметно выше результаты: CursorBench 4.0 — 55,5% против 34,1%, OSWorld 2.1 — 80,1% против 57,0%, Humanity's Last Exam — 64,5% против 54,9%. Ответы, по заявлению Anthropic, более чем на 30% быстрее. В API — пять ломающих изменений, главное из которых касается выключения рассуждений.
Правда ли Sonnet 5.5 сильнее Opus 5.5? Только в работе в терминале: 70,6% против 66,4% по таблице Anthropic и около 64% против 60% по замеру Artificial Analysis. На остальных тестах Opus 5.5 немного впереди, а на сложном коде — заметно: 54,4% против 46,2%.