
Кратко
- Один бриф (квартальный отчёт магазина, нужно 8 слайдов) прогнали через 6 нейросетей по три раза, плюс через 4 генератора картинок.
- Первое место взяла Gemini 3 Pro: 46,6 из 50 баллов. Claude Opus 4.8 стоил в четыре раза дороже и ушёл на третье место.
- Claude Haiku 4.5 добавляла цифры от себя во всех трёх запусках. Остальные пять моделей за 15 запусков не выдумали ни одного факта.
- Слайд целиком одной картинкой без ошибок в русском тексте нарисовал один генератор из четырёх.
Если вы выбираете нейросеть для презентаций или другой ИИ для слайдов, сначала разделите задачу надвое. Модель пишет содержание: структуру, заголовки, тезисы. Вёрстку и картинки делает другой инструмент. Я проверил оба слоя и записал, где каждый ломается. Готовый файл PowerPoint в тесте не собирался: меня интересовало, что именно приходит на вход дизайнеру или сервису.
Как устроен тест
Бриф один на всех. Выдуманный интернет-магазин «Тест-Дом», итоги квартала: выручка, заказы, конверсия, возвраты, планы и риски. Исходник короткий, около 140 слов, все цифры в нём тестовые. Просьба такая: сделать презентацию для совета директоров на 8 слайдов, не добавлять фактов и цифр, которых нет в тексте, и вернуть только JSON с заголовком, тезисами, заметками докладчика и описанием иллюстрации для каждого слайда.
Каждую из шести моделей запускал три раза с тем же текстом. Всего 18 ответов. Оценка по пяти критериям, по 10 баллов каждый.
| Критерий | Как считал |
|---|---|
| Структура и формат | 5 баллов за чистый JSON без обёртки, 3 за ровно 8 слайдов, 2 за финальный слайд с выводами |
| Верность исходнику | 10 минус 2 за домысел и минус 4 за прямую ошибку в запуске |
| Русский язык | 10 минус 1,5 за запуск, где в тексте латиница или «Q2» вместо «второй квартал» |
| Пригодность к дизайну | слайды до 30 слов, не больше 4 тезисов, в описании картинки названа конкретная форма: диаграмма, карта, карточки |
| Время и цена | чем быстрее и дешевле, тем выше |
Веса мои, сырые ответы и расчёт я сохранил. Картинки к слайдам в баллы не вошли: их я проверил отдельным тестом.
Итоги: кто набрал сколько
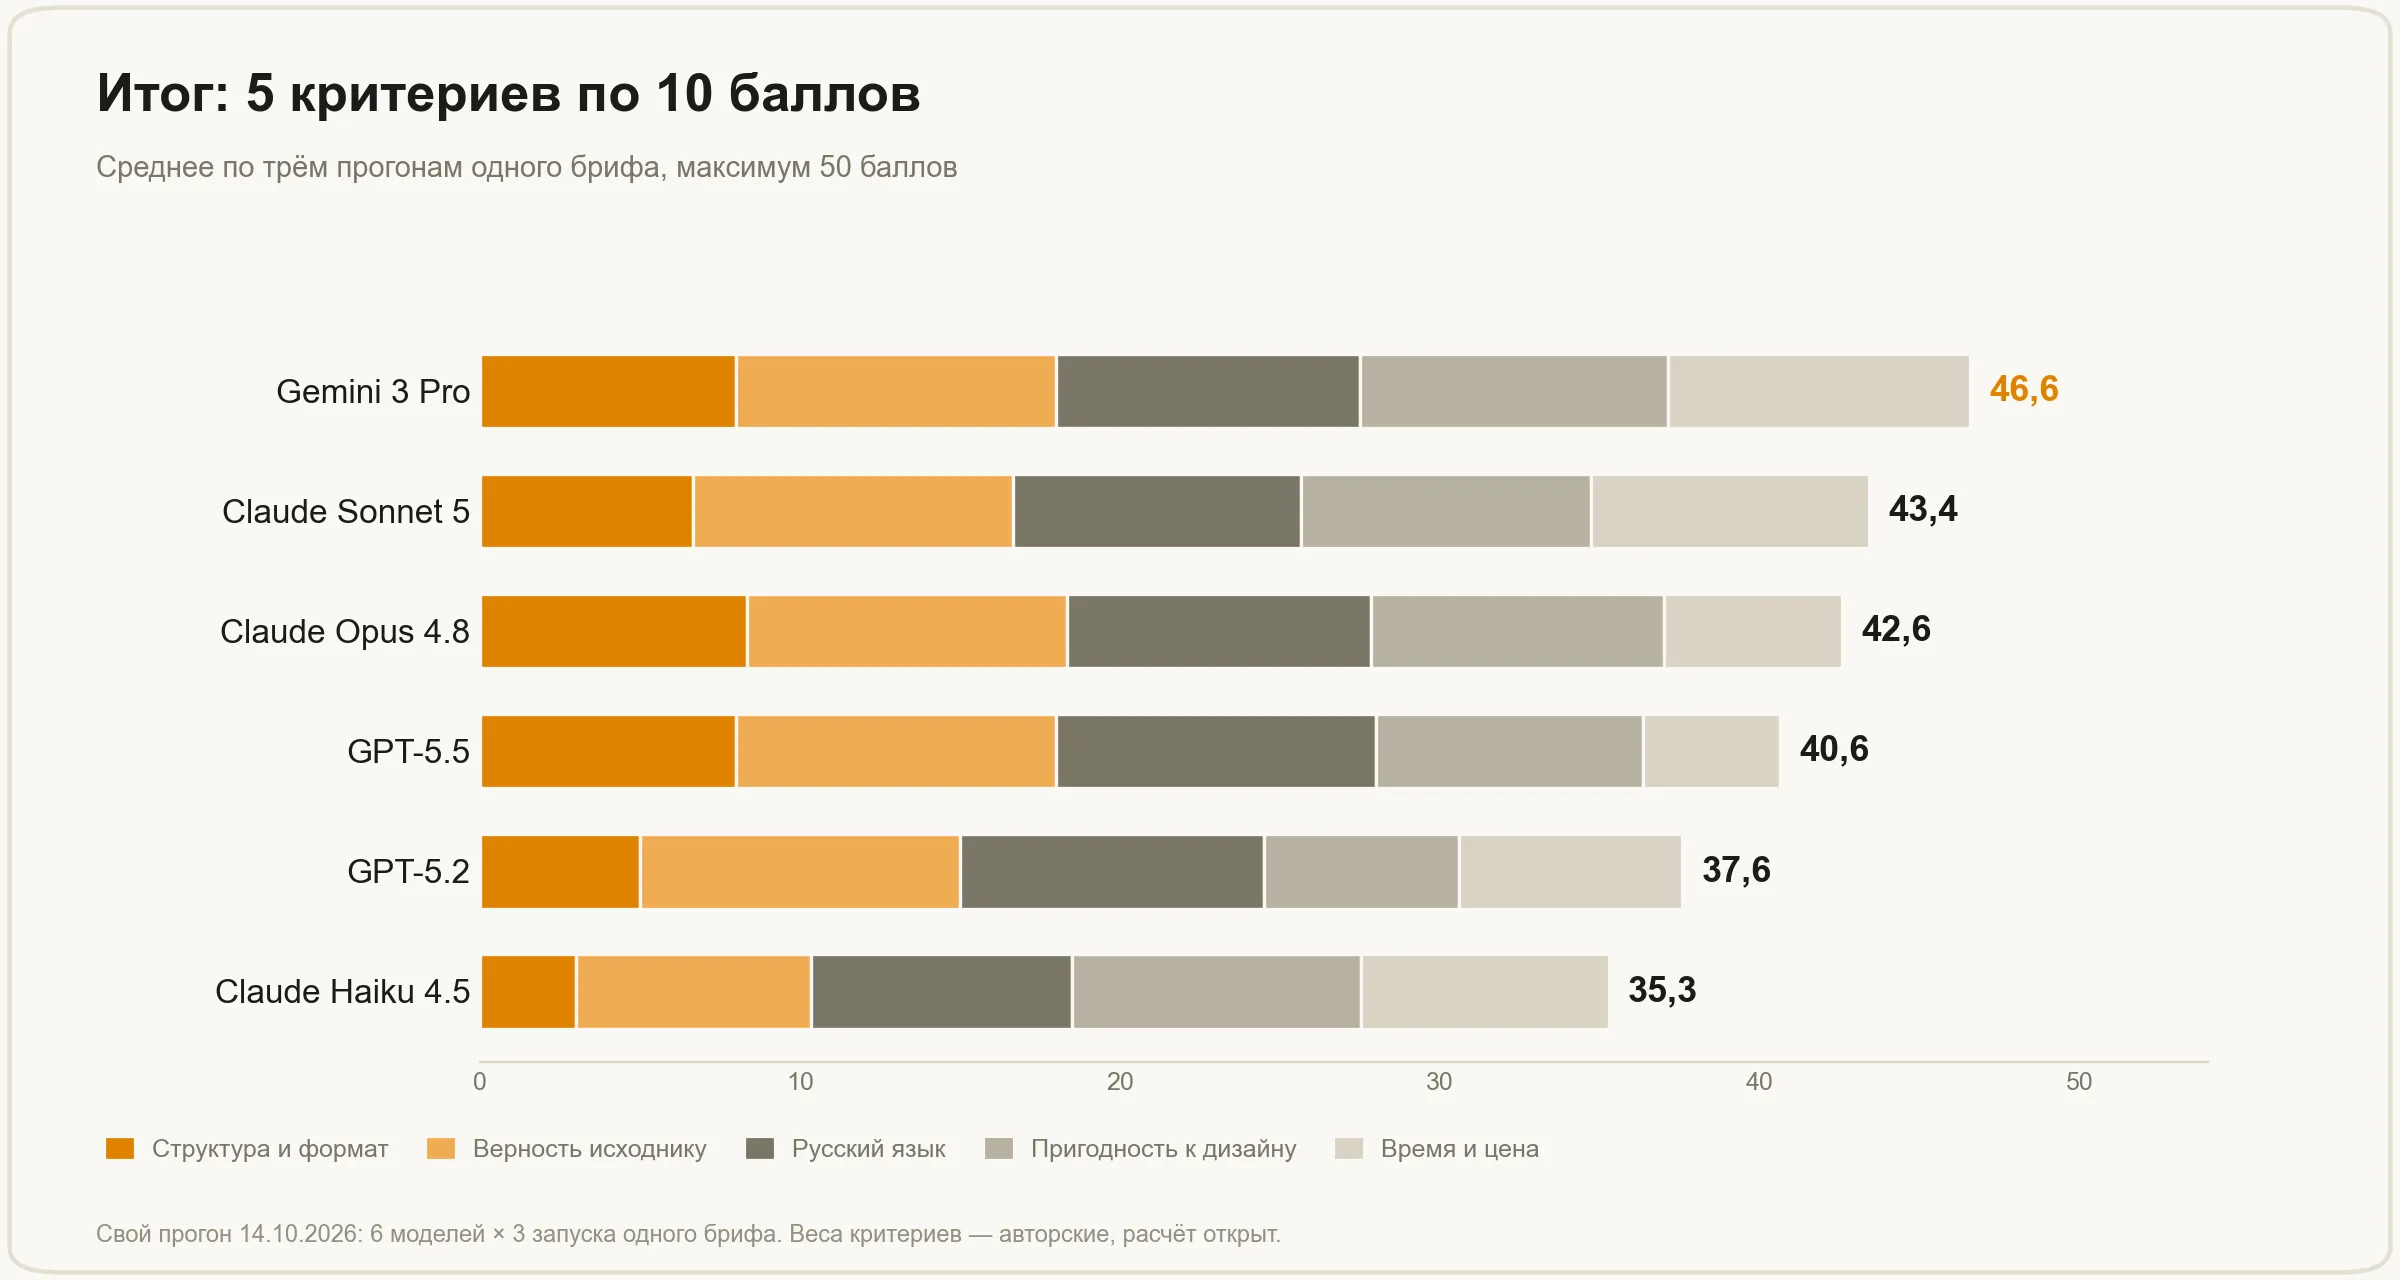
| Модель | Формат | Верность | Язык | Дизайн | Время и цена | Итого |
|---|---|---|---|---|---|---|
| Gemini 3 Pro | 8,0 | 10 | 9,5 | 9,6 | 9,4 | 46,6 |
| Claude Sonnet 5 | 6,7 | 10 | 9,0 | 9,0 | 8,7 | 43,4 |
| Claude Opus 4.8 | 8,3 | 10 | 9,5 | 9,2 | 5,6 | 42,6 |
| GPT-5.5 | 8,0 | 10 | 10,0 | 8,3 | 4,3 | 40,6 |
| GPT-5.2 | 5,0 | 10 | 9,5 | 6,1 | 7,0 | 37,6 |
| Claude Haiku 4.5 | 3,0 | 7,3 | 8,2 | 9,0 | 7,7 | 35,3 |
Разрыв между первым и вторым местом три балла, и почти весь он набран на формате и цене. По качеству текста пять моделей из шести идут почти вровень. Поэтому интереснее не итоговая таблица, а то, на чём именно теряли баллы.
Четыре находки
Послушались формата только двое
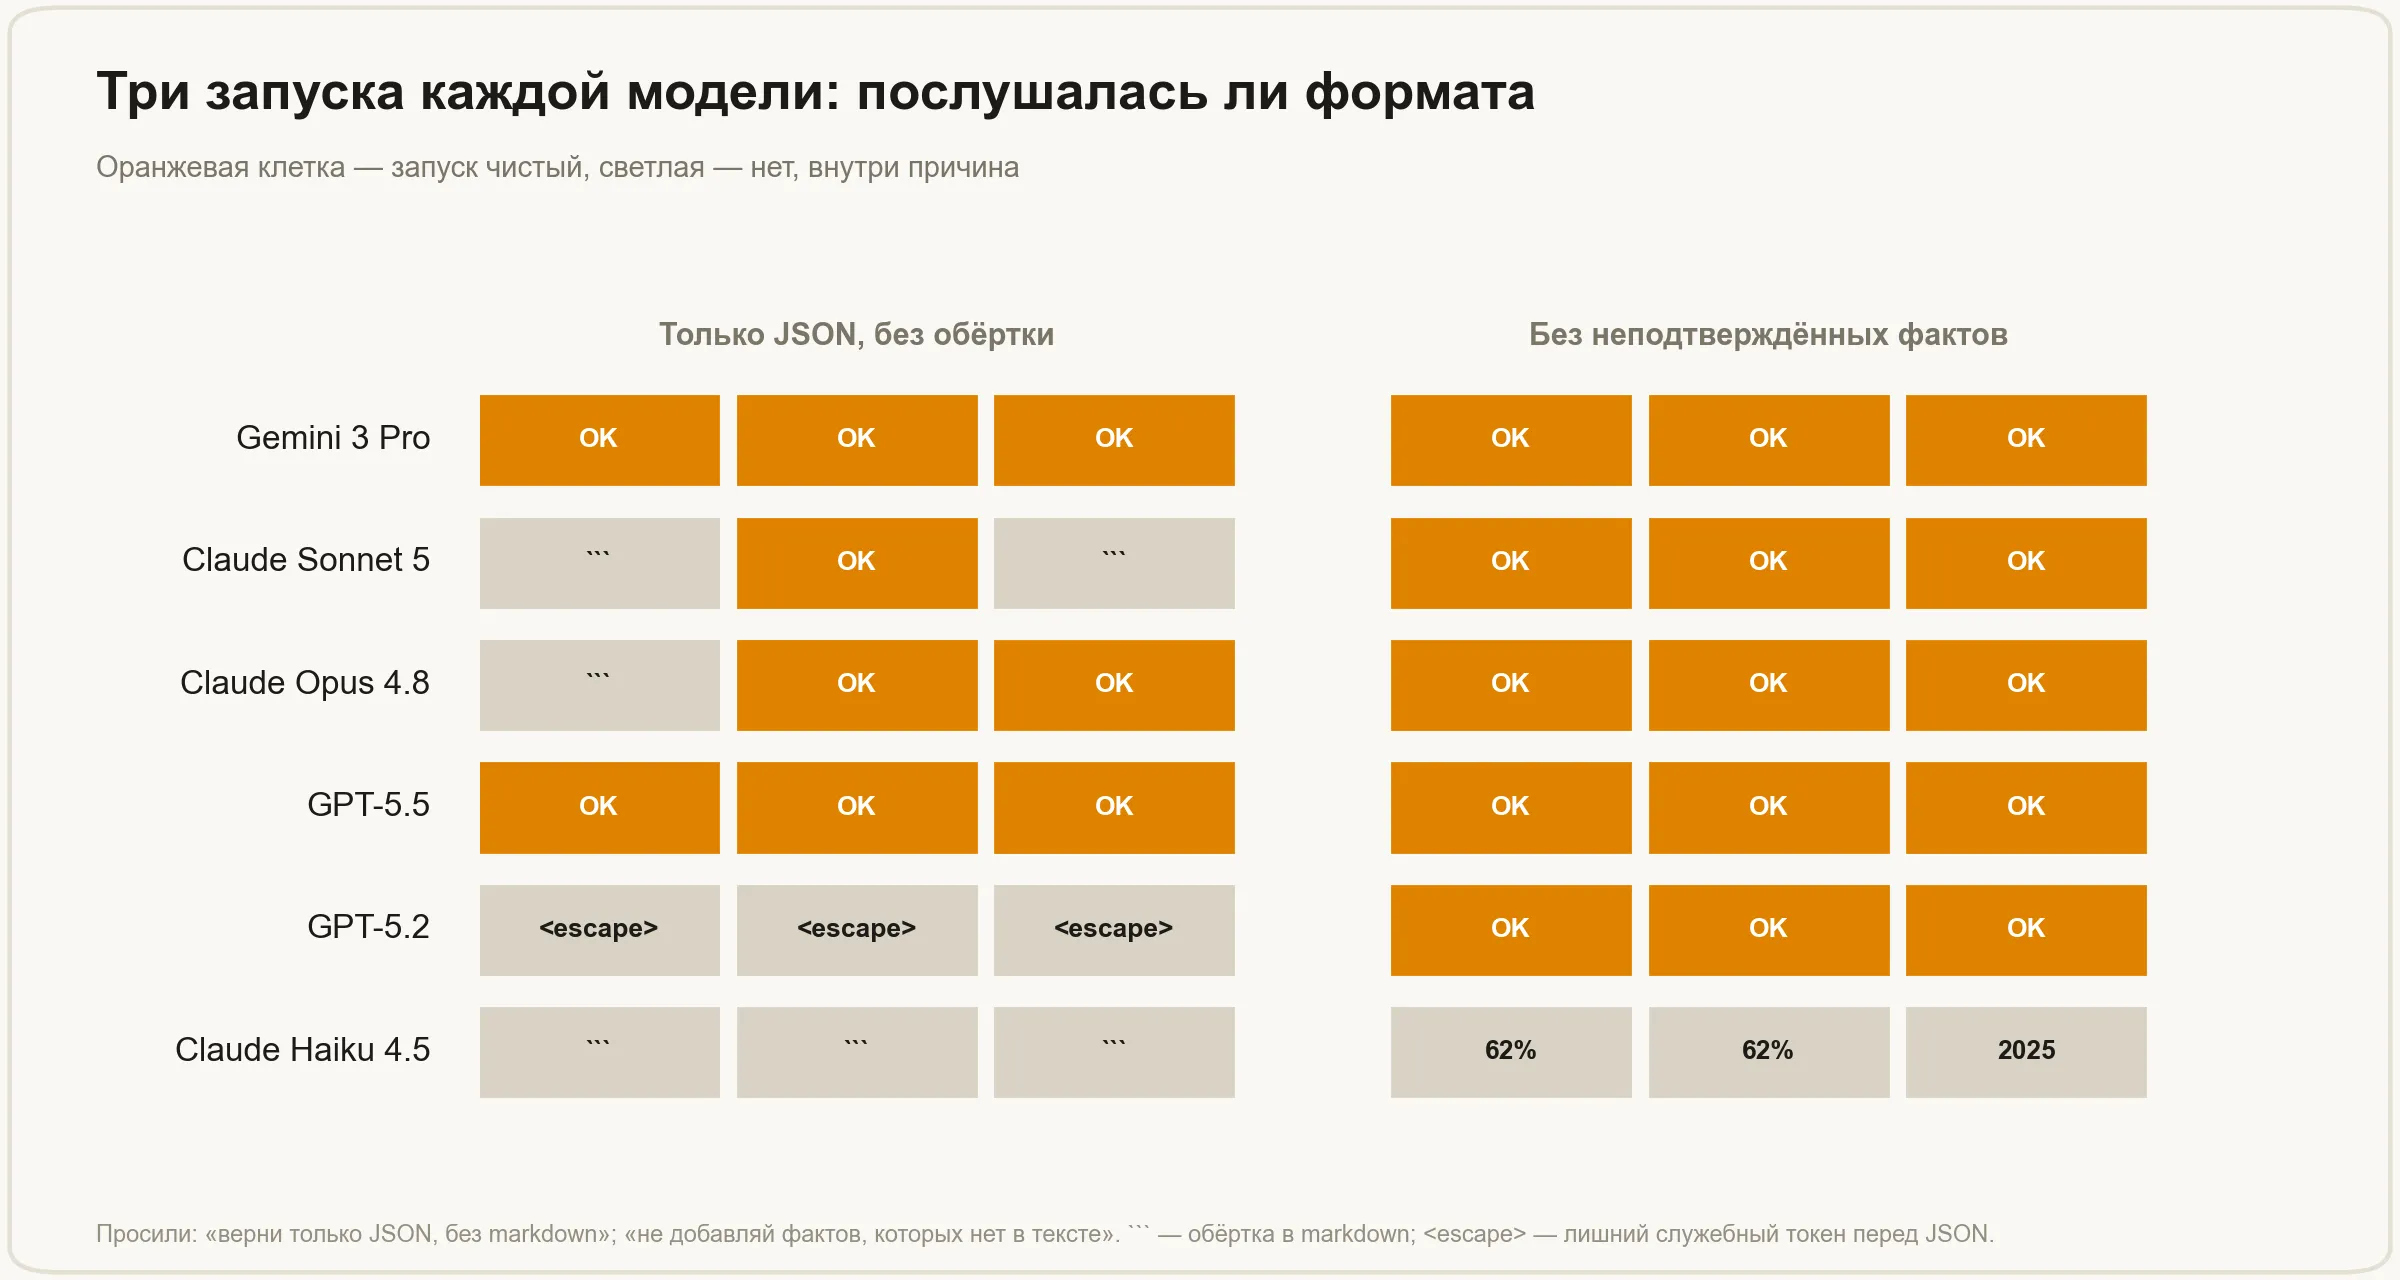
Просили «только JSON, без markdown-обёртки». Чистый JSON три раза из трёх отдали Gemini 3 Pro и GPT-5.5. Claude Opus 4.8 справился в двух запусках из трёх, Sonnet 5 в одном, Haiku 4.5 ни разу: заворачивала ответ в тройные кавычки. У GPT-5.2 другая беда: во всех трёх ответах перед JSON стоял служебный токен <escape>, и строгий разбор ломался.
Если вы читаете ответ глазами в чате, обёртка не мешает. Если подключаете модель к скрипту, который собирает слайды, один лишний символ превращается в ошибку на всём конвейере.
Выдумывала цифры одна модель
Во всех трёх запусках Claude Haiku 4.5 добавила то, чего в тексте не было. Дважды нарисовала круговую диаграмму «38% повторные, 62% новые клиенты». В исходнике есть только доля повторных покупателей, 38%. Вывод про 62% выглядит логичным, но это домысел: покупатели и заказы не одно и то же. В третьем запуске «+31% к прошлому кварталу» превратилось в «+31% к III кварталу 2025»: появился год, которого в тексте нет, и сравнение уехало на год назад.
Остальные пять моделей за 15 запусков не придумали ни одного факта. Они делали верные пересчёты: GPT-5.5 написала «рост на 0,3 процентного пункта» вместо «с 2,6% до 2,9%», Haiku в одном запуске посчитала снижение стоимости привлечения как 11% (465 → 412, это 11,4%). Такое я не считал ошибкой.
Слайд из 61 слова — это не слайд
Самые «разговорчивые» слайды у GPT-5.2: в среднем 33 слова на слайд, самый плотный вышел на 61 слово. Это заголовок и три-четыре тезиса, у которых по два придаточных. У остальных моделей среднее 18–23 слова.
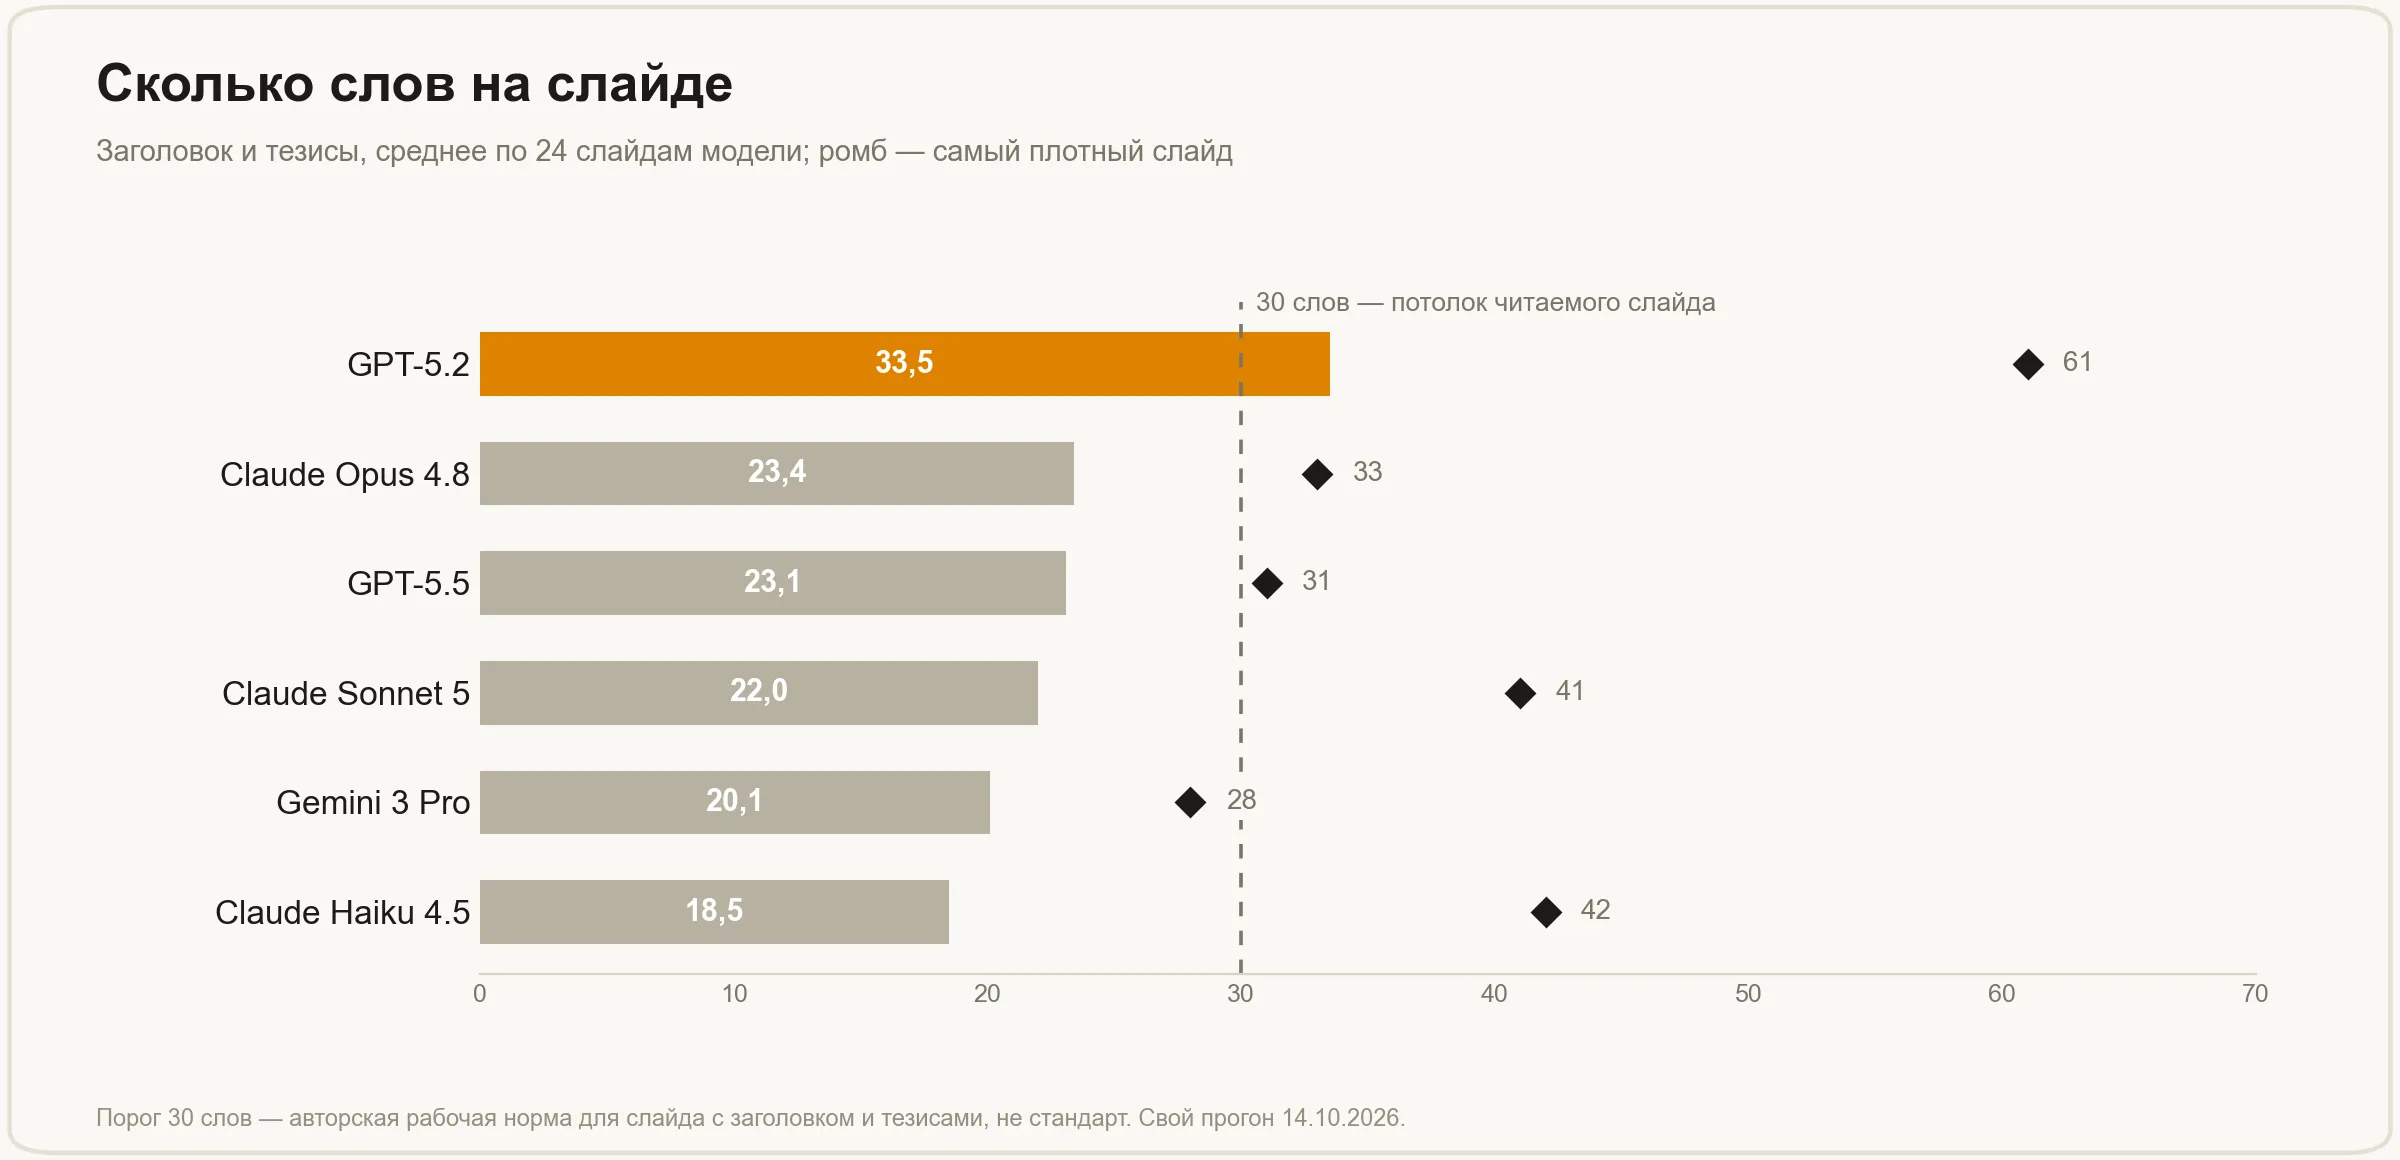
Порог в 30 слов мой рабочий, не стандарт. Но слайд, который докладчик читает вслух, в такой объём не влезает: придётся либо резать, либо показывать мелким шрифтом.
Дорогая модель не дала запаса качества
Один запрос на план презентации стоил от 0,8 до 4,4 кредита шлюза, то есть от 0,4 до 2,2 цента. Самый дорогой ответ у Claude Opus 4.8, самый дешёвый у Claude Haiku 4.5 и Gemini 3 Pro. По качеству на этом коротком брифе Opus не оторвался: у него та же структура и тот же нулевой счёт выдумок, что у Gemini, которая стоит в четыре раза меньше. Дольше всех думала GPT-5.5: 72–84 секунды против медианы 29–38 у остальных. Об условиях замера скажу ниже, секунды надо читать с поправкой.
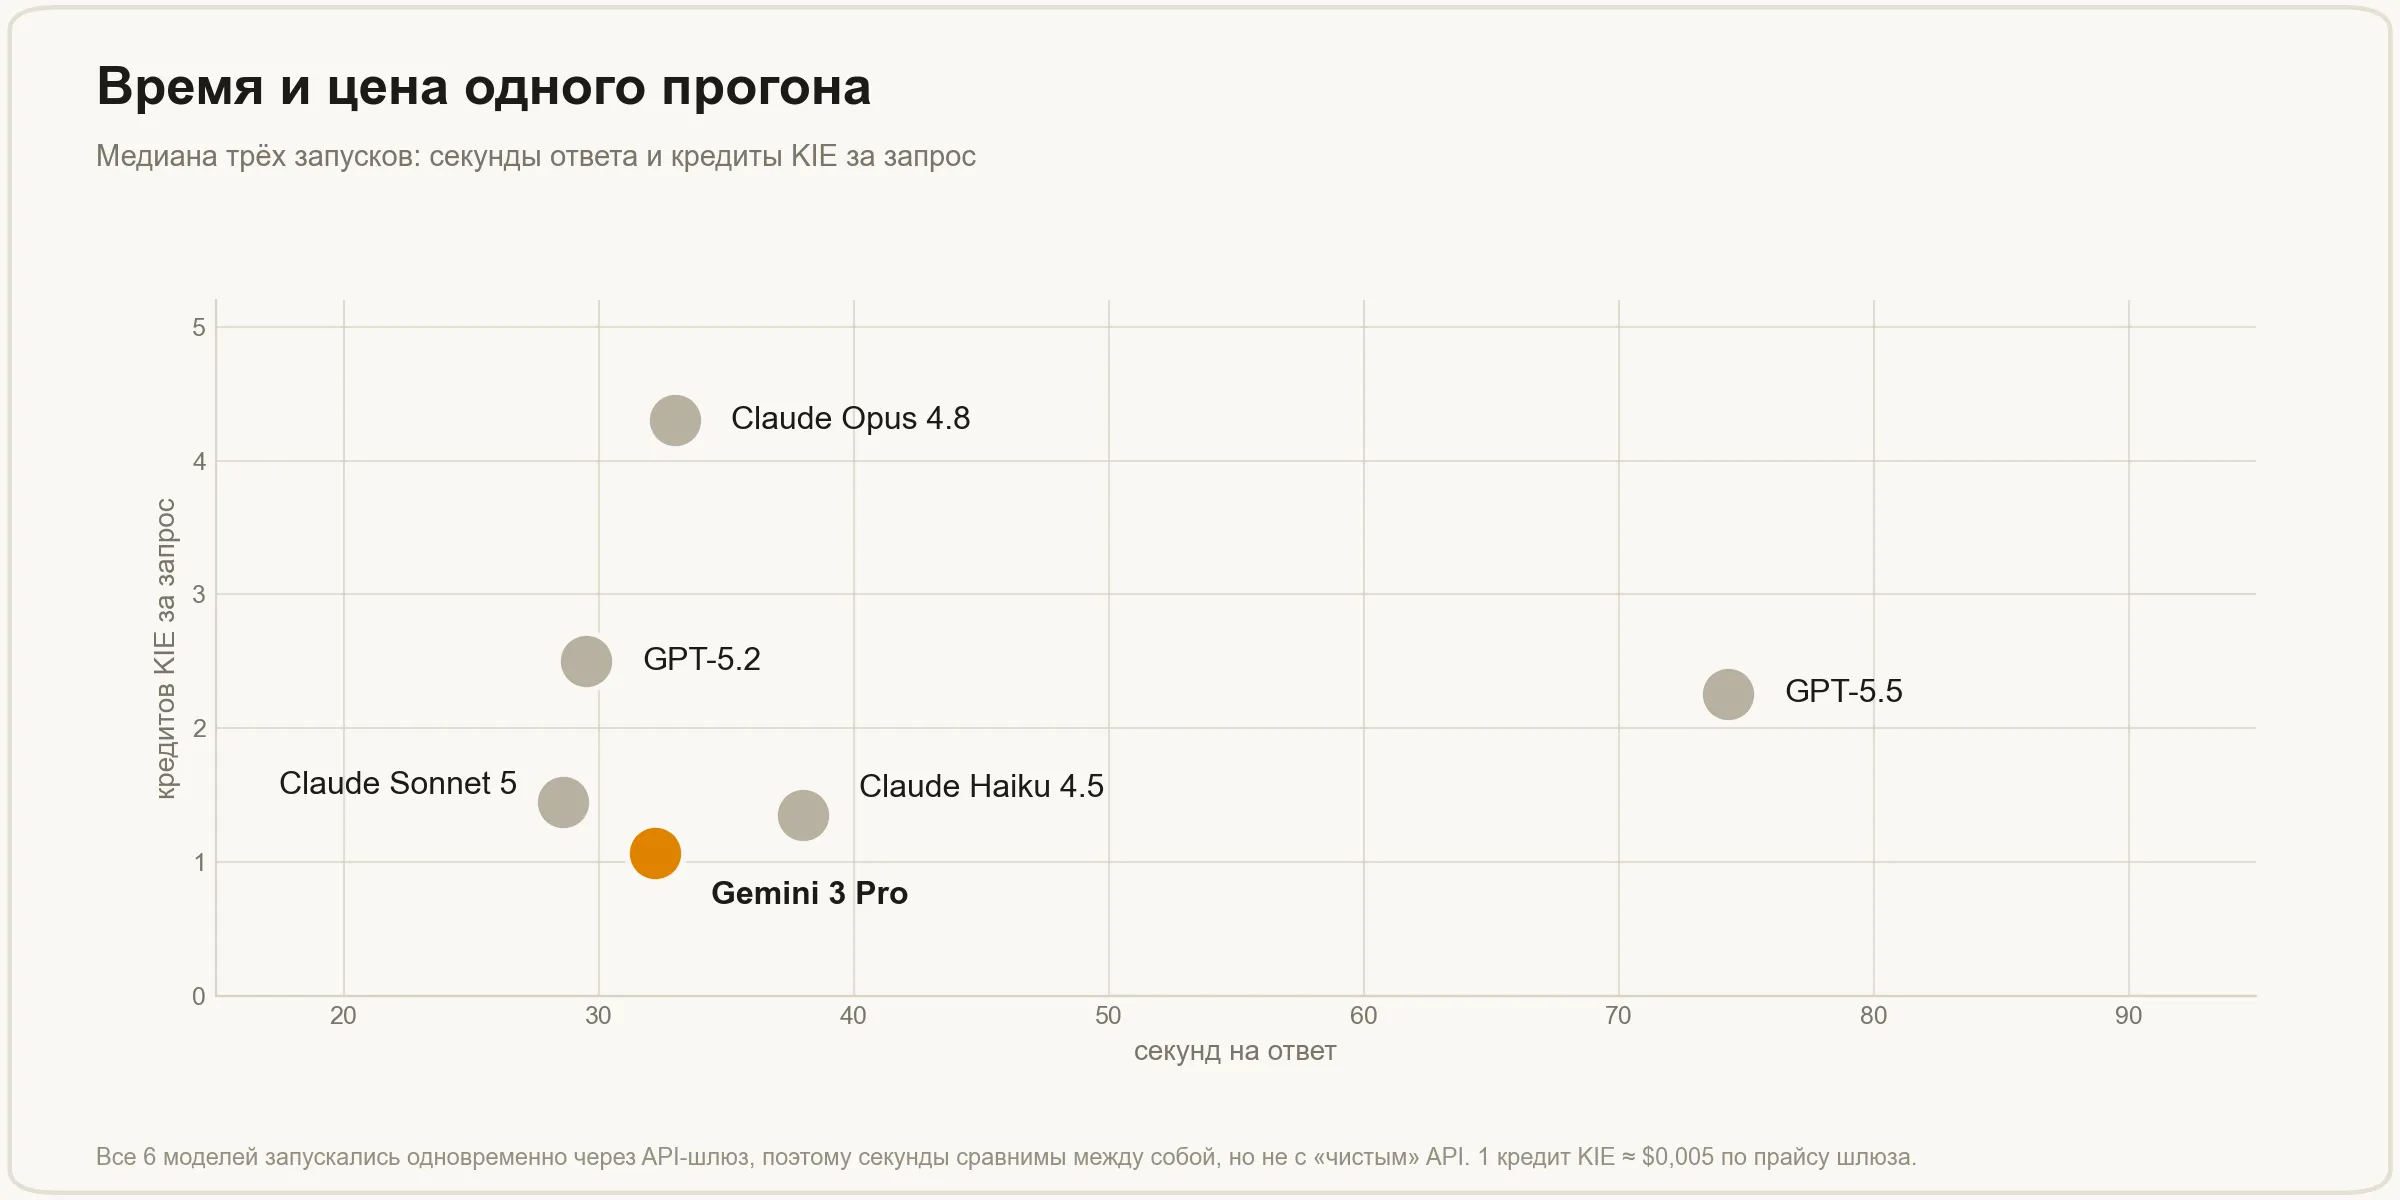
Для такой задачи разница в цене копеечная. Но если гонять сотни презентаций в сутки, четырёхкратная переплата уже заметна, а выигрыша на структуре нет.
Слайд одной картинкой: четыре генератора
Иногда хочется обойтись без дизайнера и попросить картинку-слайд целиком. Я взял один и тот же слайд (заголовок «Возвраты товаров» и два тезиса) и отдал четырём генераторам с просьбой написать текст по-русски «точно как указано».
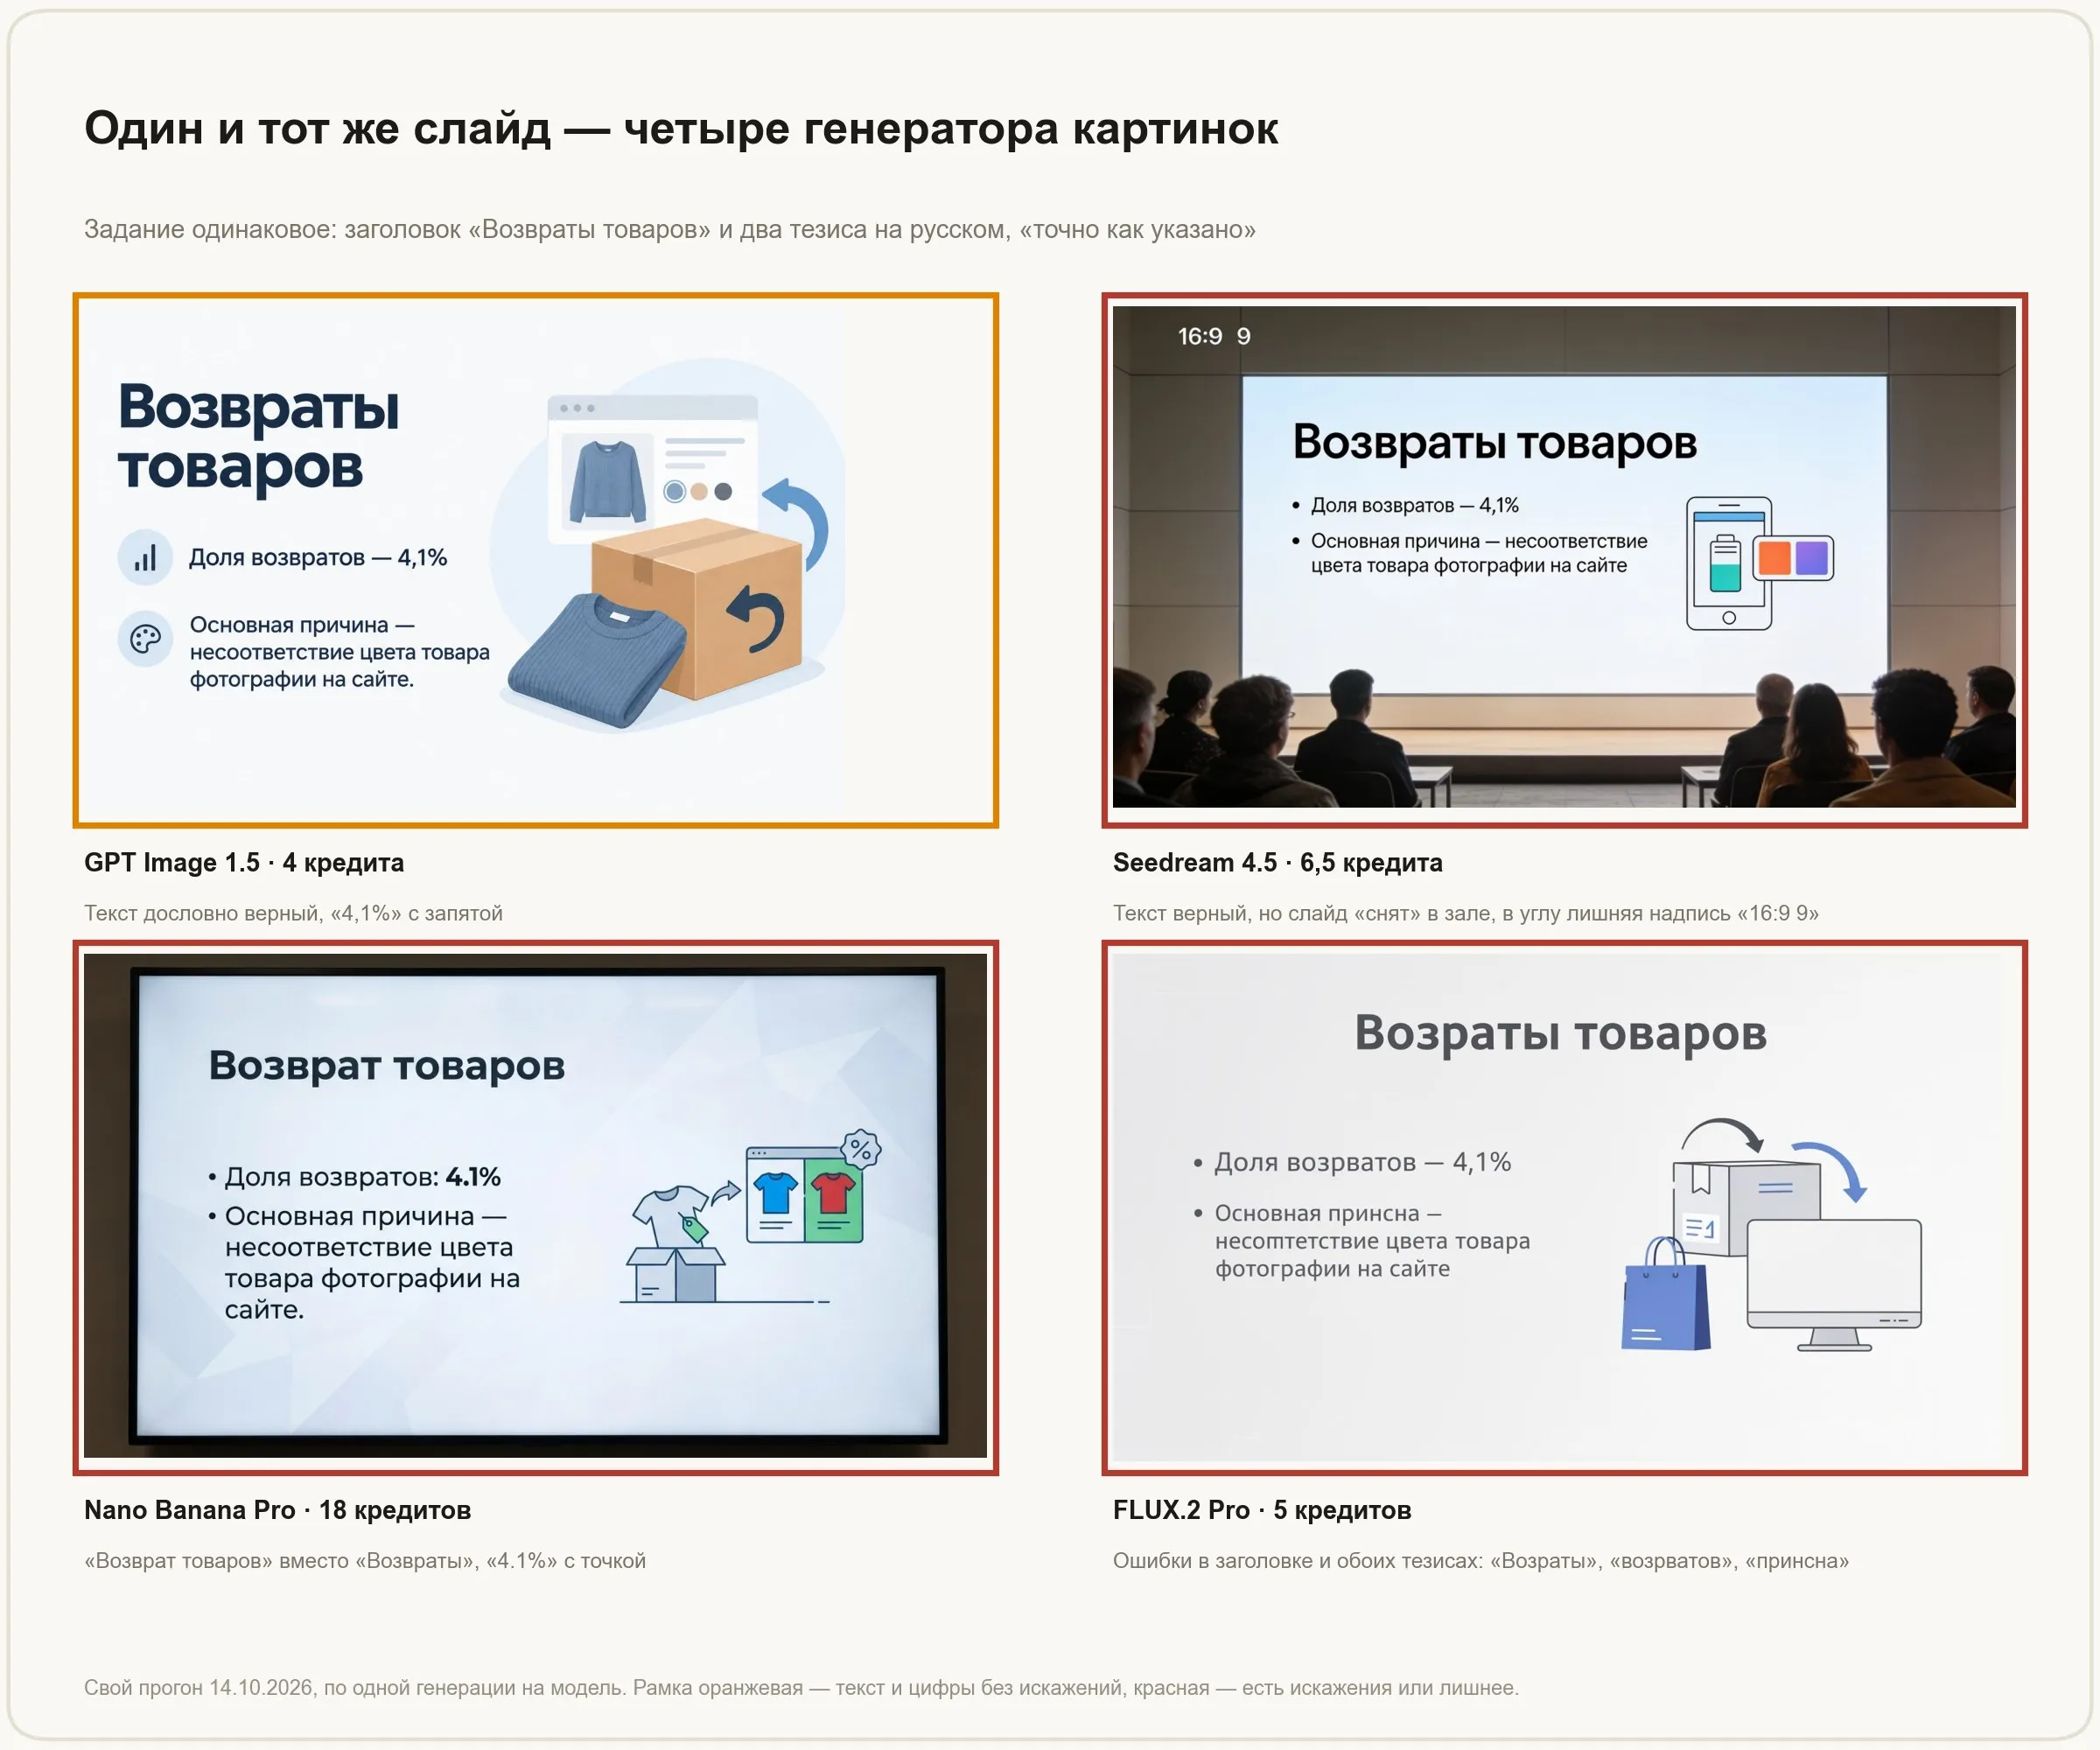
Итог по одной генерации на модель:
- GPT Image 1.5 написал текст дословно, «4,1%» с запятой. 4 кредита.
- Seedream 4.5 текст не исказил, но нарисовал не слайд, а фото зала с экраном, и в углу появилась надпись «16:9 9».
- Nano Banana Pro стоил дороже всех, 18 кредитов, и поменял заголовок на «Возврат товаров», а «4,1%» превратил в «4.1%» с точкой.
- FLUX.2 Pro сделал ошибки в заголовке и обоих тезисах: «Возраты», «возрватов», «принсна».
Выборка маленькая, одна картинка на модель. Но для деловой презентации, где одна опечатка в цифре обходится дороже красоты, вывод ясен: проверяйте каждую букву. Картинку-слайд ещё и не отредактировать: поправить одну цифру можно только перегенерацией, и тогда остальное тоже изменится.
Картинка по описанию: где генератор выдумывает цифры
В JSON каждая модель дала поле «что нарисовать». Я взял описания слайда про возвраты и отправил их генератору картинок как есть. Здесь вылезла самая неприятная находка всего теста.
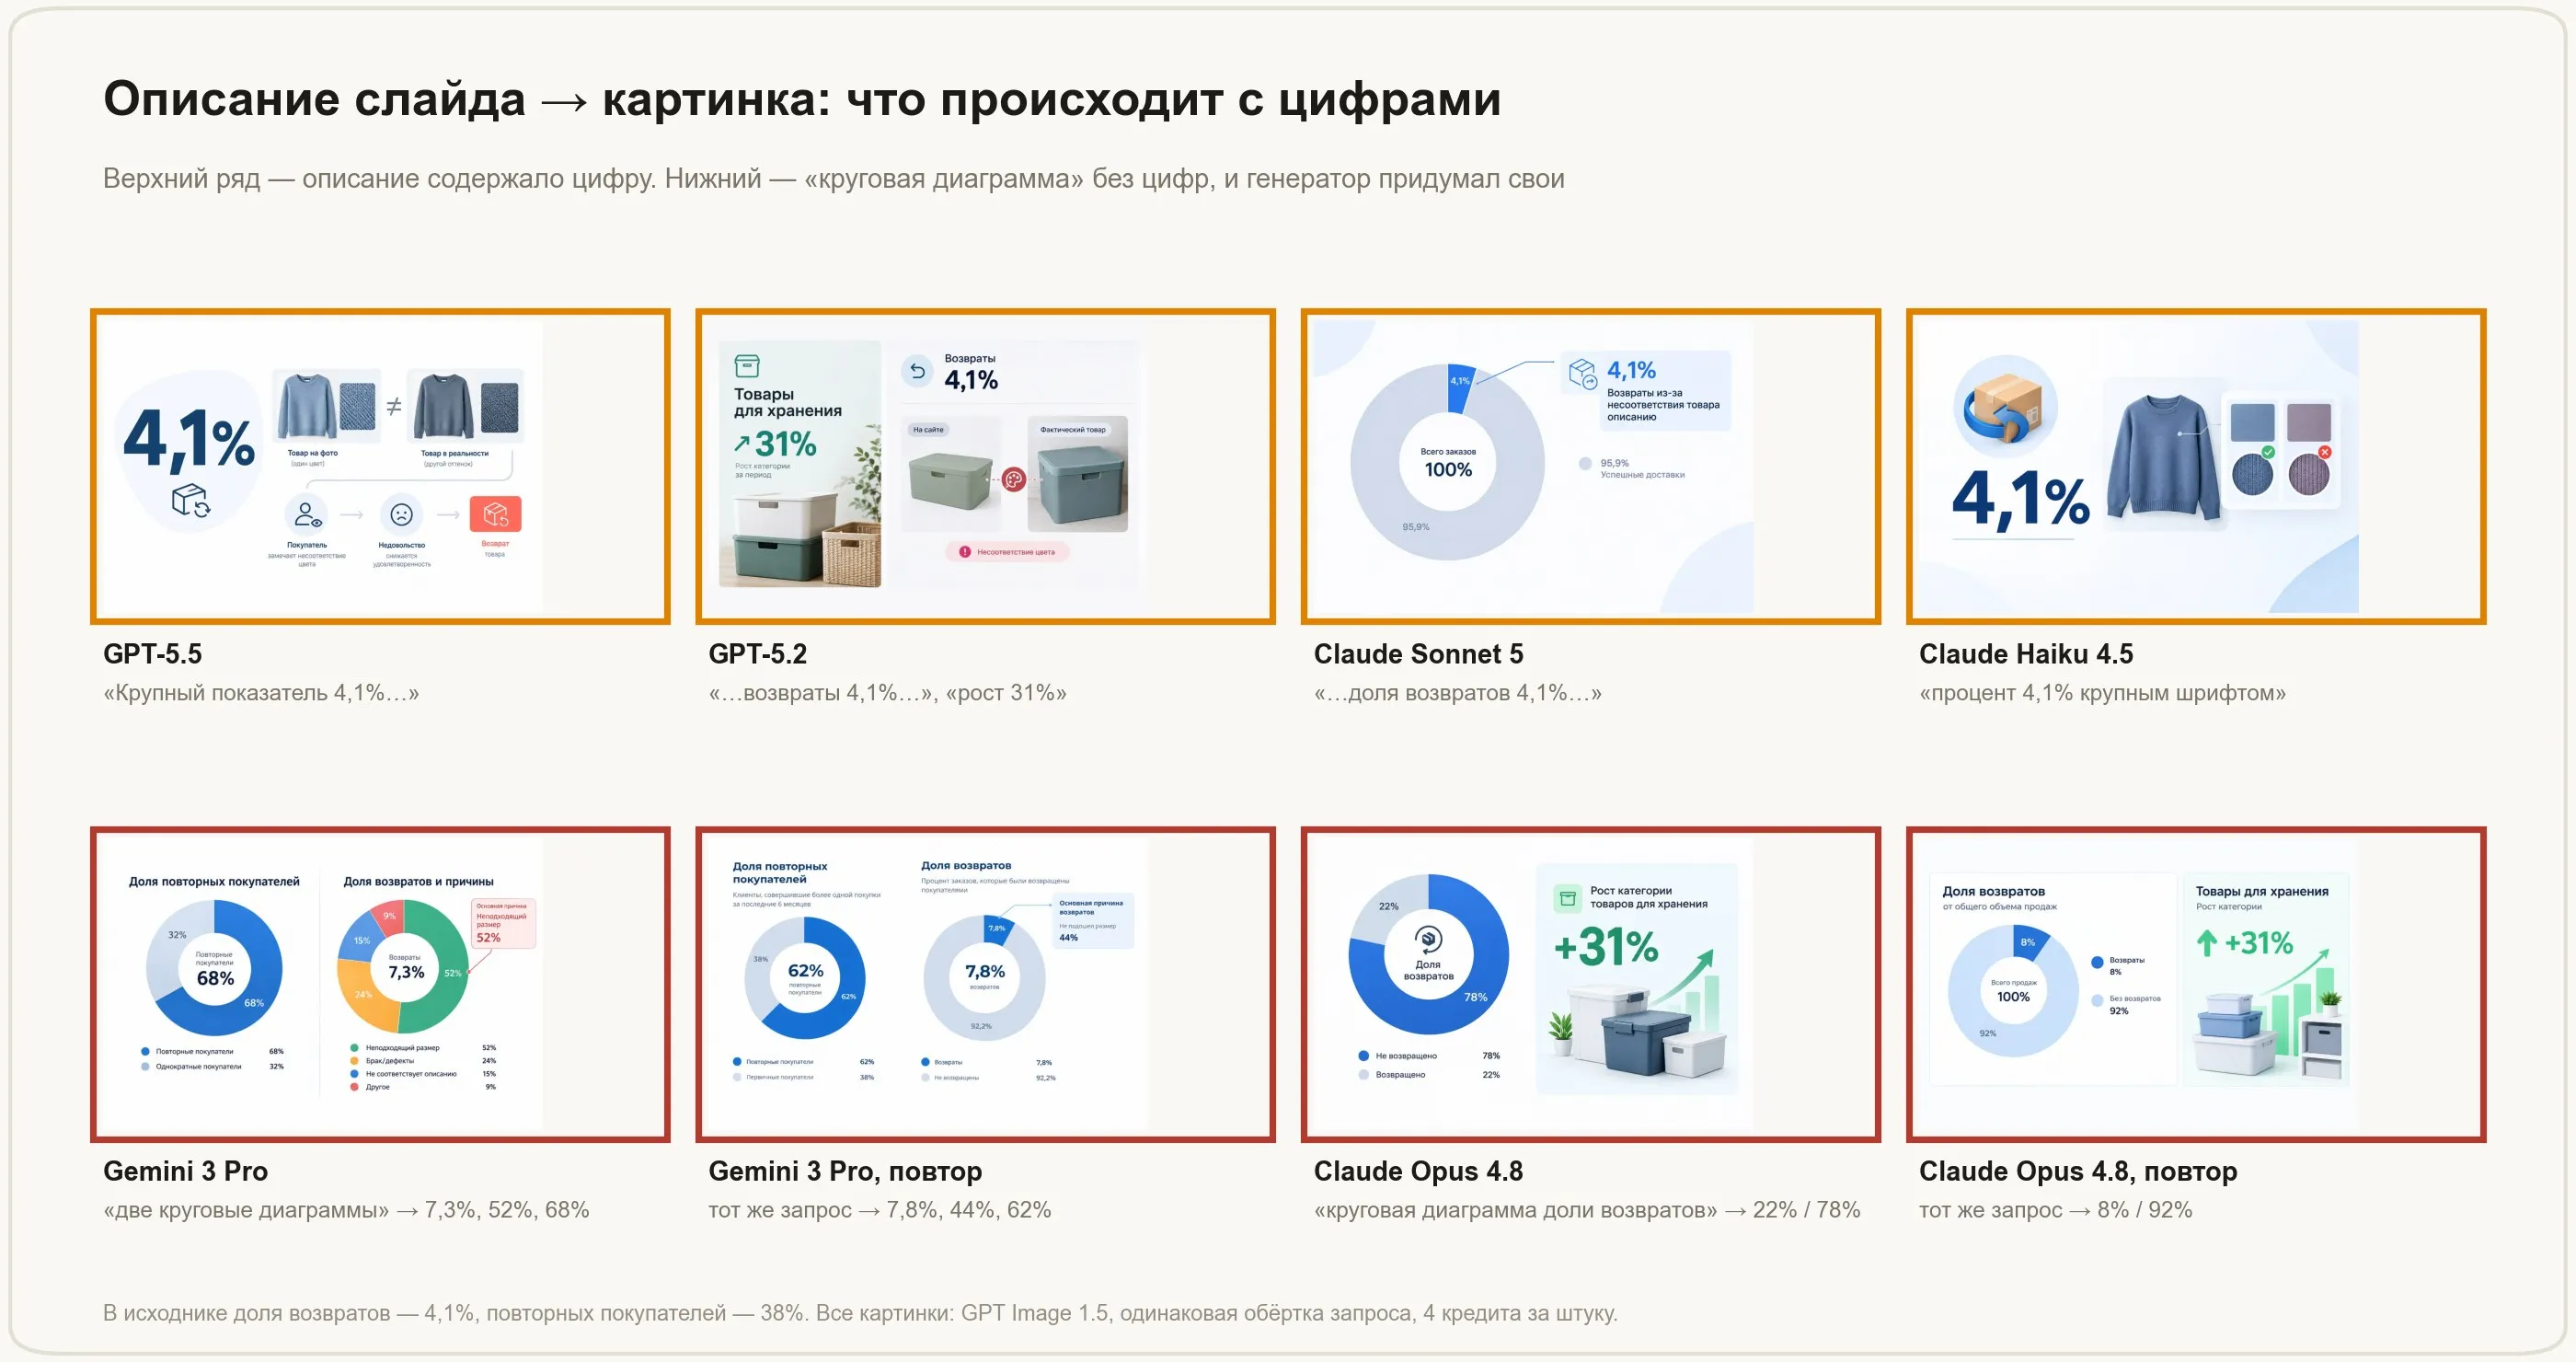
Если в описании стояла цифра («крупный показатель 4,1%»), картинка её повторяла. Если описание просило «круговую диаграмму доли возвратов» без числа, генератор придумывал свои. Gemini 3 Pro получила «68% повторных покупателей» при реальных 38% и «7,3% возвратов» при реальных 4,1%. Claude Opus 4.8 нарисовала «22% и 78%». Я повторил оба запроса: цифры снова оказались другими (62% и 7,8% у Gemini, 8% и 92% у Opus), но выдуманными опять.
Пострадали Gemini 3 Pro и Opus 4.8: не потому что хуже, а потому что их описания не называли числа. Заодно видно слабое место моей таблицы: критерий «пригодность к дизайну» оценивал форму описания, но не то, что из него получится. Правило простое: в просьбе нарисовать диаграмму всегда пишите цифры сами или просите «без подписей и чисел», а готовый график лучше построить по данным, не отдавая цифры генератору картинок.
Какую нейросеть выбрать для презентации
Тест один, бриф короткий, поэтому это ориентиры, а не приговор.
Если ответ нужно подать скрипту, берите Gemini 3 Pro или GPT-5.5: оба три раза отдали чистый JSON на 8 слайдов. С остальными добавляйте в код очистку от обёрток и служебных токенов.
Если вы читаете ответ сами в чате, формат не критичен, и Claude Sonnet 5 (43,4 балла) почти не уступает лидеру: лаконичные слайды, цена ненамного выше.
Платить за дорогую модель на коротком отчёте не стоит: на таком брифе Claude Opus 4.8 не дала преимущества, которое оправдало бы цену. На длинных документах и сложных таблицах результат может быть другим, я это не проверял.
Самая лёгкая Claude Haiku 4.5 годится для первого черновика, если вы сами сверите каждую цифру с исходником.
Если думаете заменить слайд картинкой: из четырёх проверенных только GPT Image 1.5 не исказил русский текст. Но слайд-картинка не редактируется, поэтому для рабочей презентации надёжнее собрать слайд в редакторе, а генератор использовать для иллюстраций.
Если задача целиком про деловой документ, посмотрите ещё нейросеть для отчёта: она собирает структуру и тезисы из ваших цифр.
Как повторить тест на своём тексте
Заводить десять аккаунтов не нужно. В Veruna AI несколько нейросетей собраны в одном окне: ChatGPT, Claude, Gemini, DeepSeek, Grok и другие, без VPN и с оплатой в рублях. Один и тот же запрос можно отправить разным моделям и сравнить ответы рядом. Начать можно бесплатно, актуальные условия смотрите на сайте.
Порядок такой:
- Возьмите свой текст: отчёт, питч, описание проекта.
- Отправьте его двум-трём моделям с одним и тем же запросом: «Сделай план презентации на 8 слайдов по тексту ниже. Для каждого слайда: заголовок до 8 слов, до трёх тезисов по 12 слов, что сказать вслух, что нарисовать, с цифрами из текста. Не добавляй фактов и цифр, которых нет в тексте».
- Сверьте числа: выпишите все цифры из ответа и найдите каждую в исходнике. Всё, чего там нет, вычёркивайте.
- Проверьте длину слайдов. Больше 30 слов — просите сократить.
Я гонял тест не через чат Veruna, а через API, но запрос и проверка работают одинаково.
Что в тесте не проверено
- Бриф один и короткий. Длинный документ или таблица могут расставить модели иначе.
- Три запуска на модель — это не статистика, а разведка. Картинки генерировались по одному разу, кроме двух повторов.
- Запросы шли через API-шлюз, а не напрямую к разработчикам. В ответах Claude был виден учёт служебного контекста шлюза, а в ответе GPT-5.5 значилась системная инструкция «агента для кода», которую я не задавал. Это могло повлиять на время и стиль, поэтому секунды сравнимы только внутри теста. Модели запускались одновременно, чтобы условия были равными.
- В тесте нет Grok, DeepSeek, Qwen и российских моделей: через этот шлюз они были недоступны, подставлять другие я не стал. Gemini 3 Pro — не самая новая версия линейки.
- Веса критериев мои. Если вам важнее цена, чем формат, порядок мест изменится. Исходные данные и расчёт можно пересчитать под себя.
- Сборка в PowerPoint и работа сервисов вроде Gamma не проверялись.
Частые вопросы
Какая нейросеть лучше для презентаций? Зависит от того, что вы поручаете. Для содержания слайдов в нашем тесте лучше всего показала себя Gemini 3 Pro: чистый формат, короткие слайды, ни одной выдуманной цифры. Оформлением занимается другой инструмент: модель пишет текст и описывает картинки, а собирает слайды редактор или сервис.
Почему нейросеть добавляет в презентацию цифры, которых не было? Модель дополняет логичным: если повторных покупателей 38%, она может «досчитать» остальные 62% как новых. Для текста это домысел. Помогает запрет в запросе («не добавляй фактов, которых нет в тексте») и ручная сверка каждого числа с исходником. В нашем тесте запрет сработал у пяти моделей из шести.
Можно ли попросить нейросеть сразу нарисовать слайд? Можно, но проверяйте текст по буквам. Из четырёх протестированных генераторов без ошибок русский текст написал один, остальные меняли слова, подставляли точку вместо запятой или рисовали лишнее. Поправить одну цифру в такой картинке нельзя без новой генерации.
Сколько стоит сделать презентацию нейросетью? Текстовый план в нашем тесте стоил от 0,8 до 4,4 кредита шлюза за запрос, то есть доли цента и пара центов. Картинка слайда обошлась в 4–18 кредитов, от 2 до 9 центов. Условия в разных сервисах отличаются, тарифы в Veruna актуальны на сайте.