
Кратко
- Muse Spark 1.3 вышла 2 сентября 2026 года. Это закрытая модель Meta (Meta признана экстремистской организацией, её деятельность запрещена на территории РФ), доступная через API компании, консольный агент Muse Code и сторонние роутеры.
- Контекстное окно 1 048 576 токенов, максимальная длина одного ответа — 943 718 токенов. Второй параметр у модели уникальный: у флагманов OpenAI и Anthropic лимит ответа в семь с лишним раз меньше.
- Главная цифра релиза — 75,4% на DeepSWE v1.1, тесте на правки в реальных кодовых базах. Это самоотчёт Meta: на публичном лидерборде теста результата Muse Spark 1.3 нет до сих пор, спустя двадцать дней после релиза.
- В собственной карточке модели из одиннадцати строк Muse Spark 1.3 выигрывает четыре, одну играет вничью и шесть проигрывает. Формулировка «новый лидер» держится на четырёх строках из одиннадцати.
Muse Spark 1.3 — новая большая языковая модель Meta, и на запрос «muse spark 1.3 что это» короткий ответ такой: это закрытая флагманская модель для кода и долгих агентных задач, пришедшая на смену Muse Spark 1.2 через четыре недели после неё. Meta признана экстремистской организацией, её деятельность запрещена на территории РФ, поэтому дальше речь пойдёт только о самой модели и о том, как она доступна через API. Ниже — характеристики, реальные цифры по бенчмаркам и отдельный честный разбор того, почему громкий результат на DeepSWE пока нечем подтвердить.
Что такое Muse Spark 1.3
Muse Spark 1.3 — третья модель линейки Muse Spark за три месяца: 1.1 вышла в июле 2026 года, 1.2 — 5 августа, 1.3 — 2 сентября. Темп по меркам рынка высокий, и это важно для понимания характера обновления: за четыре недели архитектуру не переделывают, меняют обучение и настройки.
Идентификатор модели в API Meta — muse-spark-1.3, на OpenRouter она называется meta/muse-spark-1.3, а канонический слаг с датой выглядит как meta/muse-spark-1.3-20260902. Если важно, чтобы поведение не менялось между прогонами, пинить стоит датированный слаг: короткий идентификатор остаётся тем же, а модель под ним обновляется.
Веса модели закрыты. Meta в разделе планов на будущее упоминает «релиз открытых весов Muse Spark», но без версии и без даты. Похожая строка была и в планах к версии 1.2, весов по ней так и не вышло. Читать эту фразу как анонс открытых весов 1.3 нельзя.
Характеристики Muse Spark 1.3
| Параметр | Значение |
|---|---|
| Идентификатор в API | muse-spark-1.3 |
| Дата выхода | 2 сентября 2026 года |
| Контекстное окно | 1 048 576 токенов |
| Максимальный ответ | 943 718 токенов |
| Вход | текст, изображения, файлы, аудио, видео |
| Выход | только текст |
| Дата знаний | не раскрыта |
| Режим рассуждений | всегда включён, шесть уровней: minimal, low, medium, high, xhigh, max; по умолчанию medium |
| Цена ввода | $1,25 за млн токенов |
| Цена вывода | $4,25 за млн токенов |
| Чтение из кэша | $0,15 за млн токенов |
| Доступность | Meta Model API, консольный агент Muse Code, OpenRouter, Vercel AI Gateway |
| Открытые веса | нет |
Контекст в миллион с небольшим токенов — это примерно полторы тысячи страниц текста за один заход, столько же, сколько у GPT-6 Astra и Claude Fable 5.1. А вот лимит ответа у Muse Spark 1.3 действительно выделяется.
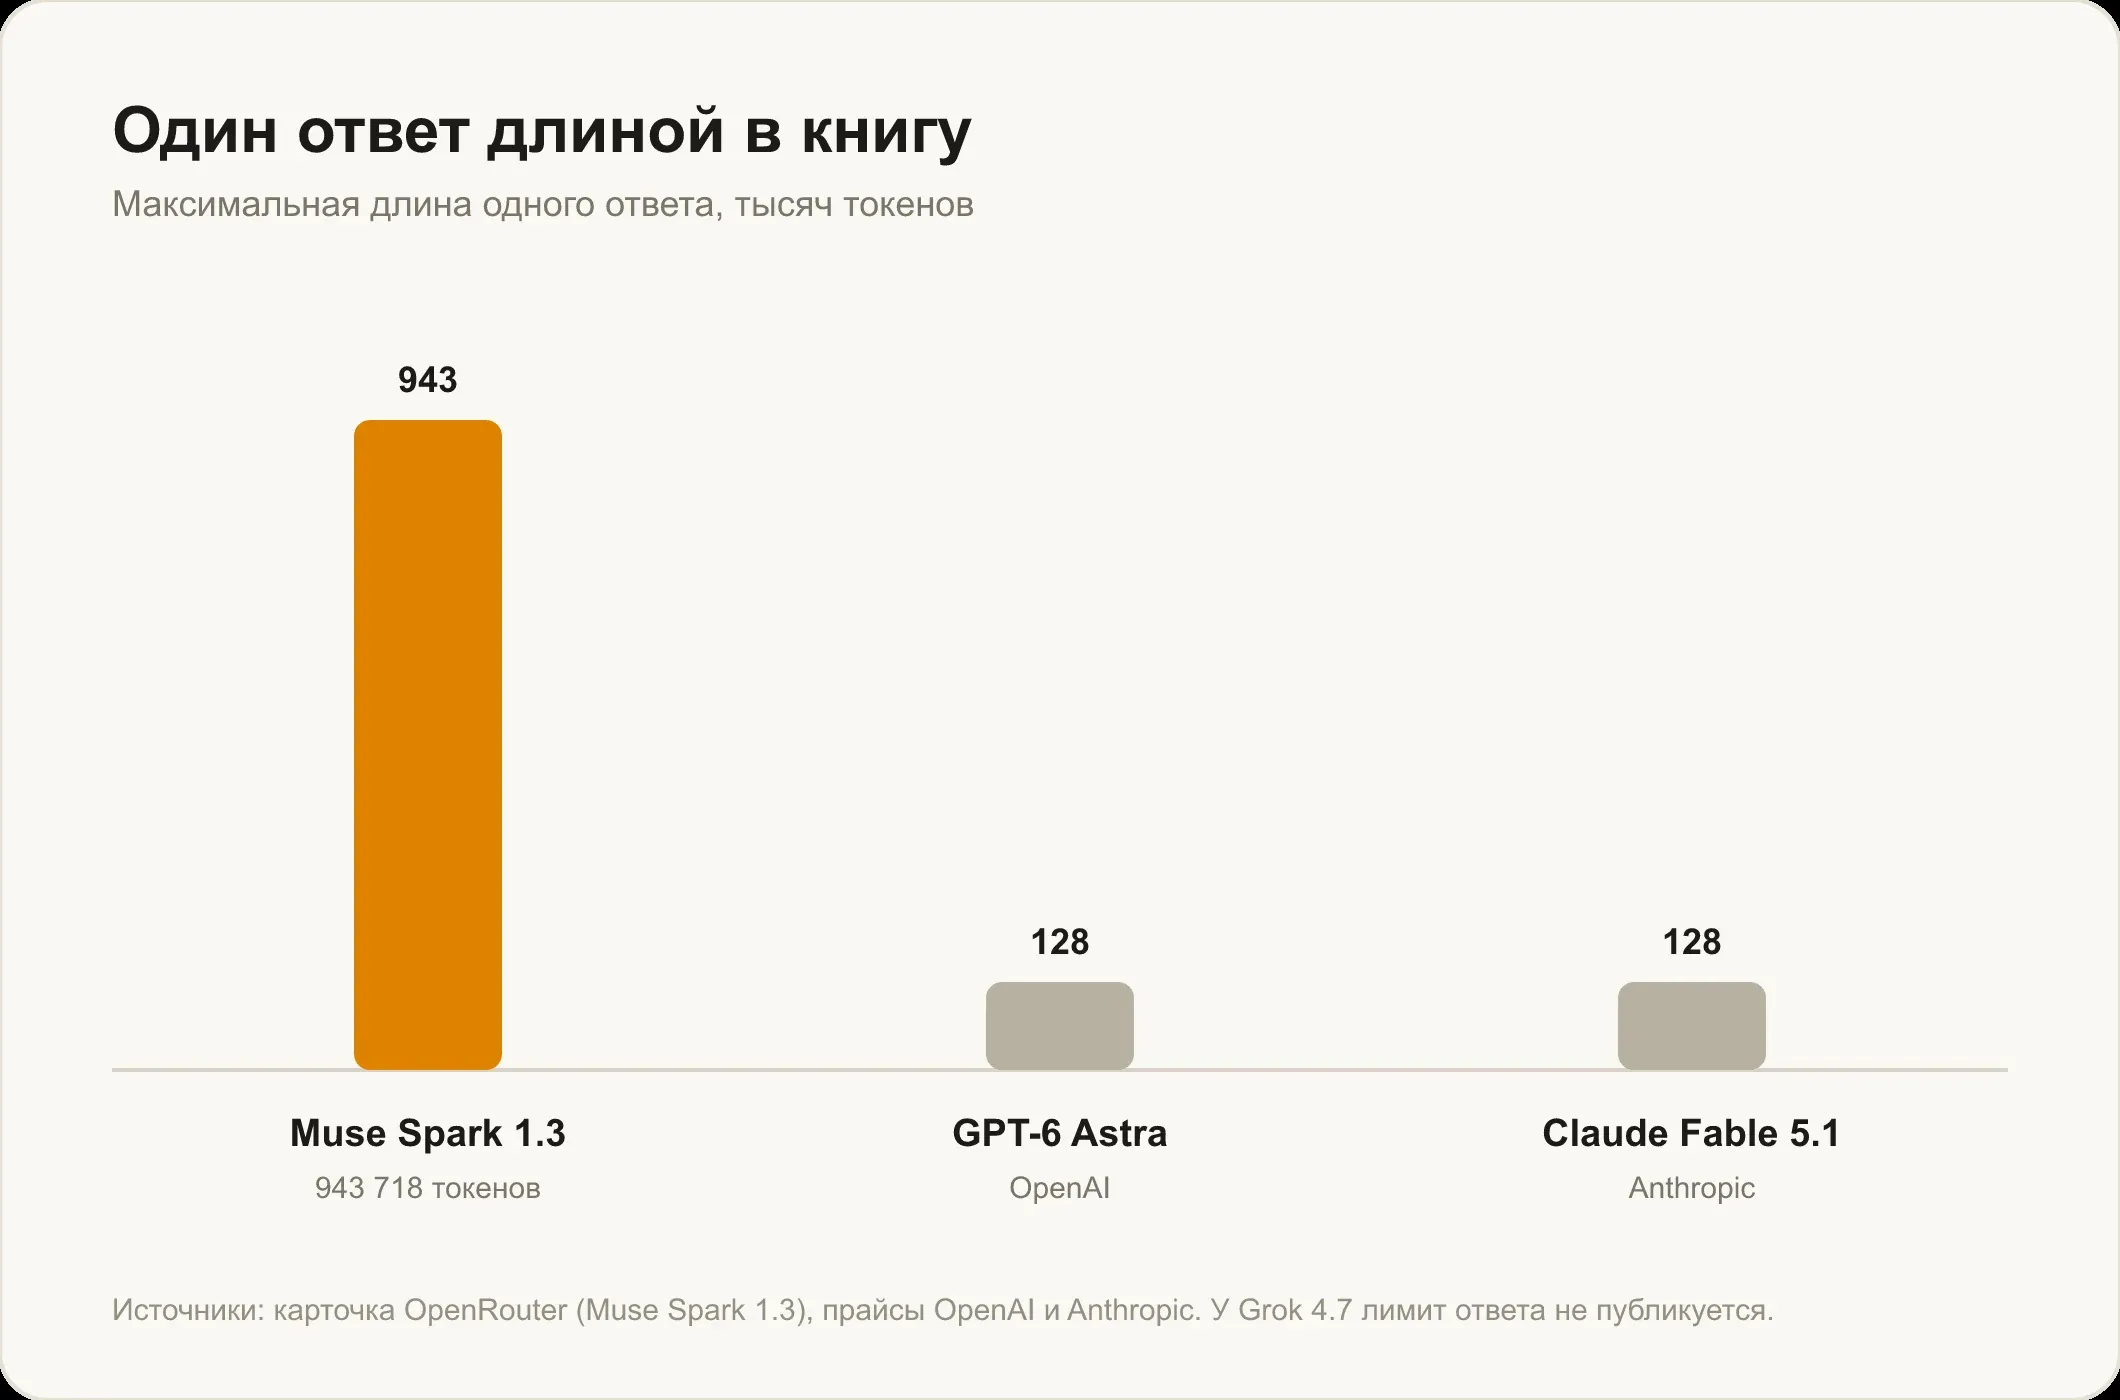
943 718 токенов в одном ответе — это книга среднего размера за один вызов, без нарезки на части и склейки. У Astra и Fable 5.1 потолок 128 тысяч, то есть разница больше чем в семь раз. Оговорка: саму цифру публикует карточка OpenRouter, в материалах Meta её нет.
Отдельная особенность, на которую стоит обратить внимание: рассуждения у модели отключить нельзя. Уровней глубины шесть, от minimal до max, по умолчанию стоит medium. Верхний уровень max на старте был закрыт и работал только у партнёров, Meta открыла его 4 сентября. Поэтому обзоры, написанные в первые дни сентября, описывают ситуацию, которой уже нет.
Мультимодальность заявлена широкая: на входе текст, картинки, файлы, аудио и видео. Но в карточке модели на OpenRouter висит предупреждение, что понимание аудио поддержано не полностью и качество ответов на запросы со звуком может проседать. На выходе в любом случае только текст: ни картинок, ни видео модель не генерирует.
Что умеет Muse Spark 1.3: бенчмарки
Карточка модели у Meta узкая по охвату, и это само по себе говорящий факт. Там нет ни математических тестов, ни MMLU-подобных задач на эрудицию, ни мультимодальных замеров. Все одиннадцать строк — про кодинг, агентную работу, следование инструкциям и длинный контекст. Под эти задачи модель и делали. Вот где компания вывела себя вперёд.
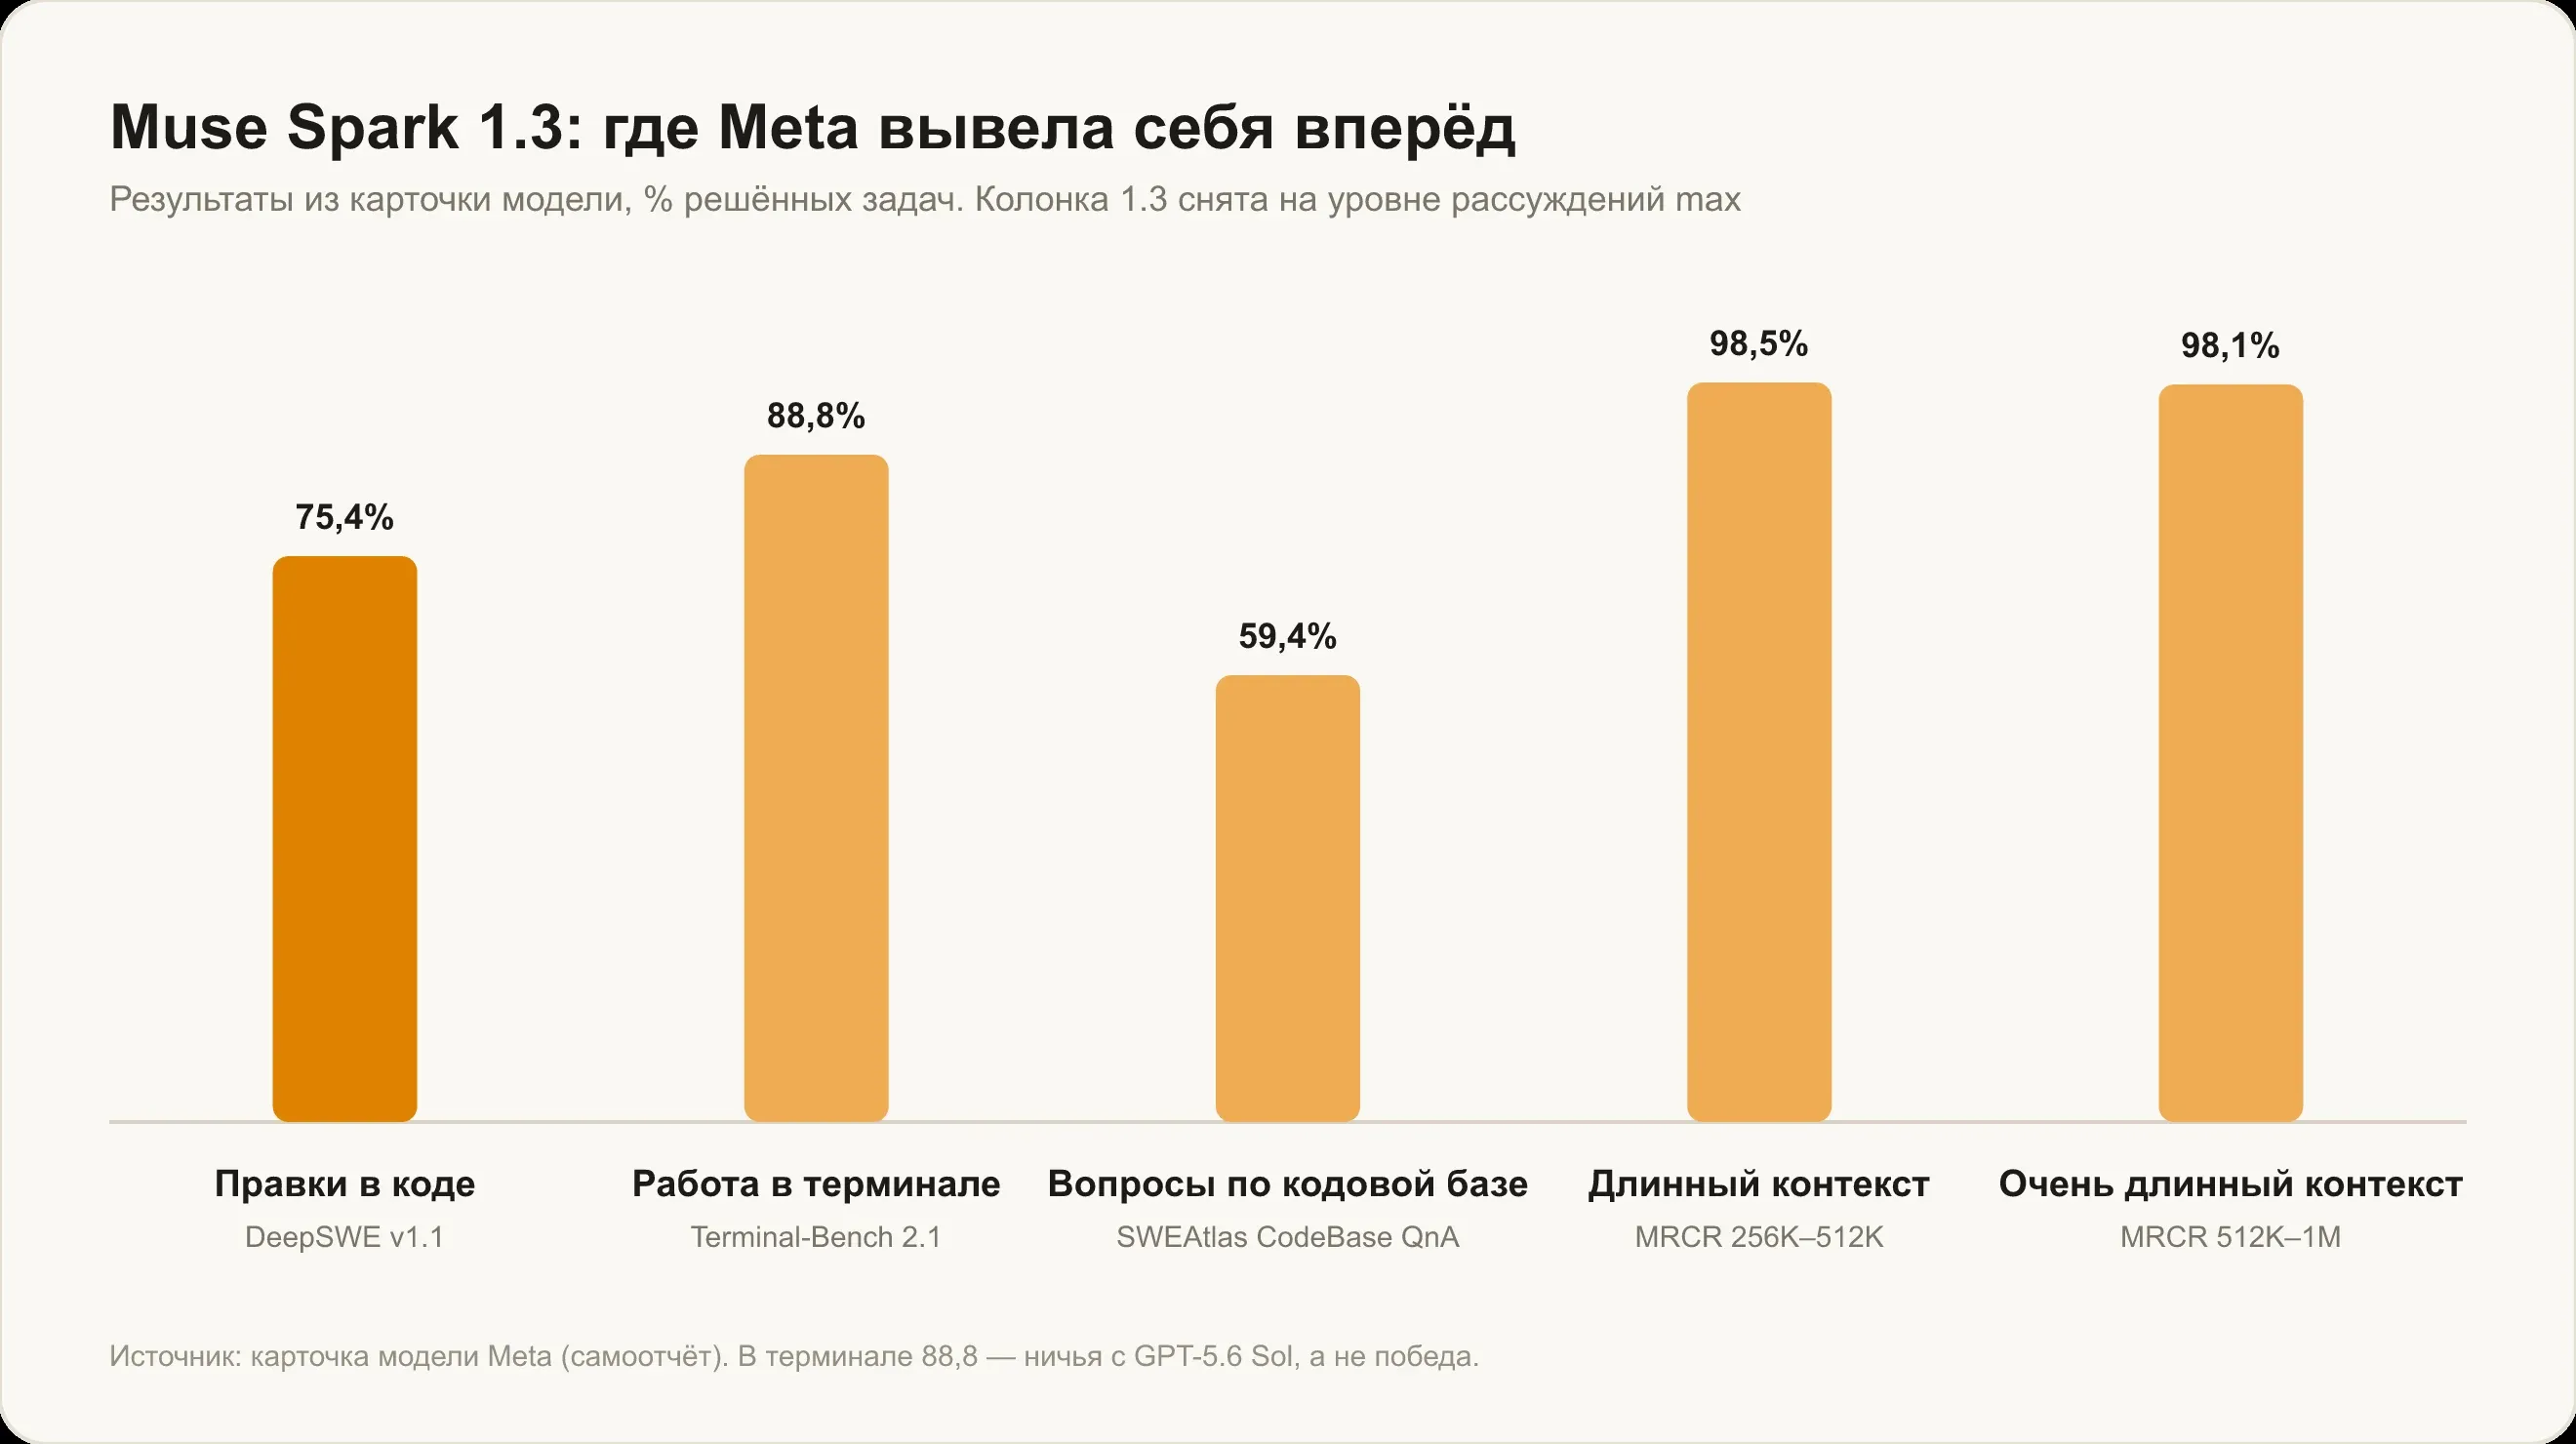
Правки в реальных кодовых базах (DeepSWE v1.1) — 75,4%. Вопросы по устройству чужого кода (SWEAtlas CodeBase QnA) — 59,4%. Поиск нескольких фактов в длинном документе (MRCR) — 98,5% на диапазоне от 256 до 512 тысяч токенов и 98,1% на диапазоне от 512 тысяч до миллиона. Работа в терминале (Terminal-Bench 2.1) — 88,8%.
С последней цифрой есть нюанс, который теряется в пересказах: 88,8% на Terminal-Bench это ничья с GPT-5.6 Sol, а не победа над ним. И ещё один, совсем контринтуитивный: на этом тесте уровень рассуждений xhigh даёт 89,2%, то есть выше, чем максимальный max. Больше раздумий не всегда значит лучше результат.
Честно: четыре строки из одиннадцати
Если открыть карточку Meta целиком, картина получается другая, чем в заголовках новостей. Muse Spark 1.3 уверенно выигрывает четыре строки, одну играет вничью и шесть проигрывает конкурентам.
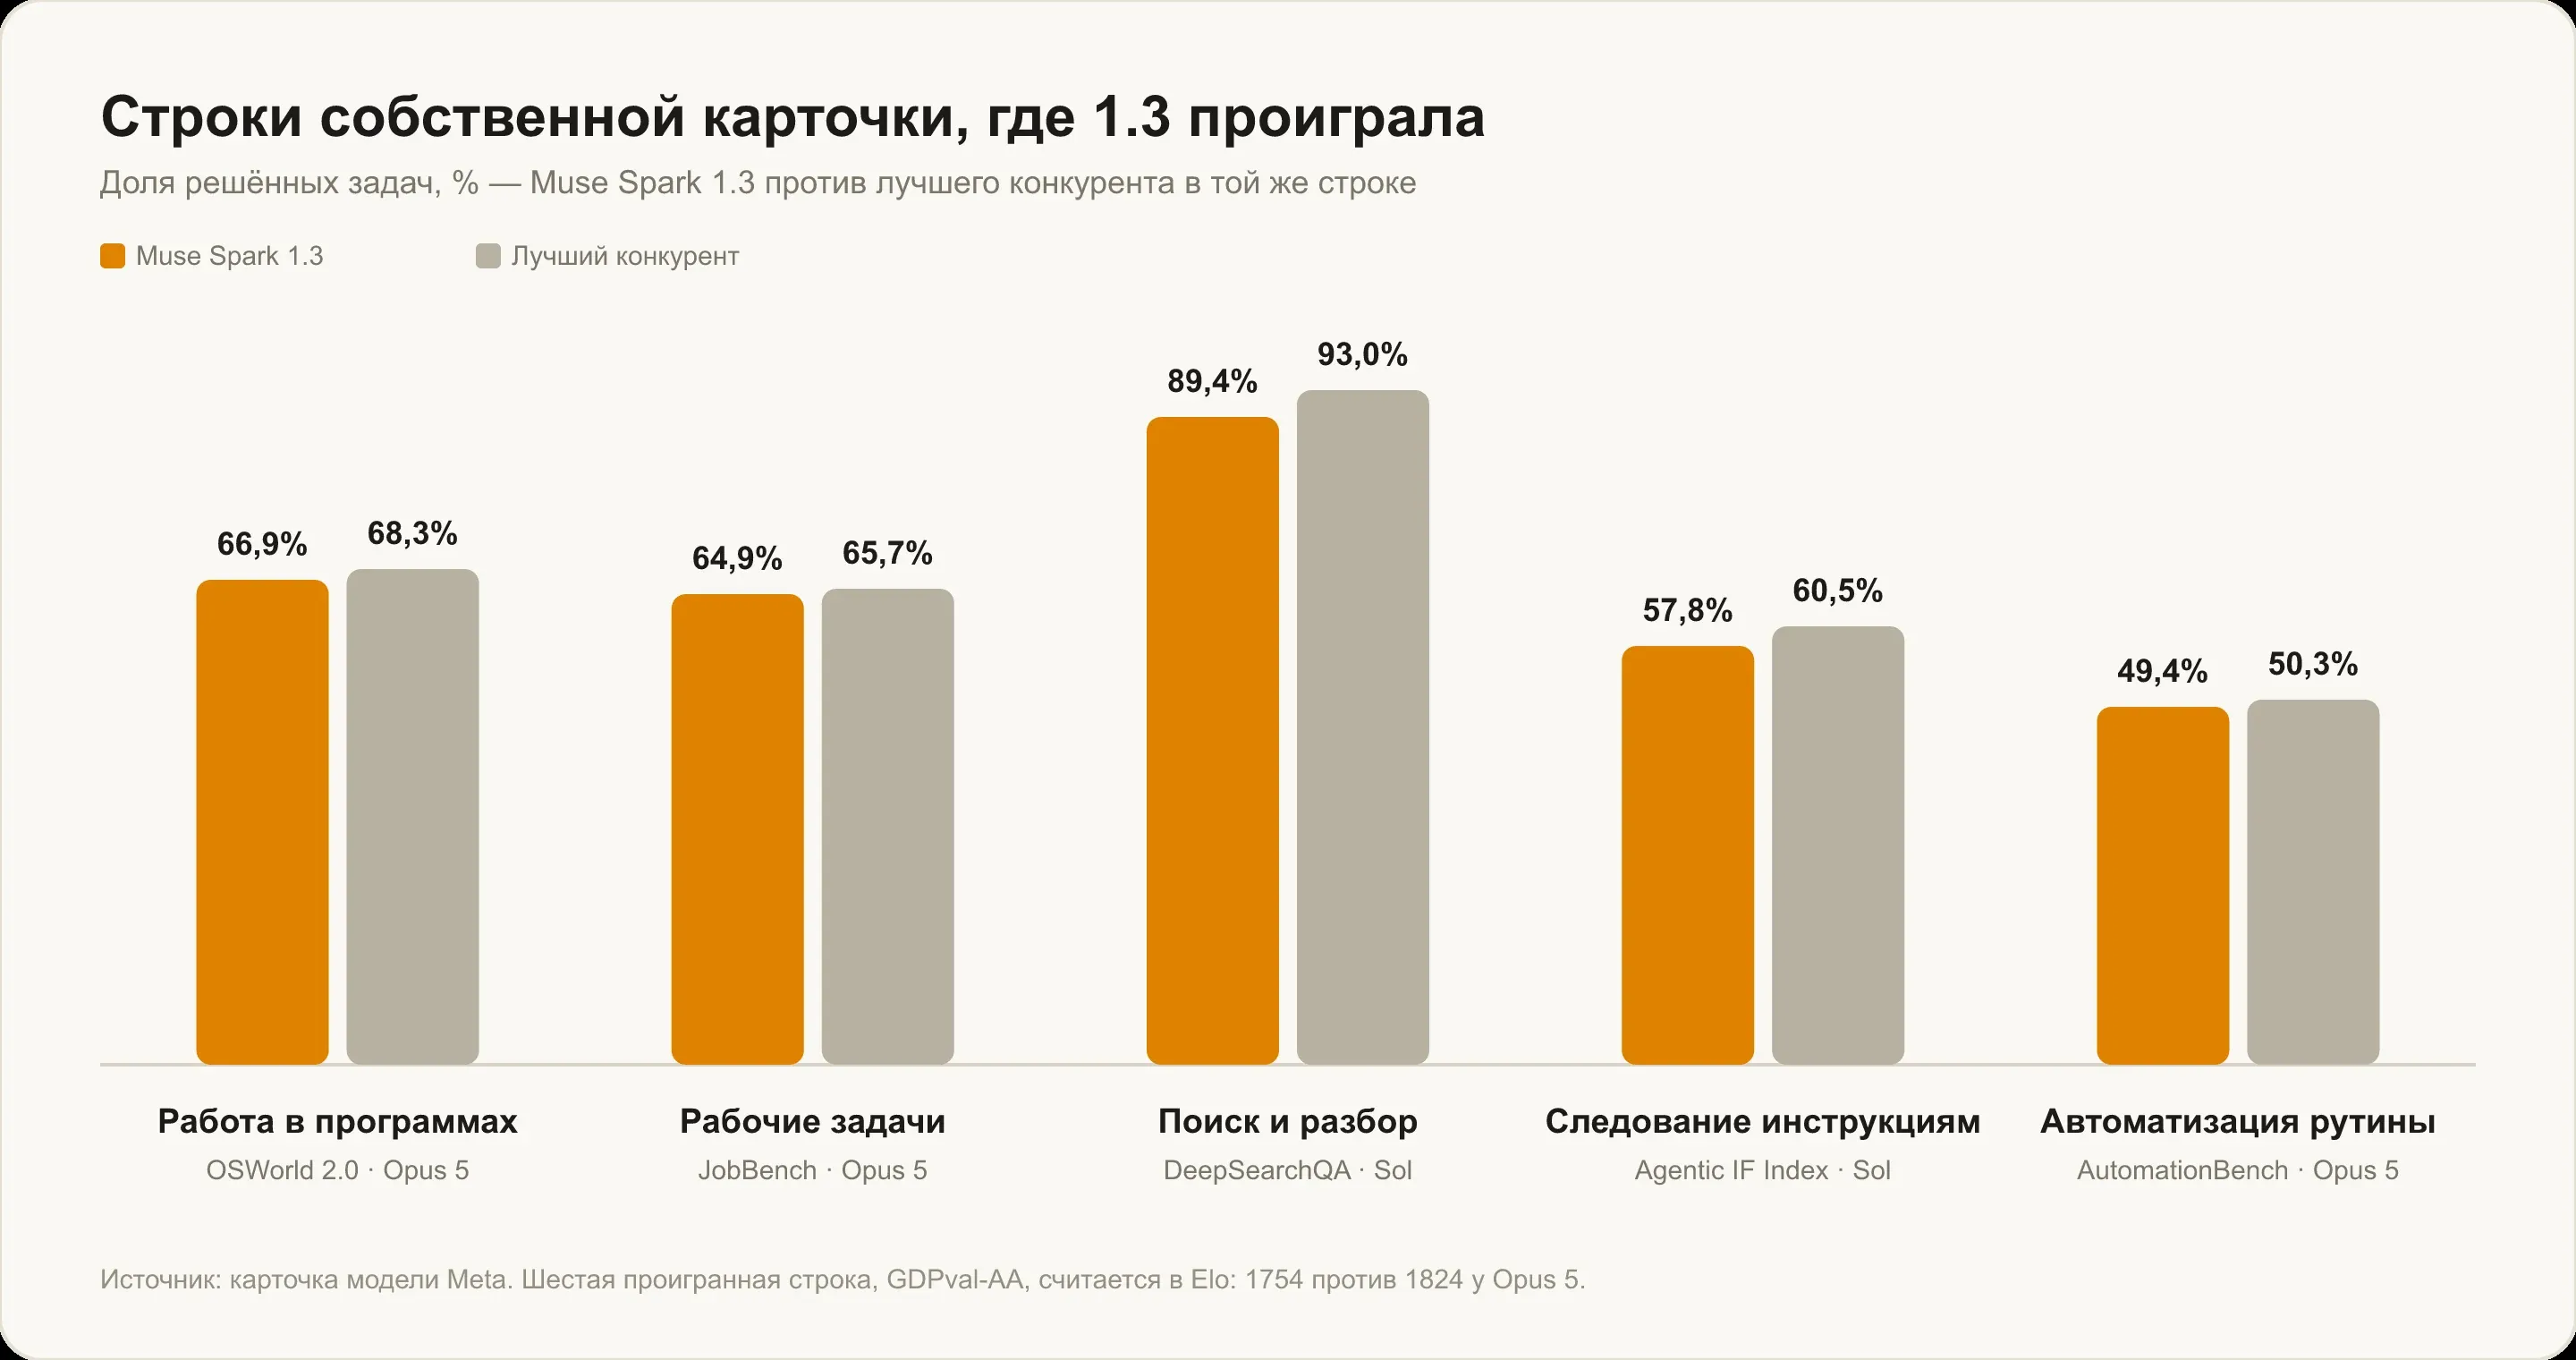
Работа внутри программ (OSWorld 2.0) — 66,9% против 68,3% у Claude Opus 5. Реальные рабочие задачи (JobBench) — 64,9% против 65,7% у Opus 5. Поиск и разбор информации (DeepSearchQA) — 89,4% против 93,0% у GPT-5.6 Sol. Следование инструкциям в агентном режиме (Agentic IF Index) — 57,8% против 60,5% у Sol. Автоматизация рутинных операций (AutomationBench) — 49,4% против 50,3% у Opus 5. Шестая проигранная строка считается в рейтинге Elo: на GDPval-AA, где оценивают выполнение задач, близких к настоящей работе, у Muse Spark 1.3 — 1754 против 1824 у Opus 5.
Разрывы небольшие, от 0,8 до 3,6 процентного пункта, и сами по себе ничего не доказывают. Важно другое: компания собрала таблицу так, чтобы модель выглядела выигрышно, и всё равно в большинстве строк она вторая. Так делают все разработчики, и читать релизные таблицы стоит с этой поправкой.
Спор вокруг DeepSWE: чем закончился
Главная цифра релиза — 75,4% на DeepSWE v1.1. Это первое место, если верить карточке: выше Claude Opus 5 с его 74,0% и GPT-5.6 Sol с 73,0%. Цифры конкурентов Meta не мерила сама, а взяла с лидерборда на момент своего прогона, поэтому по Sol у неё стоит 73,0%, а в текущей записи борда — 72,7%. Главная проблема в другом: собственный результат Meta независимо никто не воспроизвёл.
DeepSWE v1.1 — тест на 113 задач по 91 репозиторию на пяти языках, где задача засчитывается, только если проходят и функциональные, и регрессионные тесты, написанные вручную. У теста есть публичный лидерборд, который ведёт компания Datacurve, и он прогоняет все модели через одну и ту же обвязку mini-swe-agent, чтобы результаты были сопоставимы.
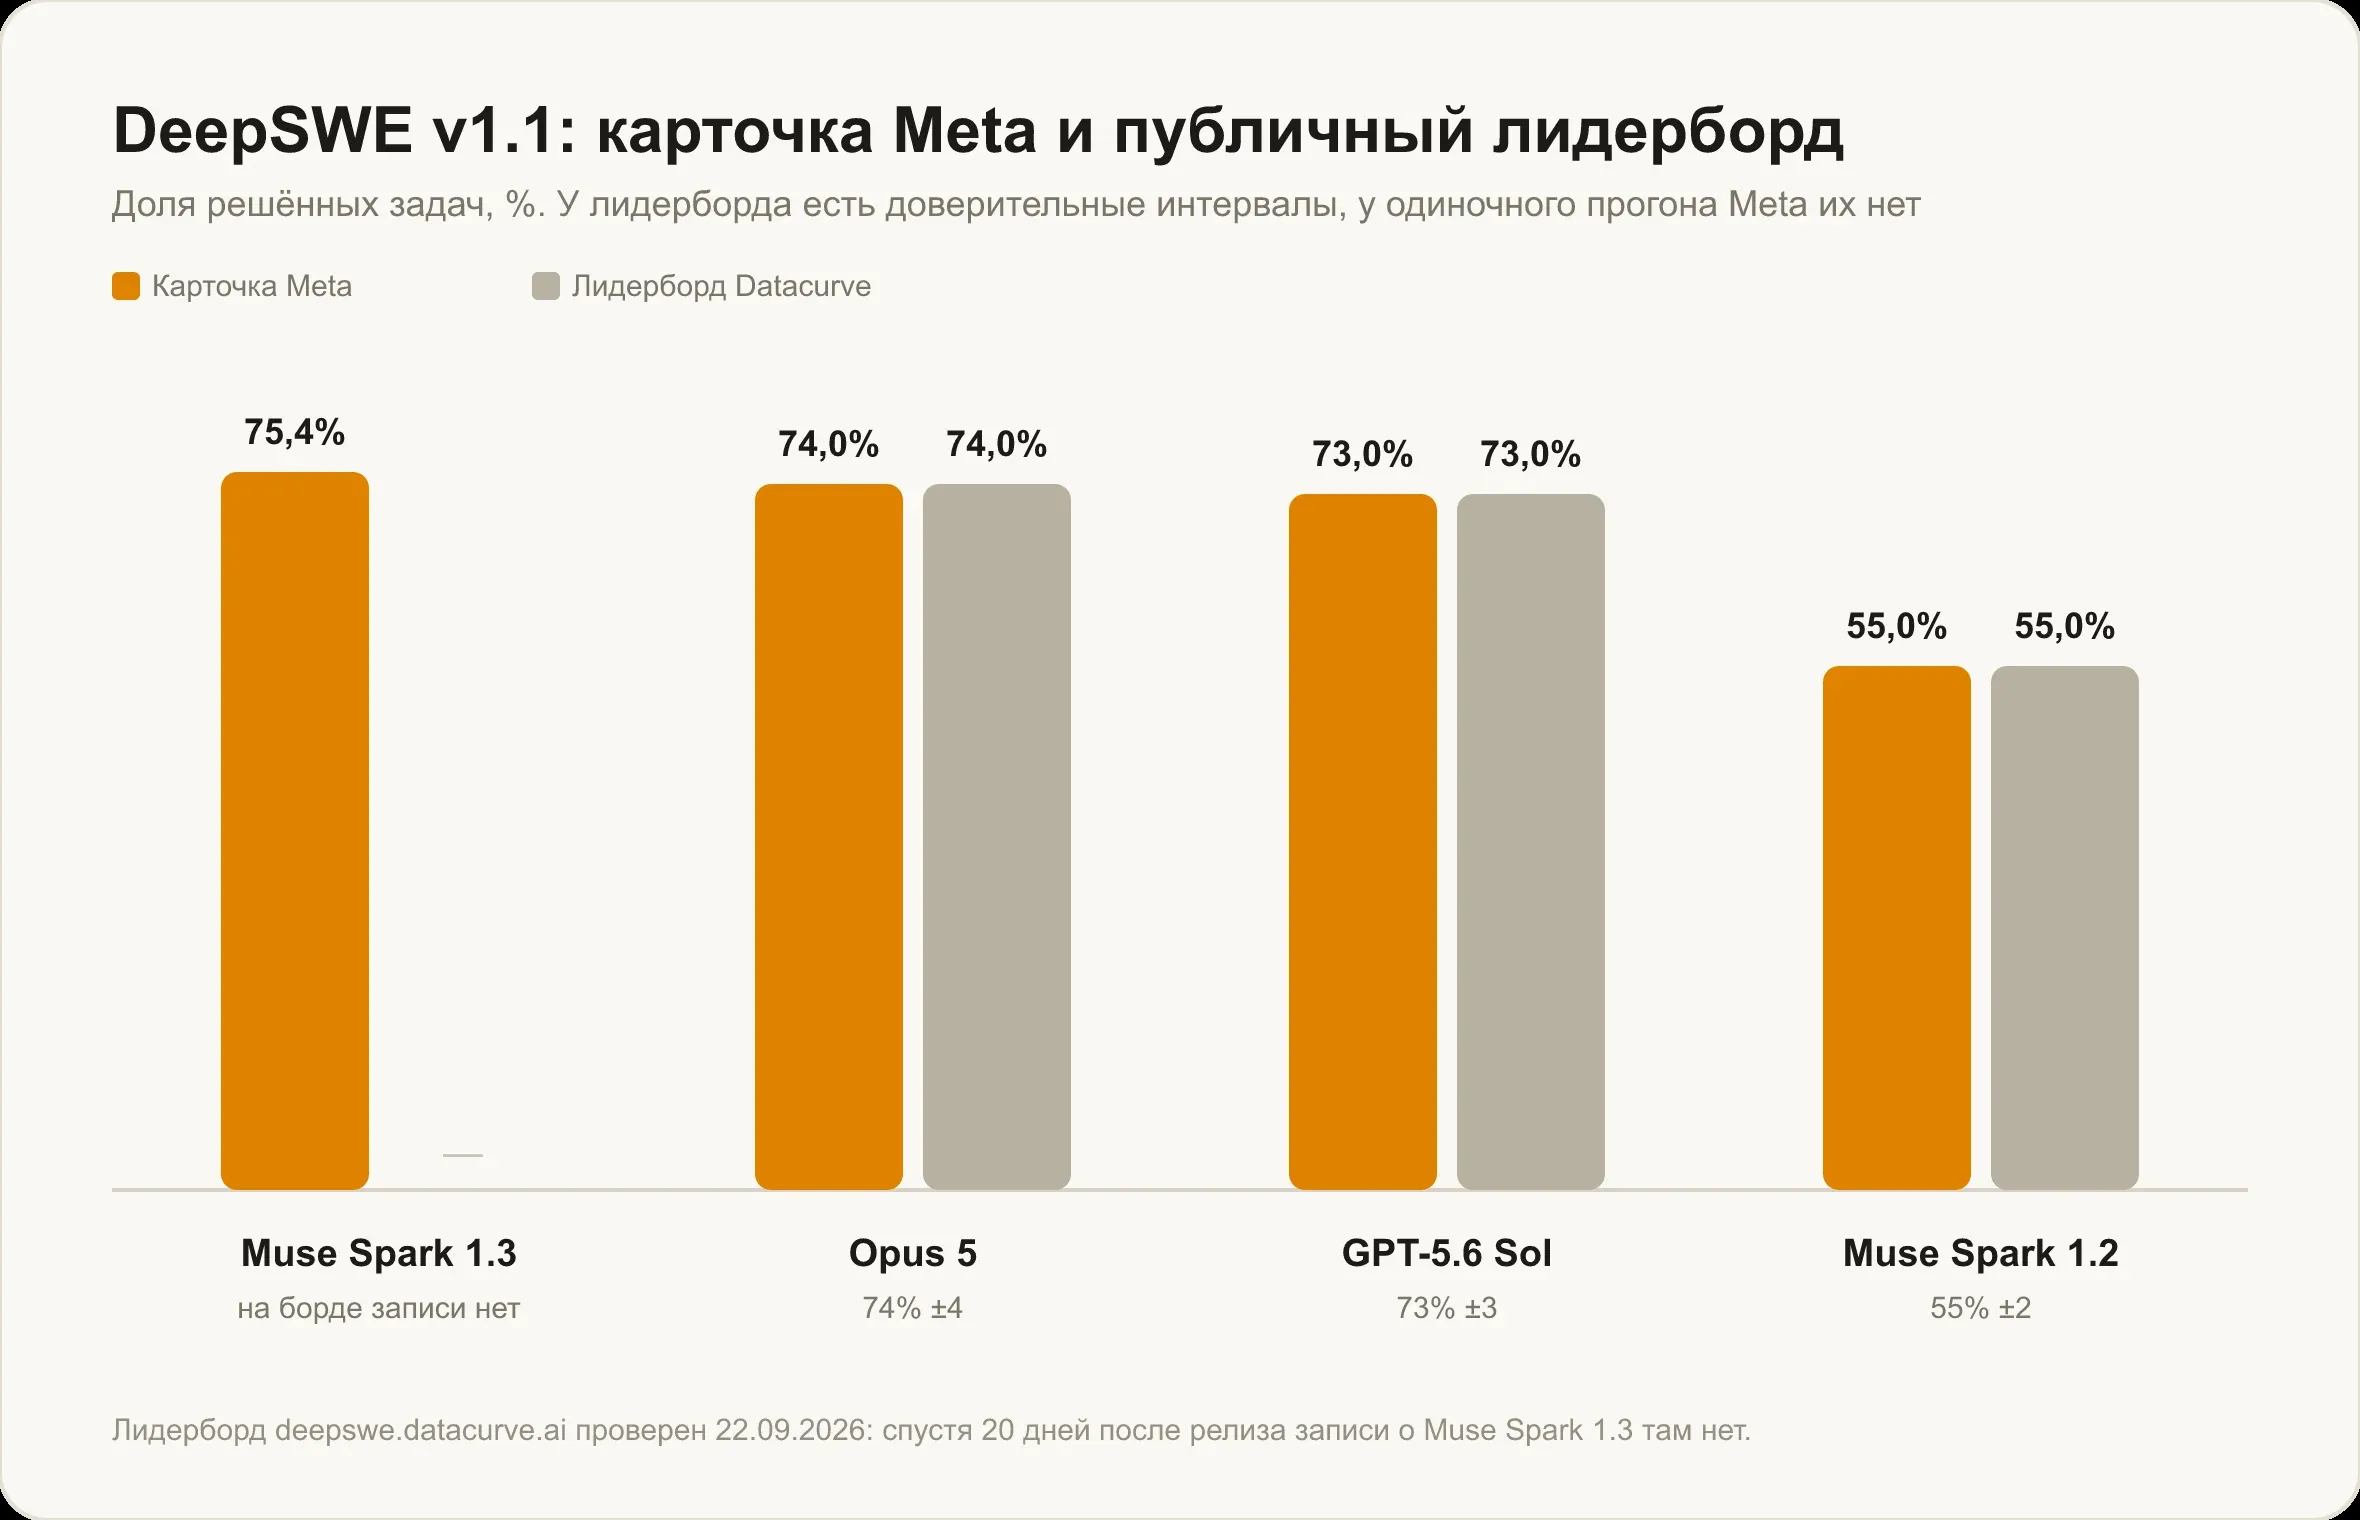
На 22 сентября 2026 года, то есть спустя двадцать дней после релиза, на этом лидерборде Muse Spark 1.3 нет. Предыдущая версия там есть, Muse Spark 1.2 с результатом 55% и доверительным интервалом ±2 пункта. Последняя модель, добавленная на борд, — GPT-6 Astra, её внесли 3 сентября. Записи про 1.3 за эти двадцать дней так и не появилось.
Разница тут не в скаффолде: Meta прогоняла свою модель через тот же mini-swe-agent. Разница в том, кто держал секундомер. Meta замерила себя сама через собственный API, а цифры конкурентов взяла с чужого лидерборда, оговорив в методологии, что настройки сторонних моделей подбирались по мере возможности, а не обязательно оптимально для каждого провайдера. И ещё одна деталь, которую легко пропустить: у записей лидерборда есть доверительные интервалы, потому что там модель прогоняют несколько раз, а у одиночной цифры 75,4 интервала нет. При разрыве в 1,4 пункта над результатом 74% ±4 говорить о первом месте некорректно.
Осторожная формулировка, которая здесь уместна: прогон Meta показал результат выше текущих лидеров публичного борда. Но утверждать, что DeepSWE независимо подтвердил победу Muse Spark 1.3, пока нельзя.
Отдельно предупрежу про ловушку. Сайты-агрегаторы вроде llm-stats показывают Muse Spark 1.3 на первом месте DeepSWE и внешне похожи на лидерборд. Это не лидерборд: они подтягивают самоотчёты разработчиков. Проверяется просто — у llm-stats предыдущая версия, Muse Spark 1.2, стоит с результатом 59,3%, тогда как и в карточке Meta, и на борде Datacurve у неё 55,0%.
Где Muse Spark 1.3 в общем зачёте по коду
Если сложить в одну таблицу результаты всех текущих флагманов на DeepSWE v1.1, расстановка сил получается тесной.
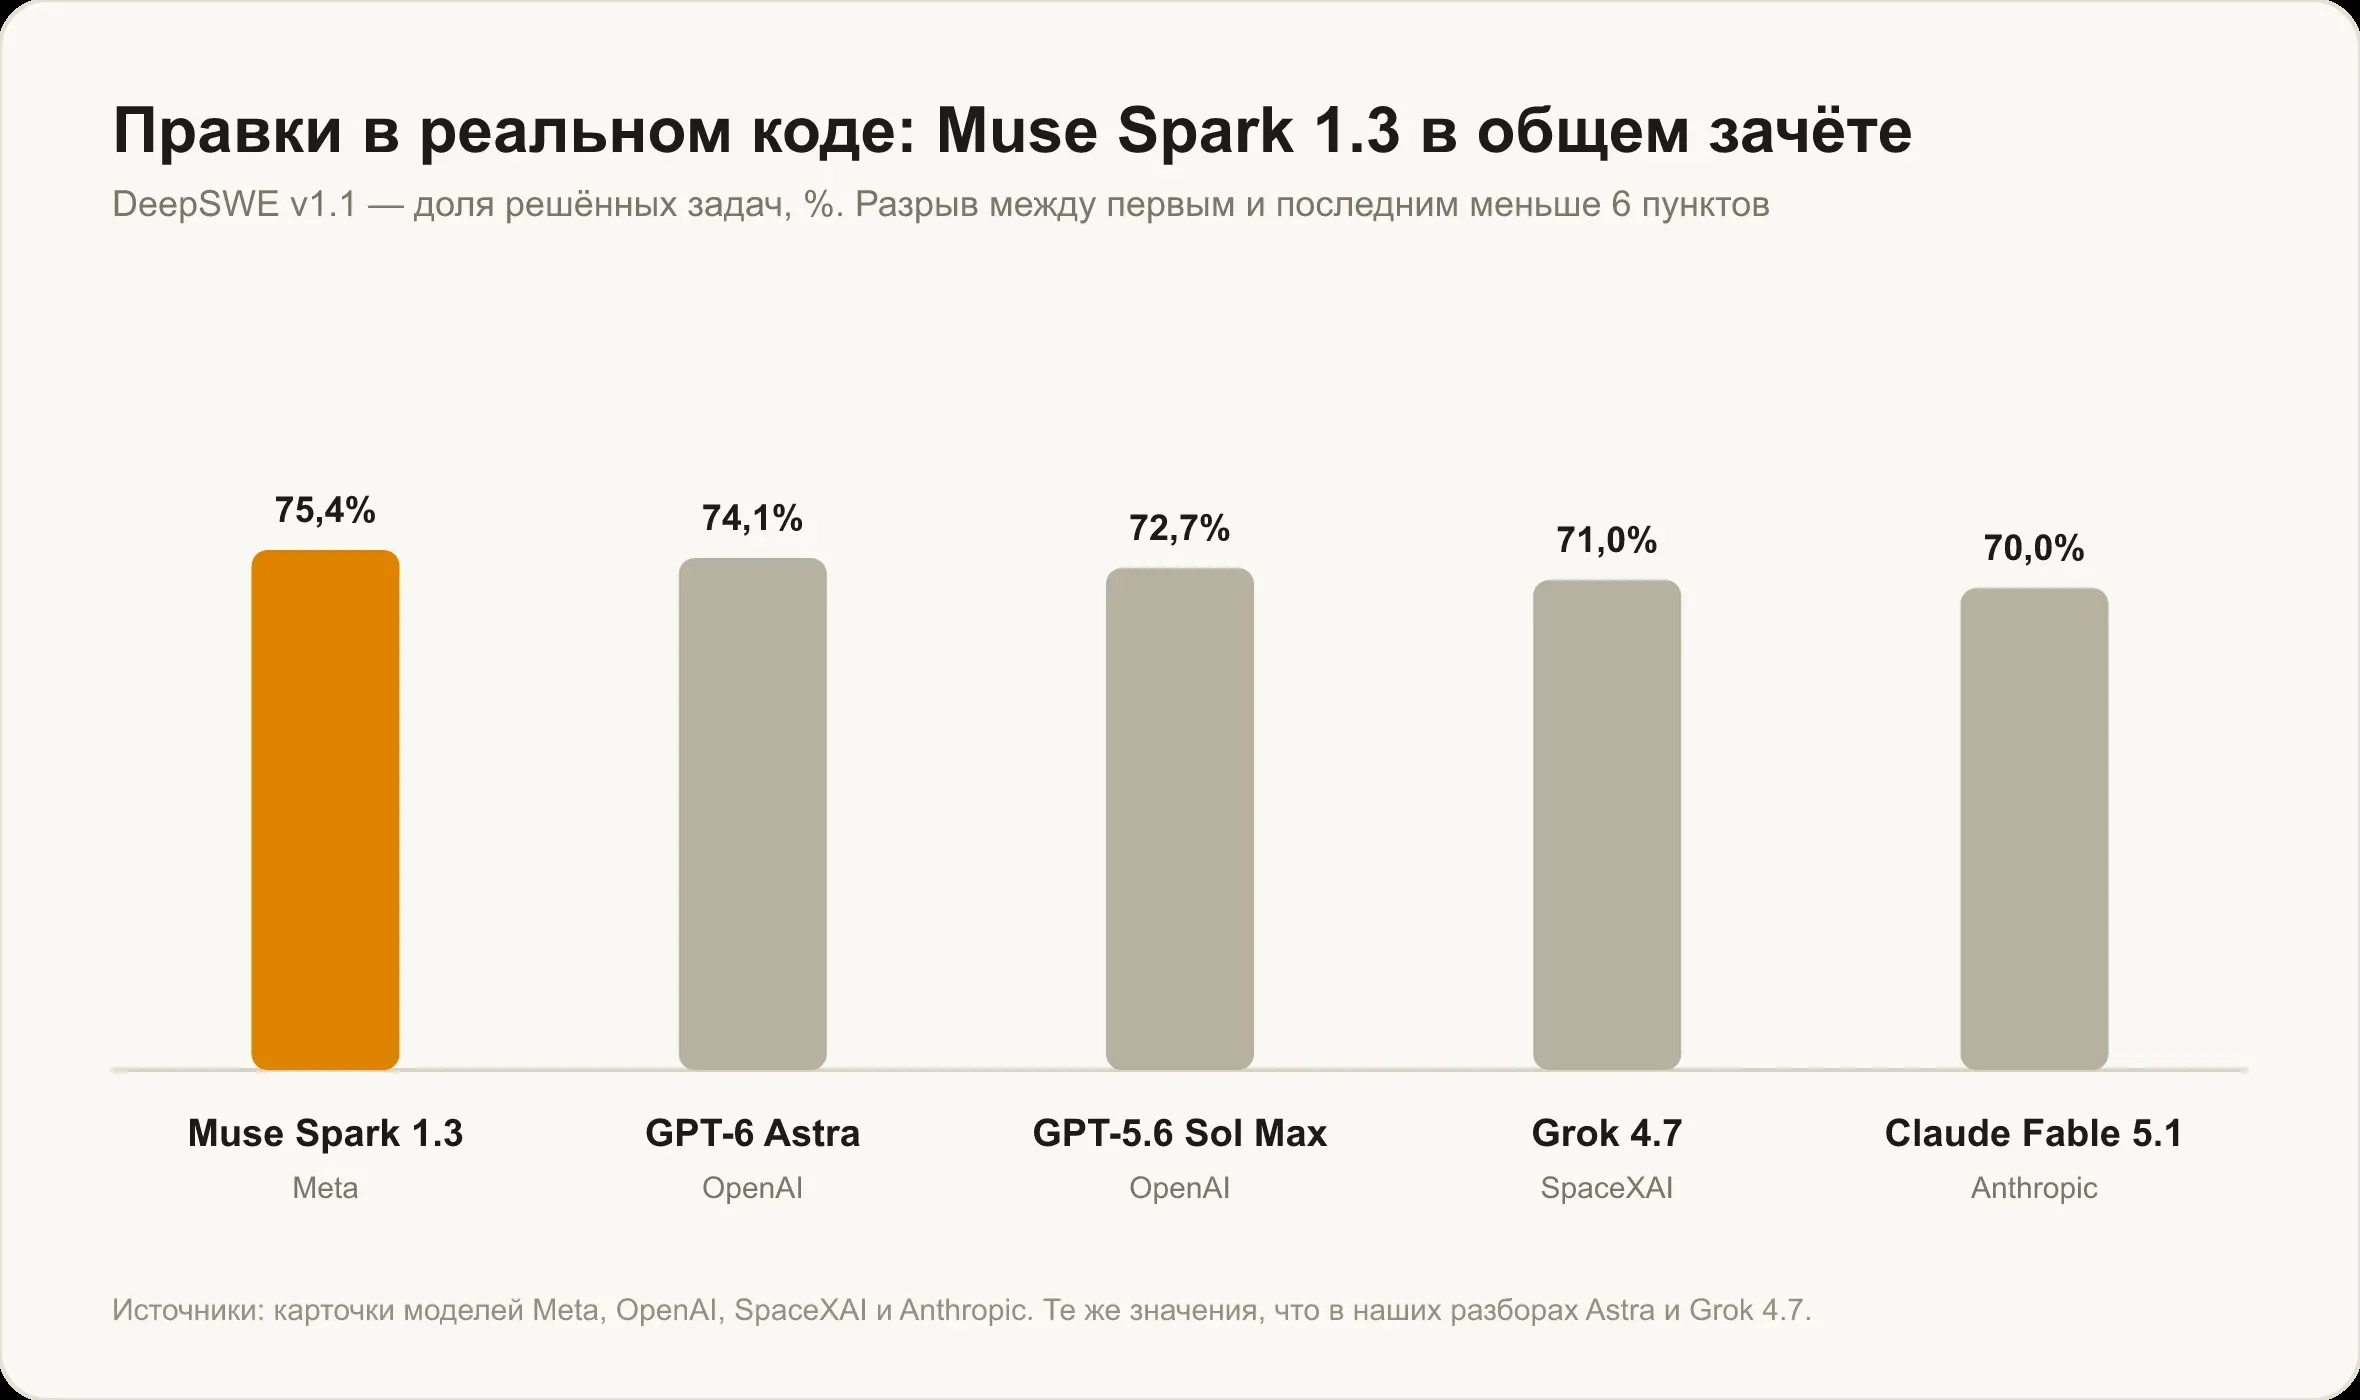
Muse Spark 1.3 — 75,4%, GPT-6 Astra — 74,1%, Claude Opus 5 — 74,0%, GPT-5.6 Sol Max — 72,7%, Grok 4.7 — 71,0%, Claude Fable 5.1 — 70,0%. Шесть флагманов уложились в 5,4 процентных пункта. Выбирать модель под код по такой разнице бессмысленно, разумнее смотреть на цену, скорость и то, как модель ведёт себя на вашей кодовой базе. Мы разбирали этот вопрос шире в материале о том, какая нейросеть лучше пишет код.
В сводном индексе интеллекта Artificial Analysis, который усредняет результаты по десяти тестам сразу, Muse Spark 1.3 на уровне max занимает тринадцатое место из 202 оценённых моделей. Для сравнения, Grok 4.7 в том же индексе шестнадцатая. Важная оговорка: сравнивать баллы этого индекса с цифрами из наших прежних статей про Claude Fable 5.1 и Claude Opus 5 нельзя, агрегатор с тех пор сменил версию методики и пересобрал шкалу у всех моделей сразу.
Что изменилось по сравнению с Muse Spark 1.2
Цена, контекст, лимит ответа и набор модальностей у 1.3 ровно те же, что у 1.2. Contributor-тариф тоже был и раньше. Изменились результаты и добавился уровень рассуждений max, которого у 1.2 не было вообще.
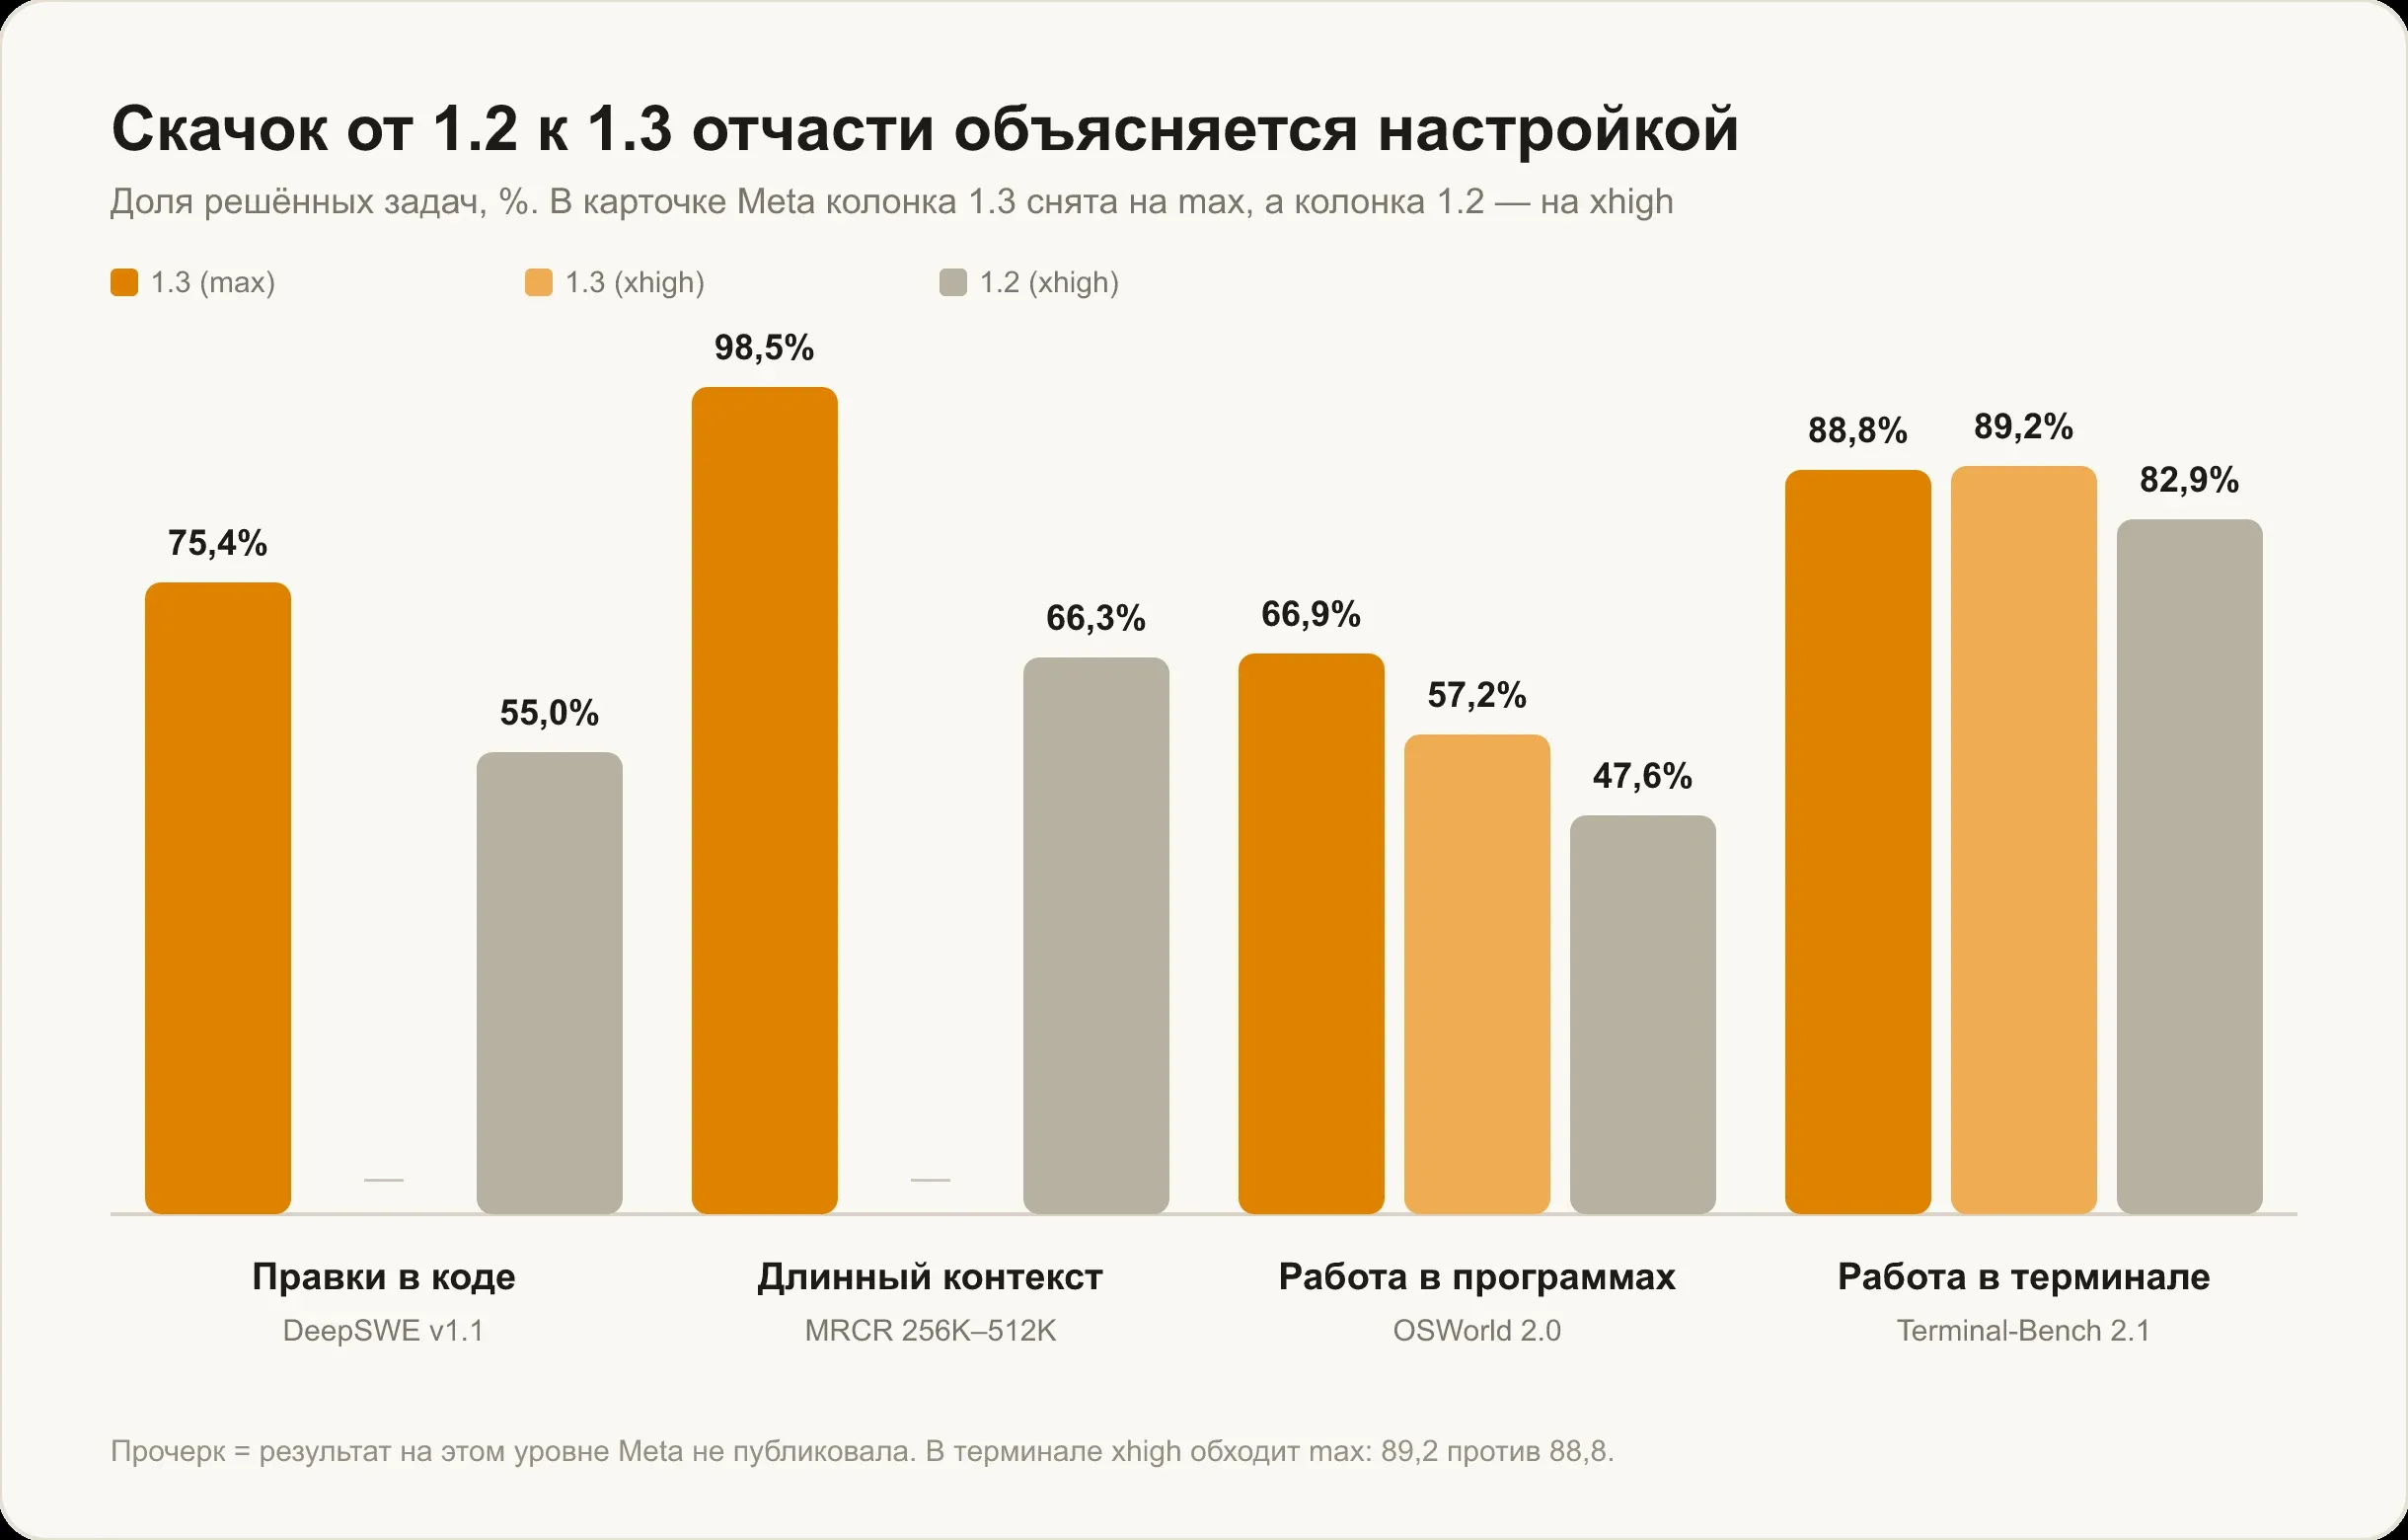
И вот здесь прячется главная оговорка всего релиза. В карточке Meta колонка 1.3 снята на уровне max, а колонка 1.2 — на xhigh, потому что max у неё физически нет. То есть часть скачка это не новое поколение, а более высокий уровень рассуждений. Хорошо видно на OSWorld: 66,9% у 1.3 на max против 47,6% у 1.2, но та же 1.3 на xhigh даёт всего 57,2%. Примерно половина прироста объясняется настройкой, а не моделью.
Meta отдельно заявляет, что 1.3 решает задачи, используя примерно на 20% меньше вызовов инструментов и на 25% меньше токенов, чем 1.2. Замер внутренний, инженерами самой компании. Независимые данные говорят обратное: Artificial Analysis относит модель к очень многословным, она потратила 170 миллионов выходных токенов на прогон индекса при медиане по рынку в 94 миллиона. Прямого противоречия нет, Meta мерила кодинг-задачи в своём агенте, а агрегатор гонял другой набор тестов, но принимать заявление про экономию токенов на веру не стоит.
Изменилось и поведение. По описанию Meta, модель теперь задаёт уточняющие вопросы, когда запрос неоднозначный, сама зовёт пользователя, когда застряла, и просит подтверждения перед необратимыми действиями. Плюс лучше держит несколько задач в одном длинном треде и устойчивее к попыткам подменить ей инструкции через содержимое файлов.
Где модель проседает
Кроме шести проигранных строк собственной карточки, есть независимые наблюдения, и они смешанные.
Редакция MindStudio прогнала модель руками: попросила сделать клон аркадного шутера и получила, по описанию автора, кубик, который стреляет в другие кубики, тогда как две другие модели выдали играбельные игры. На тесте с генерацией векторной графики и оценкой результата моделью-судьёй Muse Spark 1.3 у них же оказалась двадцатой (MindStudio). Это один прогон без опубликованной методики, так что делать из него приговор рано.
Обратные данные тоже есть. На Design Arena, где пользователи вслепую сравнивают сгенерированные интерфейсы, Muse Spark 1.3 занимает первые места по вёрстке UI-компонентов и сайтов и вторые по векторной графике и трёхмерным сценам. Зато проваливается в мобильных приложениях, генерации презентаций и игровых движках. Общий вывод простой: модель неровная, и на своей задаче её стоит проверять вживую, а не по чужим тестам.
Ещё одна вещь, которую Meta не раскрывает вообще: дату отсечки знаний. Её нет ни в блоге компании, ни в карточках на сторонних площадках. Для задач, где важна свежесть фактов, это значит, что проверять придётся самостоятельно.
Как попробовать Muse Spark 1.3
Muse Spark 1.3 заведена в каталог моделей Veruna AI — сервиса, который даёт доступ сразу ко многим нейросетям в одном чате, без VPN, без иностранной карты и с оплатой в рублях. Модель будет открыта на подписке Pro и выше; оформить подписку можно на странице тарифов.
Как именно получить доступ из России, сколько стоят токены у самой Meta и что не так с дешёвым contributor-тарифом, разобрано в отдельной статье как пользоваться Muse Spark 1.3 в России. А прямое сопоставление с другим флагманом для долгих задач — в материале Muse Spark 1.3 против Grok 4.7.
Смысл платформы не в отдельной модели, а в том, что их можно переключать в одном окне. Тяжёлую Muse Spark 1.3 логично брать под многошаговую работу с кодом и длинными документами, а на короткий вопрос переключаться на модель полегче. Если не уверены, какая подойдёт под вашу задачу, у нас есть разбор, как выбрать нейросеть под задачу.
Частые вопросы
Что такое Muse Spark 1.3?
Закрытая флагманская модель Meta, вышедшая 2 сентября 2026 года. Контекст 1 048 576 токенов, максимальный ответ 943 718 токенов, на входе текст, картинки, файлы, аудио и видео, на выходе только текст. Идентификатор в API — muse-spark-1.3.
Правда ли Muse Spark 1.3 лучшая в коде? На DeepSWE v1.1 у неё 75,4% по замеру самой Meta, и это выше, чем у конкурентов. Но публичный лидерборд теста результат модели не показывает до сих пор, спустя двадцать дней после релиза, а разрыв с Claude Opus 5 составляет 1,4 пункта при доверительном интервале конкурента в ±4 пункта. Независимого подтверждения первого места нет.
Сколько стоит Muse Spark 1.3? $1,25 за миллион входных токенов и $4,25 за миллион выходных, чтение из кэша $0,15. Есть ещё удешевлённый contributor-тариф, но у него своя цена: подробности и подводные камни — в статье как пользоваться Muse Spark 1.3.
Какой у Muse Spark 1.3 контекст? 1 048 576 токенов, то есть около полутора тысяч страниц текста. По длинному контексту модель показывает 98,5% на диапазоне 256–512 тысяч токенов и 98,1% на диапазоне 512 тысяч — миллион.
Чем Muse Spark 1.3 отличается от 1.2? Цена, контекст, лимит ответа и модальности не изменились. Выросли результаты и добавился уровень рассуждений max. Важно: в карточке Meta 1.3 замерена на max, а 1.2 на xhigh, поэтому часть прироста объясняется настройкой, а не сменой поколения.
Можно ли скачать веса Muse Spark 1.3? Нет. Модель закрытая, веса не публиковались. В планах Meta упоминается «релиз открытых весов Muse Spark» без указания версии и даты.