
Кратко
- Восемь нейросетей, пять одинаковых заданий на русском, ответы без имён, оценка по чек-листу.
- Лидируют три модели Claude (105–107 из 125), но разрыв между ними меньше погрешности. Последний — Grok 4.7 (89).
- Дорогая не значит лучше: Haiku 5.5 за 0,50 доллара набрала почти как Opus 5.5 за 20.
- Штампов ИИ не избежал никто: 3,2–3,6 из 5.
Какая нейросеть лучше пишет по-русски: короткий ответ
Короткий ответ: в нашем тесте лучше всех справились модели Claude, хуже всех — Grok 4.7. Но победитель зависит от задачи. Письмо клиенту и редактуру лучше написал Claude Haiku 5.5, рассказ — Claude Sonnet 5.5, а заметку строго по фактам — GPT-6 Luna.
Это не научный бенчмарк, а эксперимент на пяти заданиях. Ниже метод, настоящие тексты и места, где результату нельзя доверять слепо.
Как мы проводили слепой тест
Тест прошёл 14 октября 2026 года. Участвовали восемь моделей: Claude Sonnet 5.5, Claude Haiku 5.5, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Luna, Gemini 3.8 Flash, Grok 4.7 и DeepSeek V4.1 Flash. Мы вызывали их через API с одним и тем же запросом, без системной инструкции и с настройками по умолчанию. Один запрос на модель и задание, ответ брали первый удачный. У Grok соединение несколько раз обрывалось, и запрос приходилось повторять, текст при этом не менялся.
Все 40 ответов (8 моделей на 5 заданий) перемешали и подписали буквами от А до З. В каждом задании раскладка своя, так что «Модель А» в письме и «Модель А» в рассказе — разные нейросети. Оценивали по пяти критериям, каждый от 1 до 5, где 5 — лучше всего:
- канцелярит: нет ли «сообщает компания» и «осуществление мероприятий»;
- штампы ИИ: «надёжный спутник», «искренние извинения», «в ритме города»;
- грамотность и согласование;
- выдуманные факты и следование заданию: объём, условия, отсутствие лишних приписок;
- живость: есть ли голос и конкретика.
Судей было двое: Claude Sonnet 5.5 и GPT-6.1 Sol. Оба сами участвуют в тесте, поэтому оценивали вслепую: соответствие букв моделям открыли только после того, как оценки были сохранены. Максимум за все задания — 125 баллов (5 заданий, 5 критериев, 5 баллов).
Задание 1: письмо клиенту о задержке поставки
Задача: написать письмо Ольге Викторовне Крыловой из ООО «Меридиан». Заказ №4127 придёт на две недели позже, потому что подрядчик задержал партию драйверов. Компенсация — скидка 5% на следующий заказ, объём 110–150 слов.
Вот два письма из восьми. Модель Д:
Компания «Вектор Light» сообщает, что поставка светильников по заказу №4127 для ООО «Меридиан» будет выполнена не 12 октября, как планировалось ранее, а ориентировочно 26 октября.
…Мы приложим все усилия, чтобы текущая поставка состоялась в обозначенный срок, а дальнейшее сотрудничество оставалось надежным и комфортным.
Модель Е:
Спасибо, что доверяете «Вектор Light». Пишу, чтобы лично сообщить о задержке заказа №4127 для ООО «Меридиан». Наш подрядчик задержал поставку партии драйверов, без которых мы не можем собрать светильники. Поэтому заказ поступит не 12 октября, а примерно на две недели позже, ориентировочно 26 октября.
Угадали, кто есть кто? Модель Д — GPT-6 Luna, и это самый канцелярский текст в задании: «сообщает», «обозначенный срок», «надежным и комфортным». Модель Е — Claude Haiku 5.5, она начала письмо не с формулы вежливости, а с фразы живого человека. Правда, Haiku дописала после письма приписку про дату («сегодня 14 октября, проверьте, что дата актуальна»). Полезно, но мы просили только письмо.
Лучший результат в задании у Haiku (19 из 25 в среднем у двух судей), следом Opus (18) и Sonnet (17,5). У GPT-6 Luna и DeepSeek по 15,5, у Grok 15.
Задание 2: продающий текст для термокружки
Вводные: кружка «Север», 450 мл, нержавеющая сталь, тепло до 8 часов, крышка от проливания, влезает в автомобильный подстаканник, 5 цветов. Аудитория 25–45 лет, до 120 слов, характеристик не выдумывать.
Модель Б открыла карточку так:
Термокружка «Север» (450 мл) — ваш надежный спутник в ритме большого города.
И закончила так:
Термокружка «Север» — это практичность, тепло и комфорт в каждом глотке!
Это Gemini 3.8 Flash, и в одном тексте собрались сразу три штампа ИИ: «надёжный спутник», «ритм города» и «комфорт в каждом глотке». Худший результат по этому заданию у неё и у Grok 4.7 (по 15 из 25). Модель З (Grok) пошла другим путём и вставила в текст описание аудитории из задания:
Городские жители 25–45 лет ценят каждую минуту: деловые встречи, пробки, перерывы на кофе.
Кроме того, Grok добавил то, чего нет в описании: «компактный размер» и «5 стильных цветов». Это мелкая, но выдумка, а мы просили не выдумывать.
Лучшая заявка на живой текст — у Claude Haiku 5.5 (модель Д):
Начинается утро, и хочется, чтобы кофе оставался горячим до последнего глотка. «Север» держит тепло до 8 часов, от первой чашки до вечерней прогулки.
Haiku и Opus сделали ставку на конкретные сцены («чай в пробке, какао на прогулке» — это Opus). По сумме баллов в этом задании Haiku набрала 20,5, Sonnet, Opus и DeepSeek по 20.
Задание 3: заметка строго по фактам
Мы выдали короткую справку про вымышленный коворкинг «Лофт-14»: площадь, места, тарифы, часы работы, метро. И попросили написать заметку для блога на 90–120 слов, ничего не добавляя от себя. Вымышленную компанию выбрали намеренно: модель не могла вспомнить факты из обучения, только пересказать то, что дали.
Хорошая новость: выдуманных цифр нет ни у одной модели. Мы сверили все восемь текстов с исходником: цифры, названия и тарифы совпали у каждой модели. Различия начались со стиля.
Модель Г (GPT-6 Luna) уложила все факты без воды:
Коворкинг «Лофт-14» в Казани открылся 3 марта 2026 года. Пространство площадью 640 м² рассчитано на 86 рабочих мест. Для встреч предусмотрены четыре переговорные, а для звонков резиденты могут бесплатно пользоваться отдельным кабинетом.
Модель Б (Grok 4.7) закончила повтором: «Новые резиденты не платят за первую неделю и также получают бесплатный кофе вместе с доступом к кабинету для звонков». Тот же кофе и тот же кабинет уже упоминались абзацем выше. А Модель Д (Claude Sonnet 5.5) закрыла заметку рекламным штампом: «Так что если вы ищете рабочее место в Казани, «Лофт-14» стоит взять на заметку».
Самый странный текст у модели З — DeepSeek V4.1 Flash. Она записала все числа словами:
Открытие состоялось третьего марта две тысячи двадцать шестого года. Площадь пространства составляет шестьсот сорок квадратных метров.
Формально безупречно, читать невозможно. Лучший результат в задании у GPT-6 Luna (23 из 25), Gemini 3.8 Flash идёт второй (22), Claude Sonnet 5.5 третьей (21).
Задание 4: рассказ про сломанный кофейный автомат
Тут правил почти нет: рассказ до 150 слов о том, как в понедельник утром в офисе сломался кофейный автомат. Без банальностей и морали.
Модель В:
Внутри, под бункером для зёрен, лежал сложенный вчетверо листок: «Если вы это читаете, я уволился в 2019-м. Код от кладовки с настоящим кофе: 4417. Не говорите Зинаиде».
Кладовку нашли за четыре минуты. Там стояли три кофемолки и джезва.
Зинаида из хозотдела пришла в 9:20, вдохнула запах и сказала:
— Я знала.
Автомат так и не починили. Его накрыли пледом, и теперь на нём стоит фикус.
Это Claude Sonnet 5.5 и лучший текст теста: 24,5 из 25. Хорошо работают мелочи: код 4417, «Не говорите Зинаиде», фикус в финале. Морали нет.
Модель Ж (Claude Opus 5.5) тоже сильна: автомат выдаёт бумажку «Ошибка 0x4F. Обратитесь к Тамаре», выясняется, что Тамара уволилась 26 лет назад, а в финале автомат «налил ей чай с лимоном. Чая в нём никогда не было».
Хуже всех справился DeepSeek V4.1 Flash (17,5): модель З выдала набор клише про офисный быт.
Из него выпал последний стаканчик с надписью «Ты справишься». Никто не справился. К обеду отдел продаж начал курить в туалете, бухгалтерия — плакать, а дизайнеры рисовали на стенах чашки.
И финал «Вася вышел с чашкой кофе и сказал: «Там целый мир». Больше он не вернулся». Шума здесь больше, чем смысла. У Grok 4.7 (19,5) в тексте оказалась логическая дыра: «люди так и остались в лифте, между этажами, листая ленту» — при чём тут лифт, из рассказа не ясно.
Задание 5: редактура канцелярита
Последняя задача: отредактировать тяжёлый кусок и уложиться в 60 слов, сохранив все факты. Исходник:
В целях осуществления повышения эффективности работы отдела продаж нами было принято решение о проведении собрания, которое состоится в пятницу в 15 часов, на котором будут рассмотрены вопросы касательно снижения показателей по сравнению с прошлым кварталом, а также будет произведено обсуждение мероприятий по их улучшению. Просим всех сотрудников обеспечить свою явку, так как отсутствие без уважительных причин будет расценено как нарушение.
Модель В (Claude Opus 5.5):
В пятницу в 15:00 собираем отдел продаж. Показатели упали по сравнению с прошлым кварталом, поэтому разберём, почему так вышло, и обсудим, как это исправить. Приходите все: явка обязательна, а пропуск без уважительной причины будет считаться нарушением.
Модель Г (GPT-6.1 Sol):
В пятницу в 15:00 состоится обязательное собрание отдела продаж. Обсудим снижение показателей по сравнению с прошлым кварталом и меры по их улучшению. Просим всех сотрудников присутствовать: отсутствие без уважительной причины будет считаться нарушением.
Первая версия звучит как сообщение коллеге, вторая осталась в офисном стиле: «состоится», «меры по их улучшению», «просим присутствовать». Почти дословно так же отредактировала и модель З, то есть GPT-6 Luna. Две модели одной линейки пришли к практически одному тексту.
У Grok 4.7 в редактуре есть грамматическая неловкость: «Явка обязательна — без уважительных причин будет нарушение». Здесь лучше всех Claude Haiku 5.5 (24,5 из 25), потом Sonnet (24) и Opus (23,5).
Итоговый рейтинг: кто сколько набрал
После раскрытия сложили баллы обоих судей. На графике столбец — среднее двух судей, точки показывают оценку каждого.
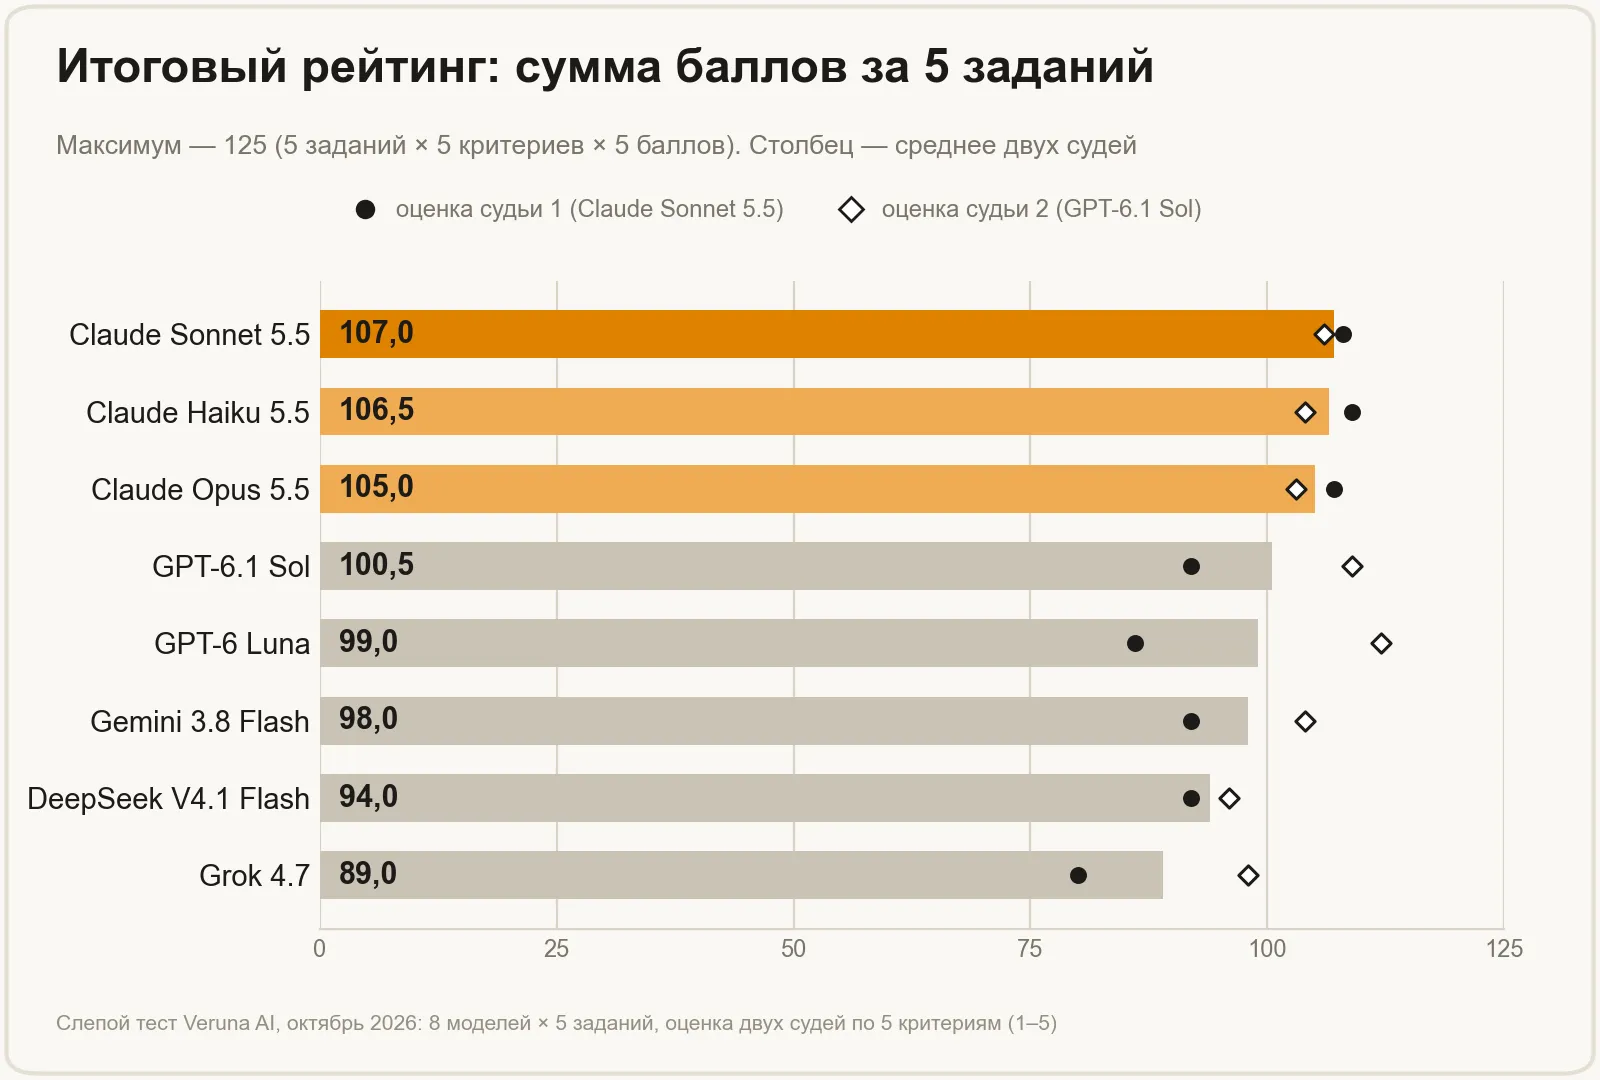
Три модели Claude идут плотной группой: 107, 106,5 и 105. Разрыв в два балла из 125 — это один текст, который судья мог оценить иначе, поэтому считать Sonnet «победителем» нельзя. Следом идёт четвёрка GPT-6.1 Sol, GPT-6 Luna, Gemini 3.8 Flash и DeepSeek V4.1 Flash (100,5 — 94), замыкает Grok 4.7 с 89.
Если разложить баллы по критериям, видно, чем одни модели отличаются от других.
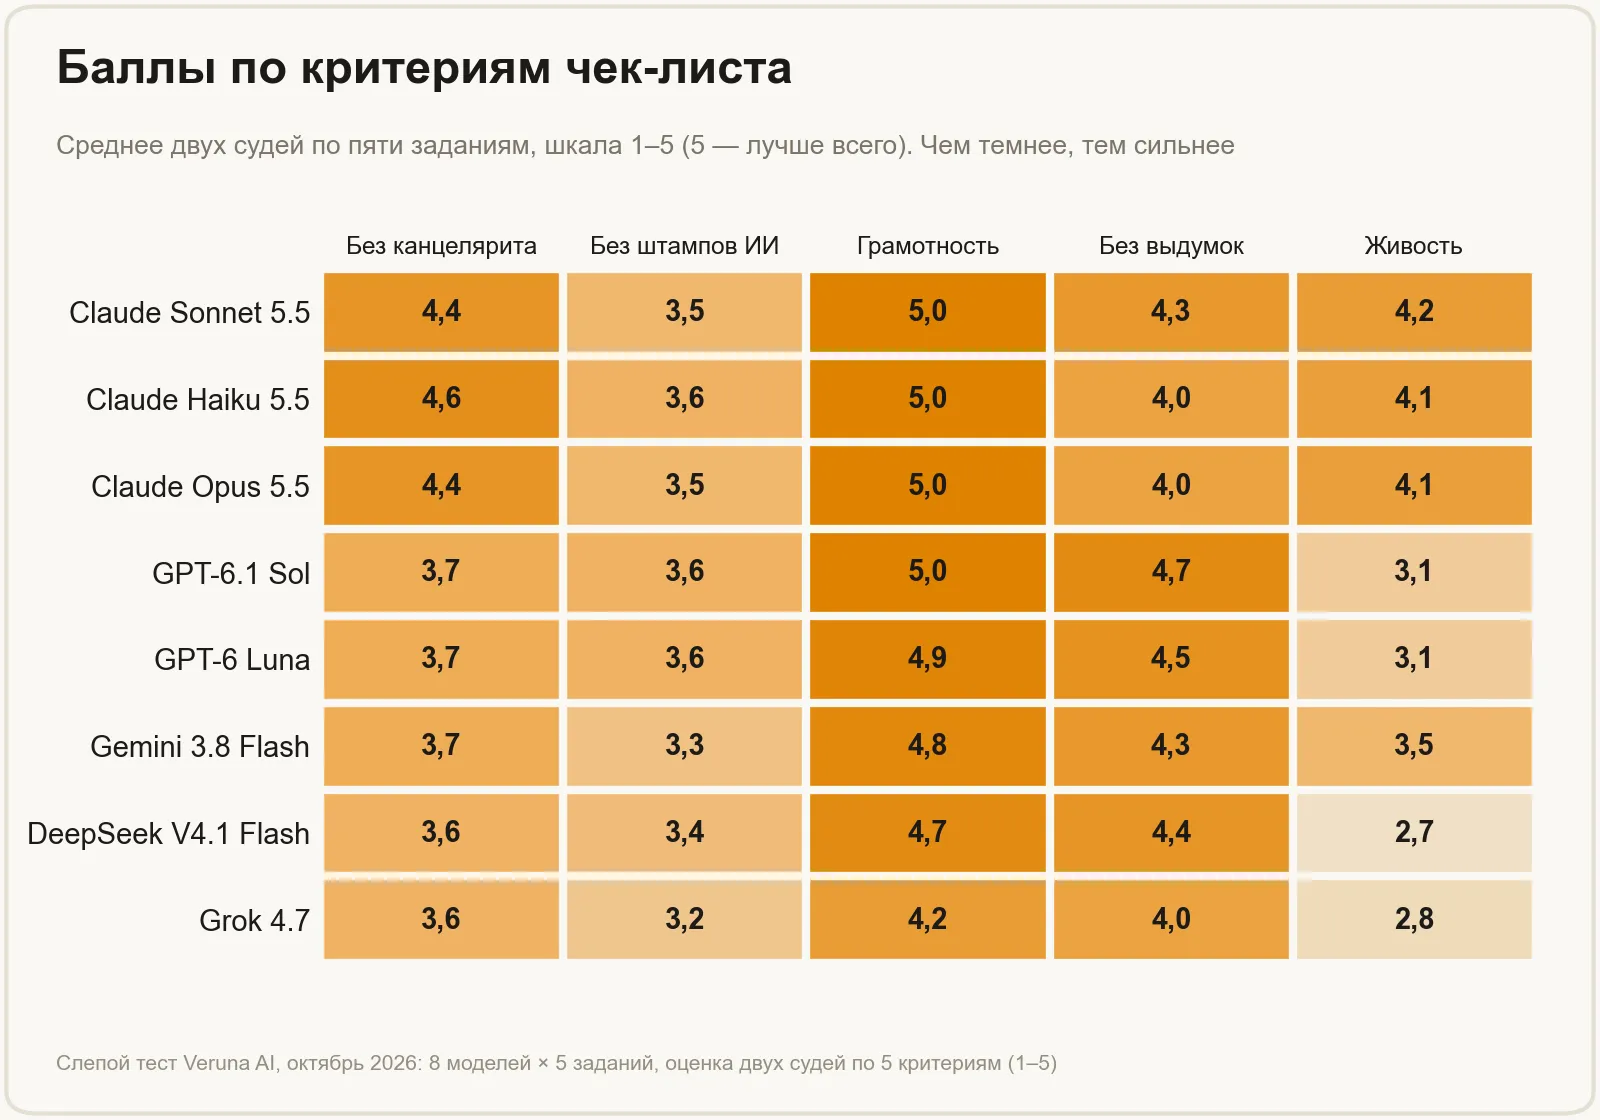
Что здесь заметно:
- Грамотность почти у всех около 5. Ошибки согласования в этом тесте — не главная проблема современных моделей. Исключение — Grok 4.7 с 4,2.
- По «живости» разрыв самый большой: у Claude 4,1–4,2, у GPT-6.1 Sol и GPT-6 Luna 3,1, у DeepSeek 2,7 и у Grok 2,8.
- Зато рамки задания лучше всех держат модели GPT: у Sol 4,7 и у Luna 4,5, у трёх Claude 4,0–4,3.
- Штампы ИИ не победил никто. Лучший результат — 3,6 из 5.
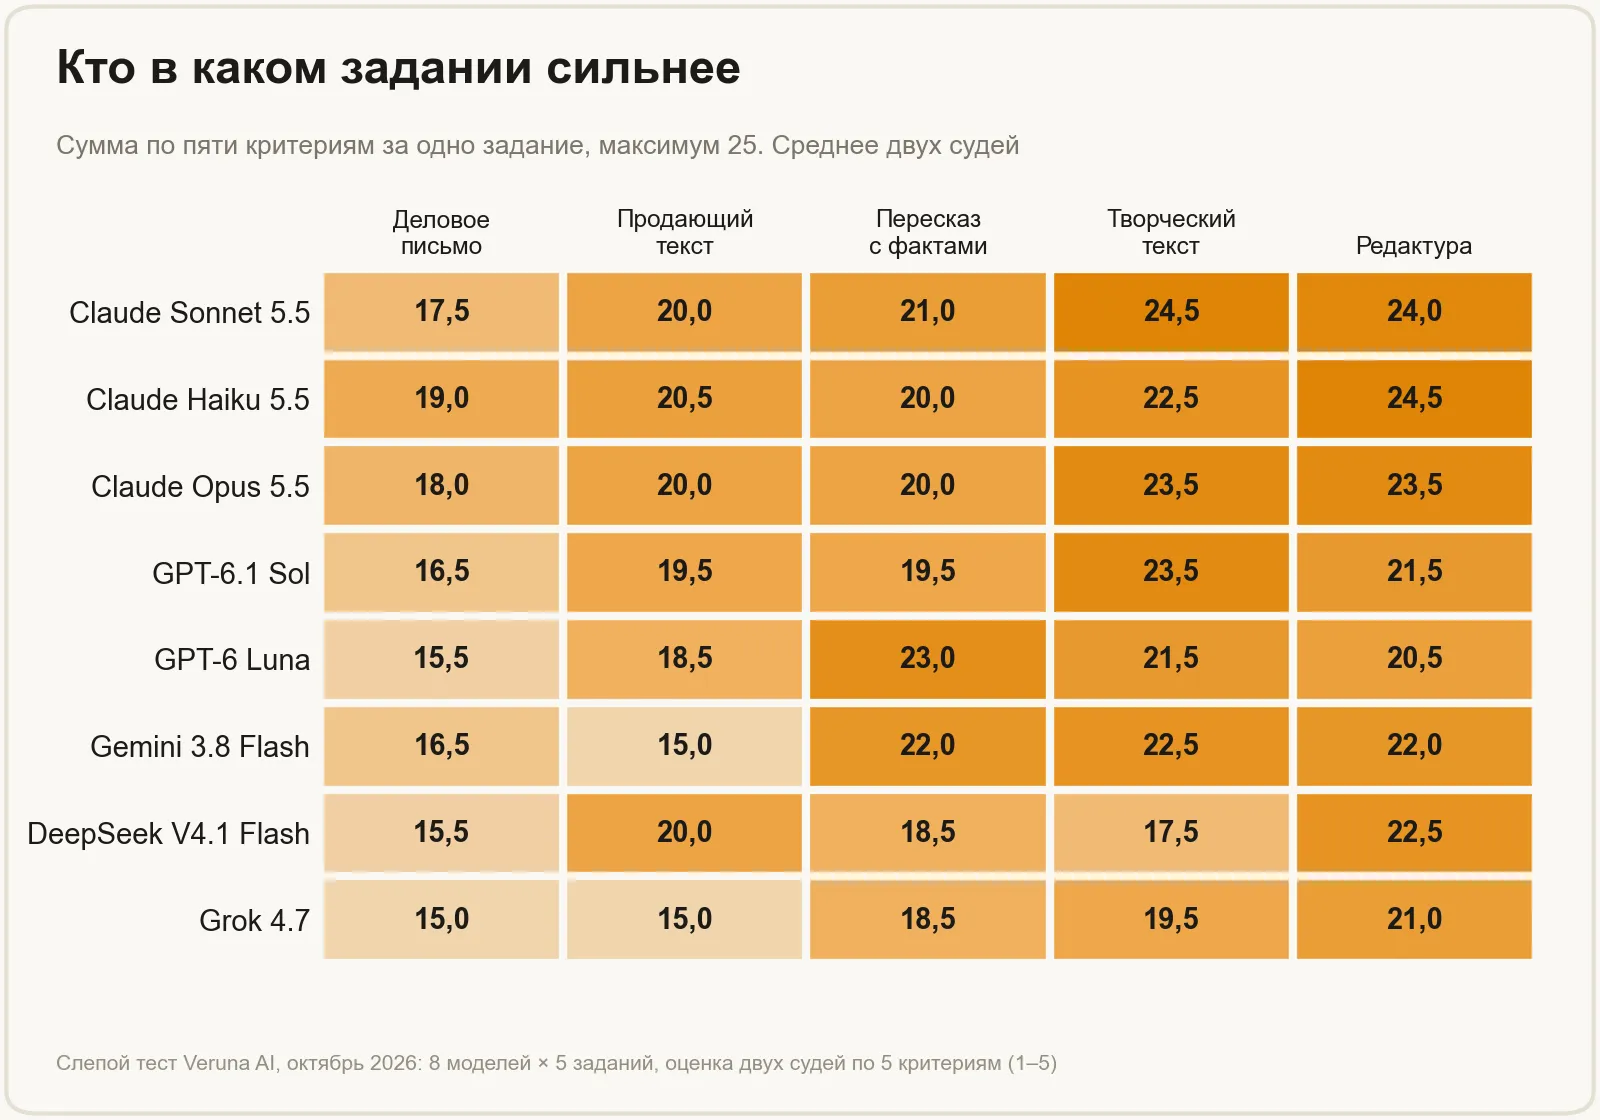
Результаты по заданиям показывают, что «лучшей на всё» модели нет.
Где тест ненадёжен
Слабых мест у теста хватает, и их лучше назвать самим.
Судьи спорят. Корреляция общих баллов двух судей — 0,52, то есть заметно ниже единицы. Судья Claude поставил выше всех три модели Claude (109, 108 и 107 баллов), а GPT-6 Luna дал 86. Судья GPT-6.1 Sol, наоборот, поставил первую строчку GPT-6 Luna (112), вторую себе (109), а Claude дал 103–106. Совпали они в одном: Grok 4.7 оказался в нижней части обоих списков. Не исключено, что каждый судья слегка предпочитает «свой» стиль, и проверить это внутри теста нельзя.
Выборка маленькая. Один текст на модель и задание. Другой запуск мог бы выдать письмо получше или похуже, поэтому доверять стоит крупным разрывам: Grok внизу, а не Sonnet на полбалла выше Haiku.
Живого редактора среди судей нет. Оценивали две нейросети по чек-листу.
Ещё одна особенность: в шести ответах Claude (из 15) после основного текста была приписка: сколько получилось слов или что «сегодня 14 октября». У остальных моделей таких приписок не было ни разу. Мы засчитали это как минус в критерии «следование заданию». Почему так вышло, мы проверить не можем: запросы шли через API-шлюз.
Мы сохранили все 40 текстов и оценки обоих судей, так что любую строчку этой статьи можно сверить с исходниками.
Цена и качество: за что вы платите
Мы сопоставили итоговый балл с ценой выходных токенов в API: они дороже входных у всех восьми моделей, а длинные тексты — это как раз выход.
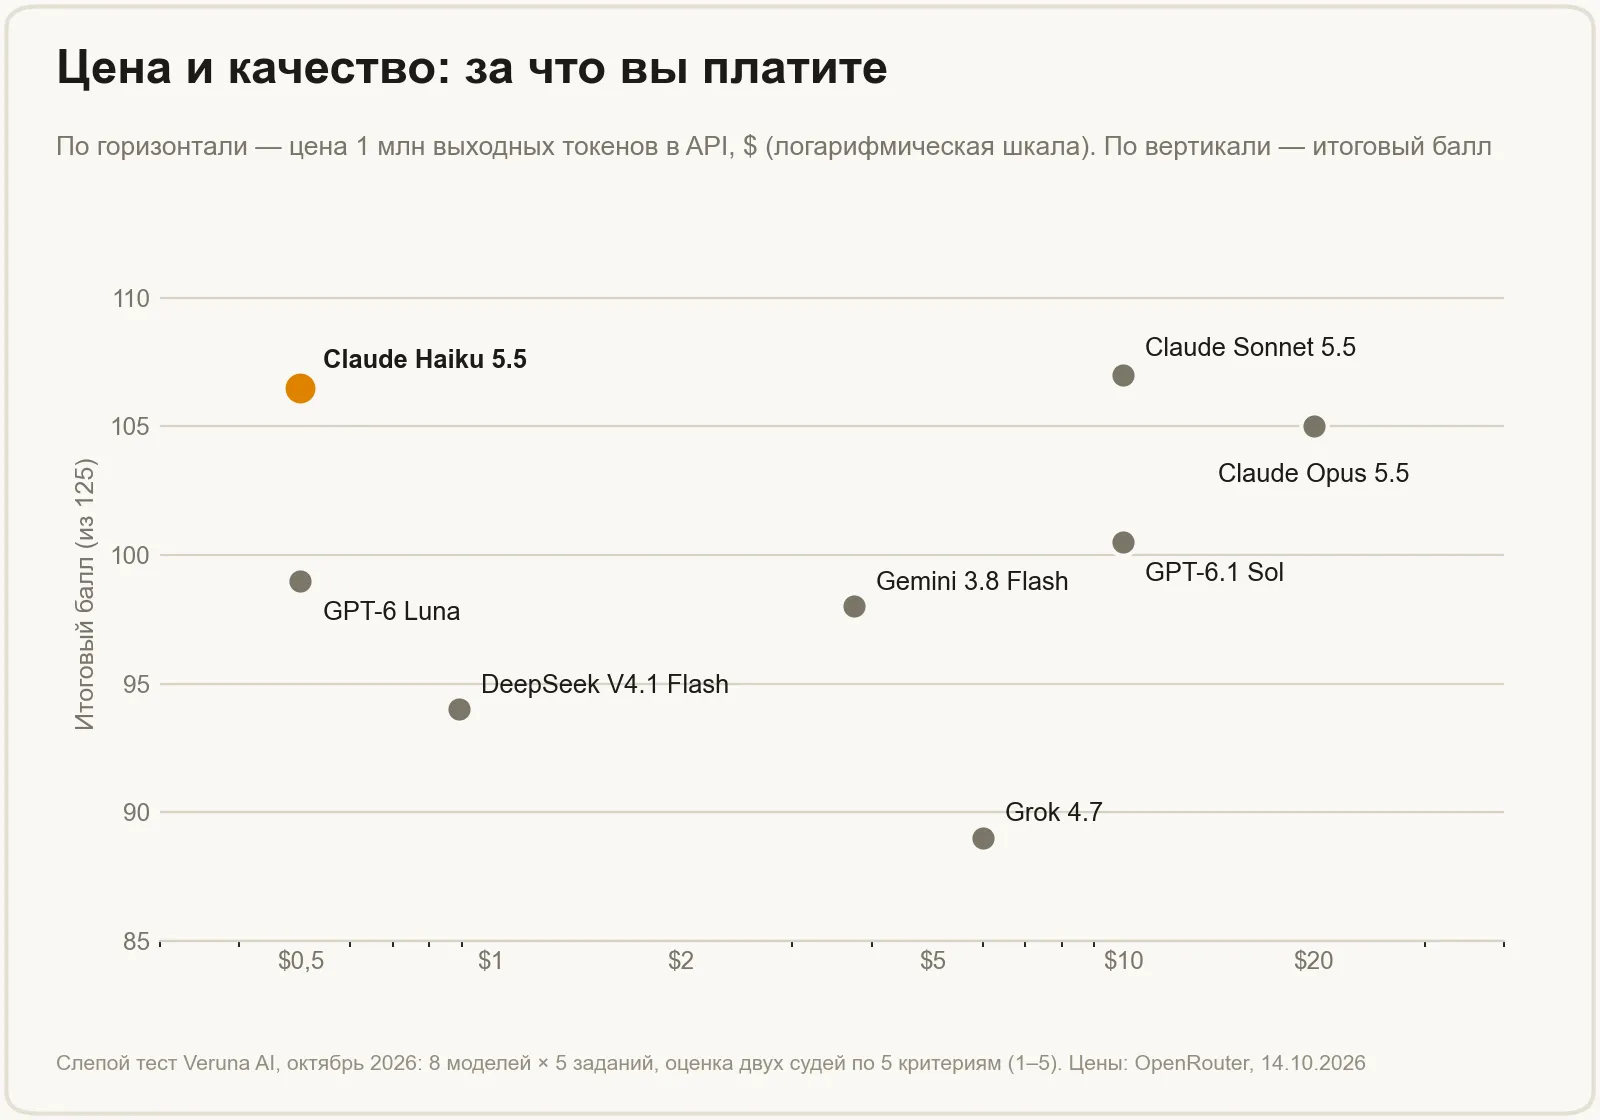
Самый заметный контраст: Claude Haiku 5.5 (0,50 доллара за миллион выходных токенов) набрала 106,5 балла, а Claude Opus 5.5 (20 долларов) — 105. Разница в цене в 40 раз, а в качестве на этом тесте её нет. Для массовых текстов (описания, письма, посты) дешёвая модель в нашем тесте справилась не хуже. Цены взяты из каталога OpenRouter на 14 октября 2026 года, они меняются.
Но подешевле не значит всегда: GPT-6 Luna стоит столько же, сколько Haiku, а набрала 99. И помните про приписки у Claude: при автоматической обработке такие хвосты придётся убирать.
Какую нейросеть брать под какую задачу
Из теста получилась такая шпаргалка. Это наблюдения на одном прогоне, а не приговор.
- Письма клиентам и редактура: Claude Haiku 5.5 лучшая в обоих заданиях, Opus и Sonnet близко. GPT-модели оставляют больше канцелярита.
- Продающие описания: в нашем тесте лучшим оказался Haiku (20,5), но разброс у моделей небольшой. Главное — смотреть на штампы: «надёжный спутник» легко проскакивает у любой.
- Пересказ и тексты строго по фактам: GPT-6 Luna (23 из 25) и Gemini 3.8 Flash (22): аккуратно держат рамки и не уходят в украшательства.
- Художественный текст: Sonnet (24,5) и Opus (23,5), у GPT-6.1 Sol тоже 23,5. DeepSeek V4.1 Flash и Grok 4.7 дали самые слабые рассказы.
Хотите глубже разобраться в том, как писать запрос для разных видов текста — читайте шаблоны запросов для любого формата. Про то, как убрать штампы из готового текста, у нас есть отдельный разбор. А если сомневаетесь, нужна ли вообще платная модель, посмотрите сколько стоят нейросети в 2026 и как выбрать нейросеть под задачу. Если интересует код, а не тексты, есть такое же сравнение для программирования.
Как повторить тест на своём тексте в Veruna AI
Пять наших заданий вряд ли совпадают с вашими. Возьмите свой реальный бриф: письмо клиенту, описание товара, пост. Запустите его на разных моделях и сравните результаты глазами, без подписей.
Обычно для этого приходится заводить аккаунты в нескольких сервисах и разбираться с оплатой. В Veruna AI это одно окно с доступом к 100+ нейросетям: ChatGPT, Claude, Gemini, DeepSeek, Grok и другим. Работает без VPN, оплата в рублях, начать можно бесплатно. Актуальный список моделей смотрите на сайте. Для текстов под ключ есть готовый ассистент-копирайтер.
Частые вопросы
Какая нейросеть лучше всего пишет на русском языке?
В нашем слепом тесте лучшие результаты показали Claude Sonnet 5.5, Claude Haiku 5.5 и Claude Opus 5.5 (105–107 баллов из 125), но разрыв между ними в пределах погрешности. Для заметки строго по фактам лучше оказалась GPT-6 Luna. Универсального победителя нет, всё зависит от задачи.
Почему тексты нейросетей звучат одинаково?
Они опираются на самые частотные обороты, поэтому в каждом задании мы видели одни и те же штампы: «надёжный спутник», «искренние извинения», «в ритме города». По штампам ни одна из восьми моделей не получила больше 3,6 из 5. Помогает конкретный бриф и просьба убрать клише, а готовый текст стоит прогнать через чистку признаков ИИ.
Платная нейросеть всегда пишет лучше?
Нет. В тесте Claude Haiku 5.5 за 0,50 доллара за миллион выходных токенов набрала 106,5 балла, а Claude Opus 5.5 за 20 долларов — 105. Дорогая модель может дать больше на сложных задачах, но на этих пяти текстах преимущества не было.
Как проверить нейросеть на своей задаче?
Возьмите реальный бриф, запустите его на нескольких моделях и уберите подписи. Оцените по пяти вопросам: нет ли канцелярита, нет ли заезженных оборотов, нет ли ошибок, нет ли выдуманных фактов, цепляет ли текст. Один запрос ничего не доказывает, повторите на трёх-пяти разных брифах.