
Кратко
- DeepSeek V4.1 Flash вышла 10 сентября 2026 года: 552 млрд параметров в MoE, контекст 1 млн токенов, вход текстом и картинками, веса выложены открыто под лицензией MIT.
- Главная новость релиза — младшая модель обошла старшую: по собственным замерам DeepSeek V4.1 Flash опережает флагманскую V4 Pro почти на всех тестах, а стоит вчетверо дешевле на входе и втрое с лишним на выходе.
- Архитектура новая: Causal Encoder-Decoder, где на входе работает 8 млрд активных параметров, а на выходе 16 млрд. KV-кэш ужался до 890 байт на токен — примерно вчетверо против прошлого поколения.
- Цена в льготные часы — $0,15 за миллион входных токенов и $0,60 за выходные, и льготные часы здесь не редкое окно, а режим по умолчанию.
DeepSeek V4.1 Flash — новая модель китайской DeepSeek, вышедшая 10 сентября 2026 года, и запрос «дипсик новая версия» сейчас ведёт именно к ней. В рунете её ищут по-разному: «дипсик 4.1», «дипсик флеш», «дипсик 4 флеш» — речь везде об одном релизе. Дальше разберём, что у модели под капотом, какие цифры она показала, чем отличается от V4 Pro и где заявленный результат держится на одной конкретной обвязке.
Дата выхода и что именно вышло
DeepSeek V4.1 Flash появилась 10 сентября 2026 года, новые тарифы API заработали в тот же день в 04
UTC. Вместе с моделью компания выложила открытые веса на HuggingFace под лицензией MIT и технический отчёт с говорящим названием — «Pushing the Limits of KV Cache Compression», то есть «выжимаем максимум из сжатия KV-кэша» (DeepSeek, карточка весов на HuggingFace). Это подсказывает, на чём сделан акцент: не на эрудиции, а на том, чтобы большая модель дёшево обслуживала длинный контекст.Отдельная ловушка для тех, кто идёт в API: идентификатор модели — deepseek-flash, без номера версии. Имена прошлого поколения, deepseek-v4-flash и deepseek-v4-flash-vision-exp, выведены из обращения, а запросы к ним временно направляются на V4.1 Flash и считаются по её тарифу. Вариант deepseek-v4.1-flash существует только у роутера OpenRouter, у самой DeepSeek такого имени нет.
DeepSeek V4.1 Flash: характеристики
| Параметр | Значение |
|---|---|
| Идентификатор в API | deepseek-flash |
| Дата выхода | 10 сентября 2026 года |
| Параметры | 552 млрд в MoE, активны 8 млрд на входе и 16 млрд на выходе |
| Контекстное окно | 1 000 000 токенов |
| Максимальный ответ | 384 000 токенов |
| Вход | текст, изображения |
| Выход | только текст |
| Режим рассуждений | есть оба, thinking включён по умолчанию; глубина reasoning_effort задаётся числом от 1 до 100 |
| Цена ввода | $0,15 за млн токенов в льготные часы, $0,30 в пиковые |
| Цена вывода | $0,60 за млн токенов в льготные часы, $1,20 в пиковые |
| Чтение из кэша | $0,003 за млн токенов в льготные часы |
| Лимит параллельных запросов | 2500 |
| Веса и лицензия | открытые, MIT, deepseek-ai/DeepSeek-V4.1-Flash на HuggingFace |
Все параметры тарификации и лимитов здесь и далее — из официальной документации API (api-docs.deepseek.com).
Миллион токенов контекста — это порядка полутора тысяч страниц за один заход, и ограничение тут скорее в ответе: 384 тысячи токенов на выход всё же конечны, хотя для любого практического сценария этого с запасом.
Картинки модель понимает нативно: зрительный энкодер DeepSeek-ViT обучали не отдельно, а вместе с языковой моделью с самого начала предобучения — всего через модель прошло 45 триллионов мультимодальных токенов. Генерации изображений при этом нет, на выходе только текст.
Что такое Causal Encoder-Decoder
Самое интересное в релизе — архитектура. Обычная языковая модель обрабатывает и промпт, и собственный ответ одним и тем же стеком слоёв. DeepSeek разделила эти две работы: сорок слоёв разбиты на двадцатислойный каузальный энкодер, который читает вход, и двадцатислойный декодер, который пишет ответ. Глобальный KV-кэш декодера проецируется из финальных скрытых состояний энкодера, а не собирается послойно, как раньше.
Практический смысл — в цифрах активных параметров. На чтении промпта включается 8 млрд параметров, на генерации ответа — 16 млрд, при общем размере модели в 552 млрд. Для сравнения, прошлая V4 Flash весила 284 млрд и активировала 13 млрд, а флагманская V4 Pro — 1,6 трлн и 49 млрд. То есть новая модель вдвое крупнее предшественницы, но включает на запрос меньше, чем она.
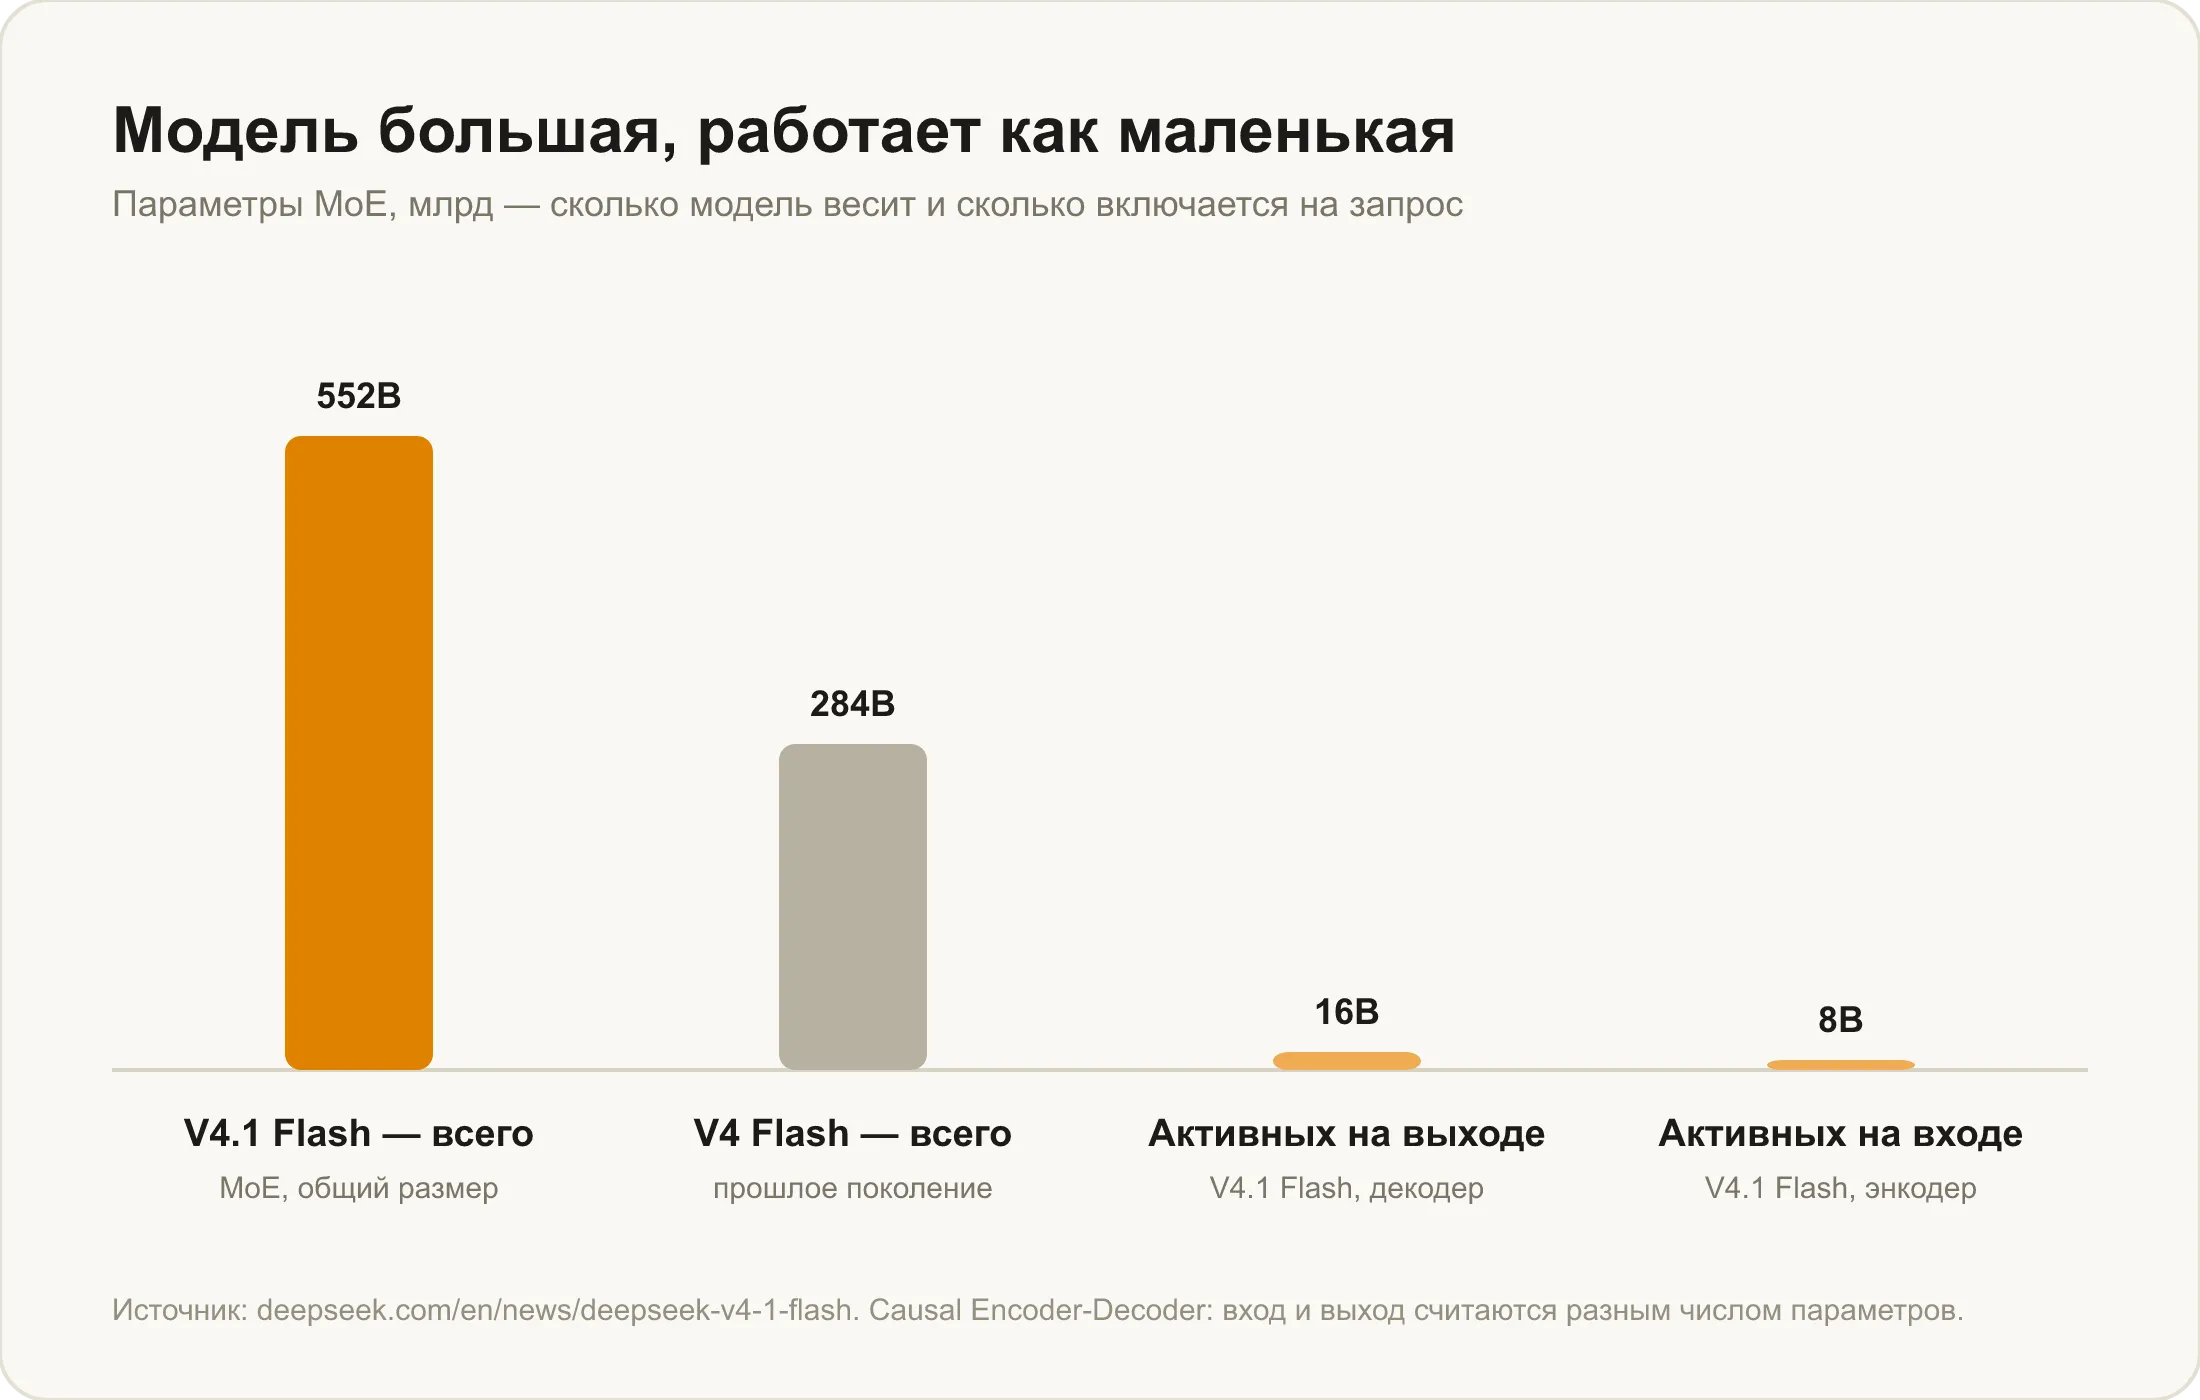
Второй результат этой перестройки — память. KV-кэш ужался до 890 байт на токен, примерно вчетверо против V4 Flash, а постоянный след на диске — примерно в восемь раз. Именно это и делает контекст в миллион токенов не маркетинговой строкой, а тем, за что можно платить $0,15 за миллион. Похожим путём шла и Z.ai в GLM-5.2, только там ставку сделали на разреженное внимание, а не на разделение энкодера и декодера.
Бенчмарки: младшая модель обошла старшую
Главный тезис релиза — V4.1 Flash обходит V4 Pro по качеству, цене, скорости и общему времени работы. По собственной таблице DeepSeek это выглядит так: правки в реальных кодовых базах (DeepSWE v1.1) — 74,2% против 62,7%; работа в терминале (Terminal-Bench 2.1) — 90,6% против 87,9%; автоматизация рутинных операций (AutomationBench) — 54,8% против 43,2%; долгие агентные задачи (Agent's Last Exam) — 31,8% против 25,7%; поиск уязвимостей (CyberGym) — 88,1% против 83,3% (карточка весов DeepSeek).
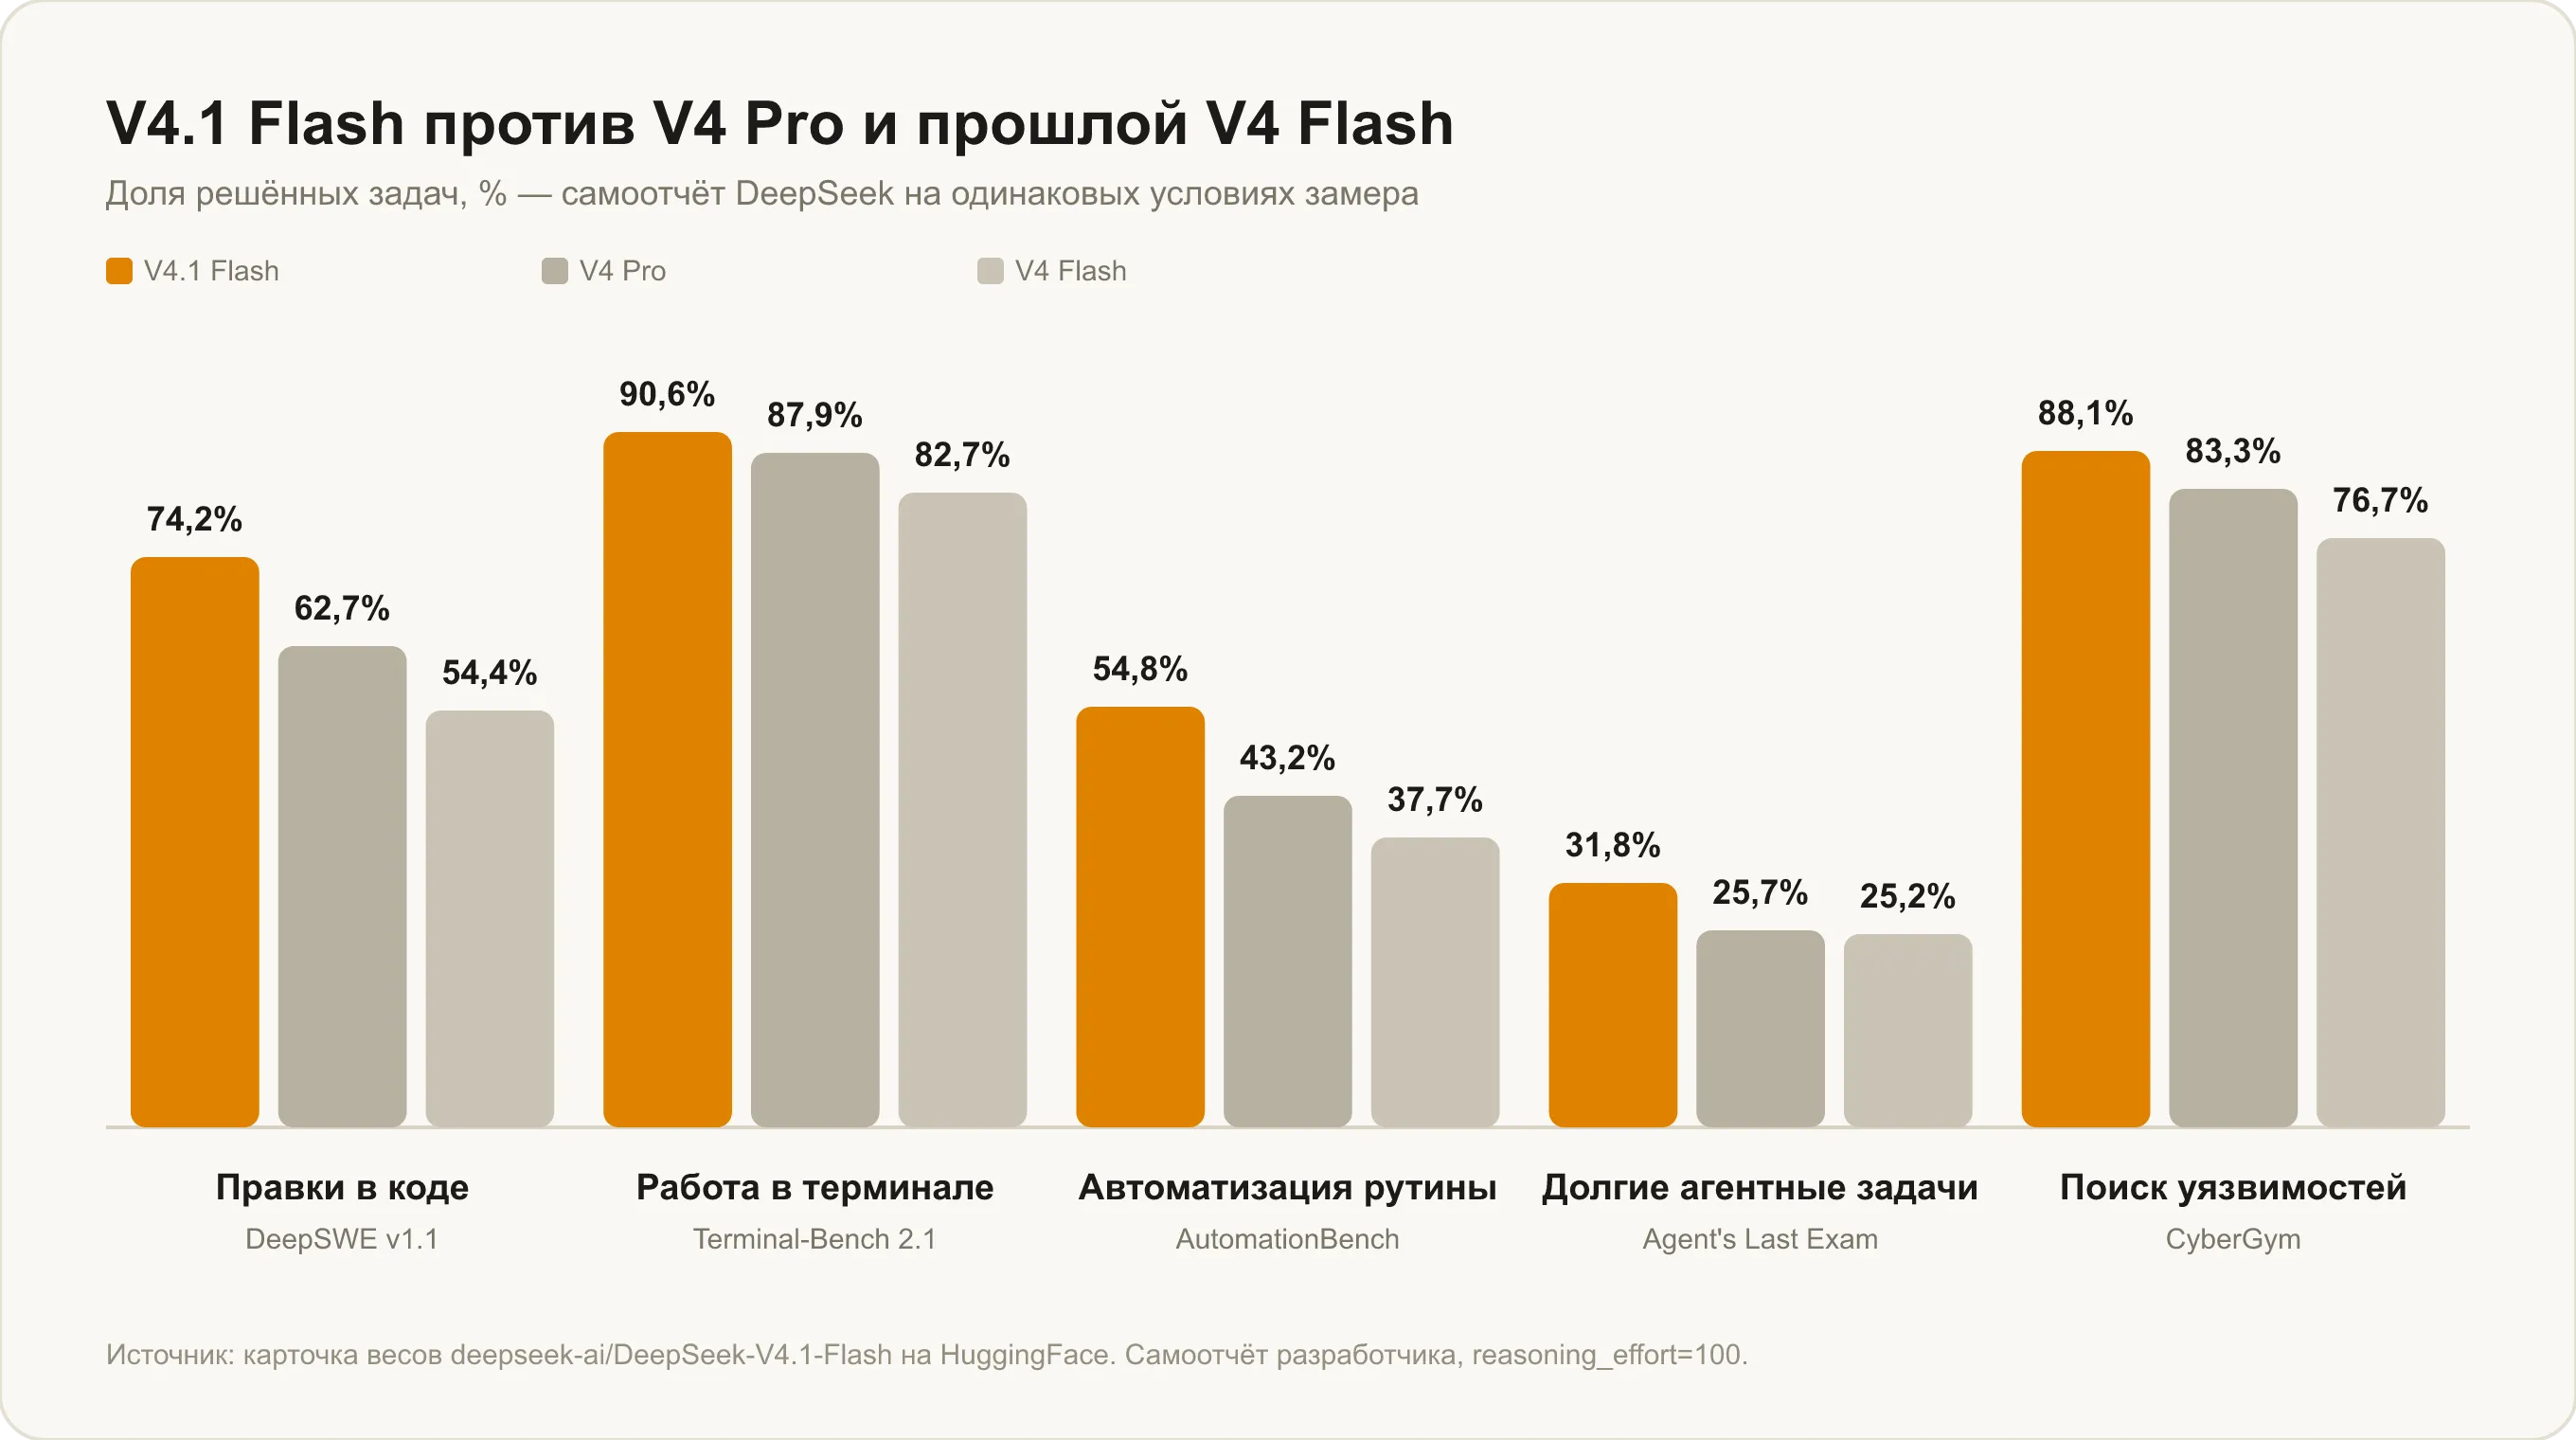
Разрыв со старшей моделью на правках кода — больше одиннадцати пунктов, и это при том, что V4 Pro втрое крупнее по числу параметров. Случай, когда новое поколение архитектуры перевешивает размер, — не частый, поэтому релиз и вызвал столько разговоров.
Если смотреть шире одной компании, 74,2% на DeepSWE v1.1 ставят V4.1 Flash вплотную к западным флагманам. Наши прежние разборы дают такую расстановку: Muse Spark 1.3 — 75,4%, GPT-6 Astra — 74,1%, Claude Opus 5 — 74,0%, Gemini 3.8 Flash — 73,7%, GPT-5.6 Sol Max — 72,7%, MiMo-V2.6-Pro от Xiaomi — 71,9%, Grok 4.7 — 71,0%, Claude Fable 5.1 — 70,0%.
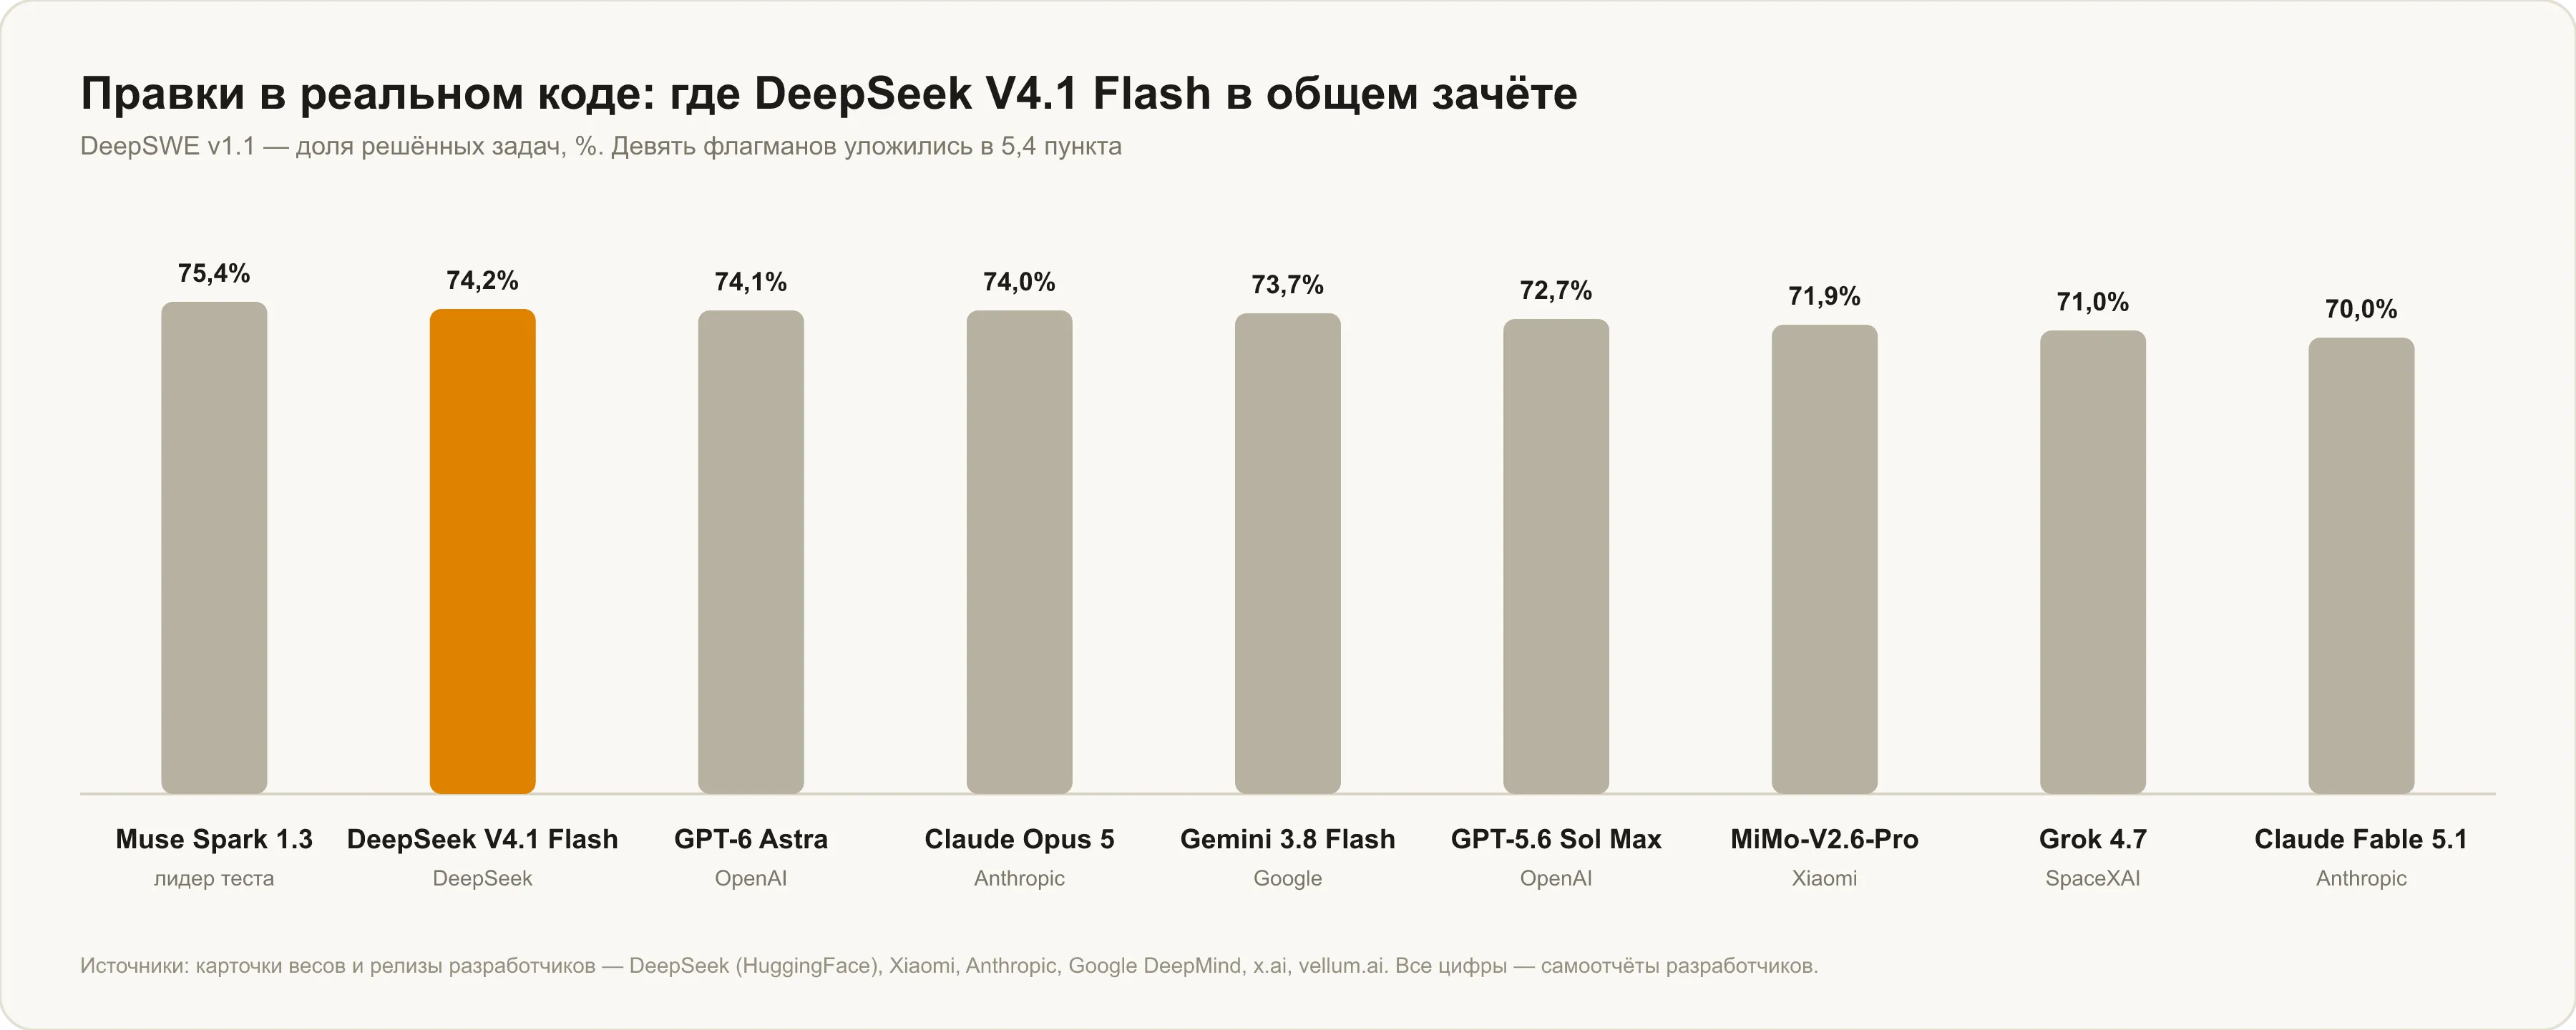
Девять моделей уложились в 5,4 процентных пункта. Выбирать нейросеть под код по такому разрыву бессмысленно — про это мы отдельно писали в разборе, какая нейросеть лучше пишет код.
Честно: цифра 74,2 — верхняя граница
Здесь DeepSeek поступила непривычно откровенно и сама опубликовала то, что обычно остаётся за кадром: один и тот же тест на одной и той же модели прогнали через восемь разных агентных обвязок. Результаты — от 74,2% до 65,5%, разброс почти девять пунктов.
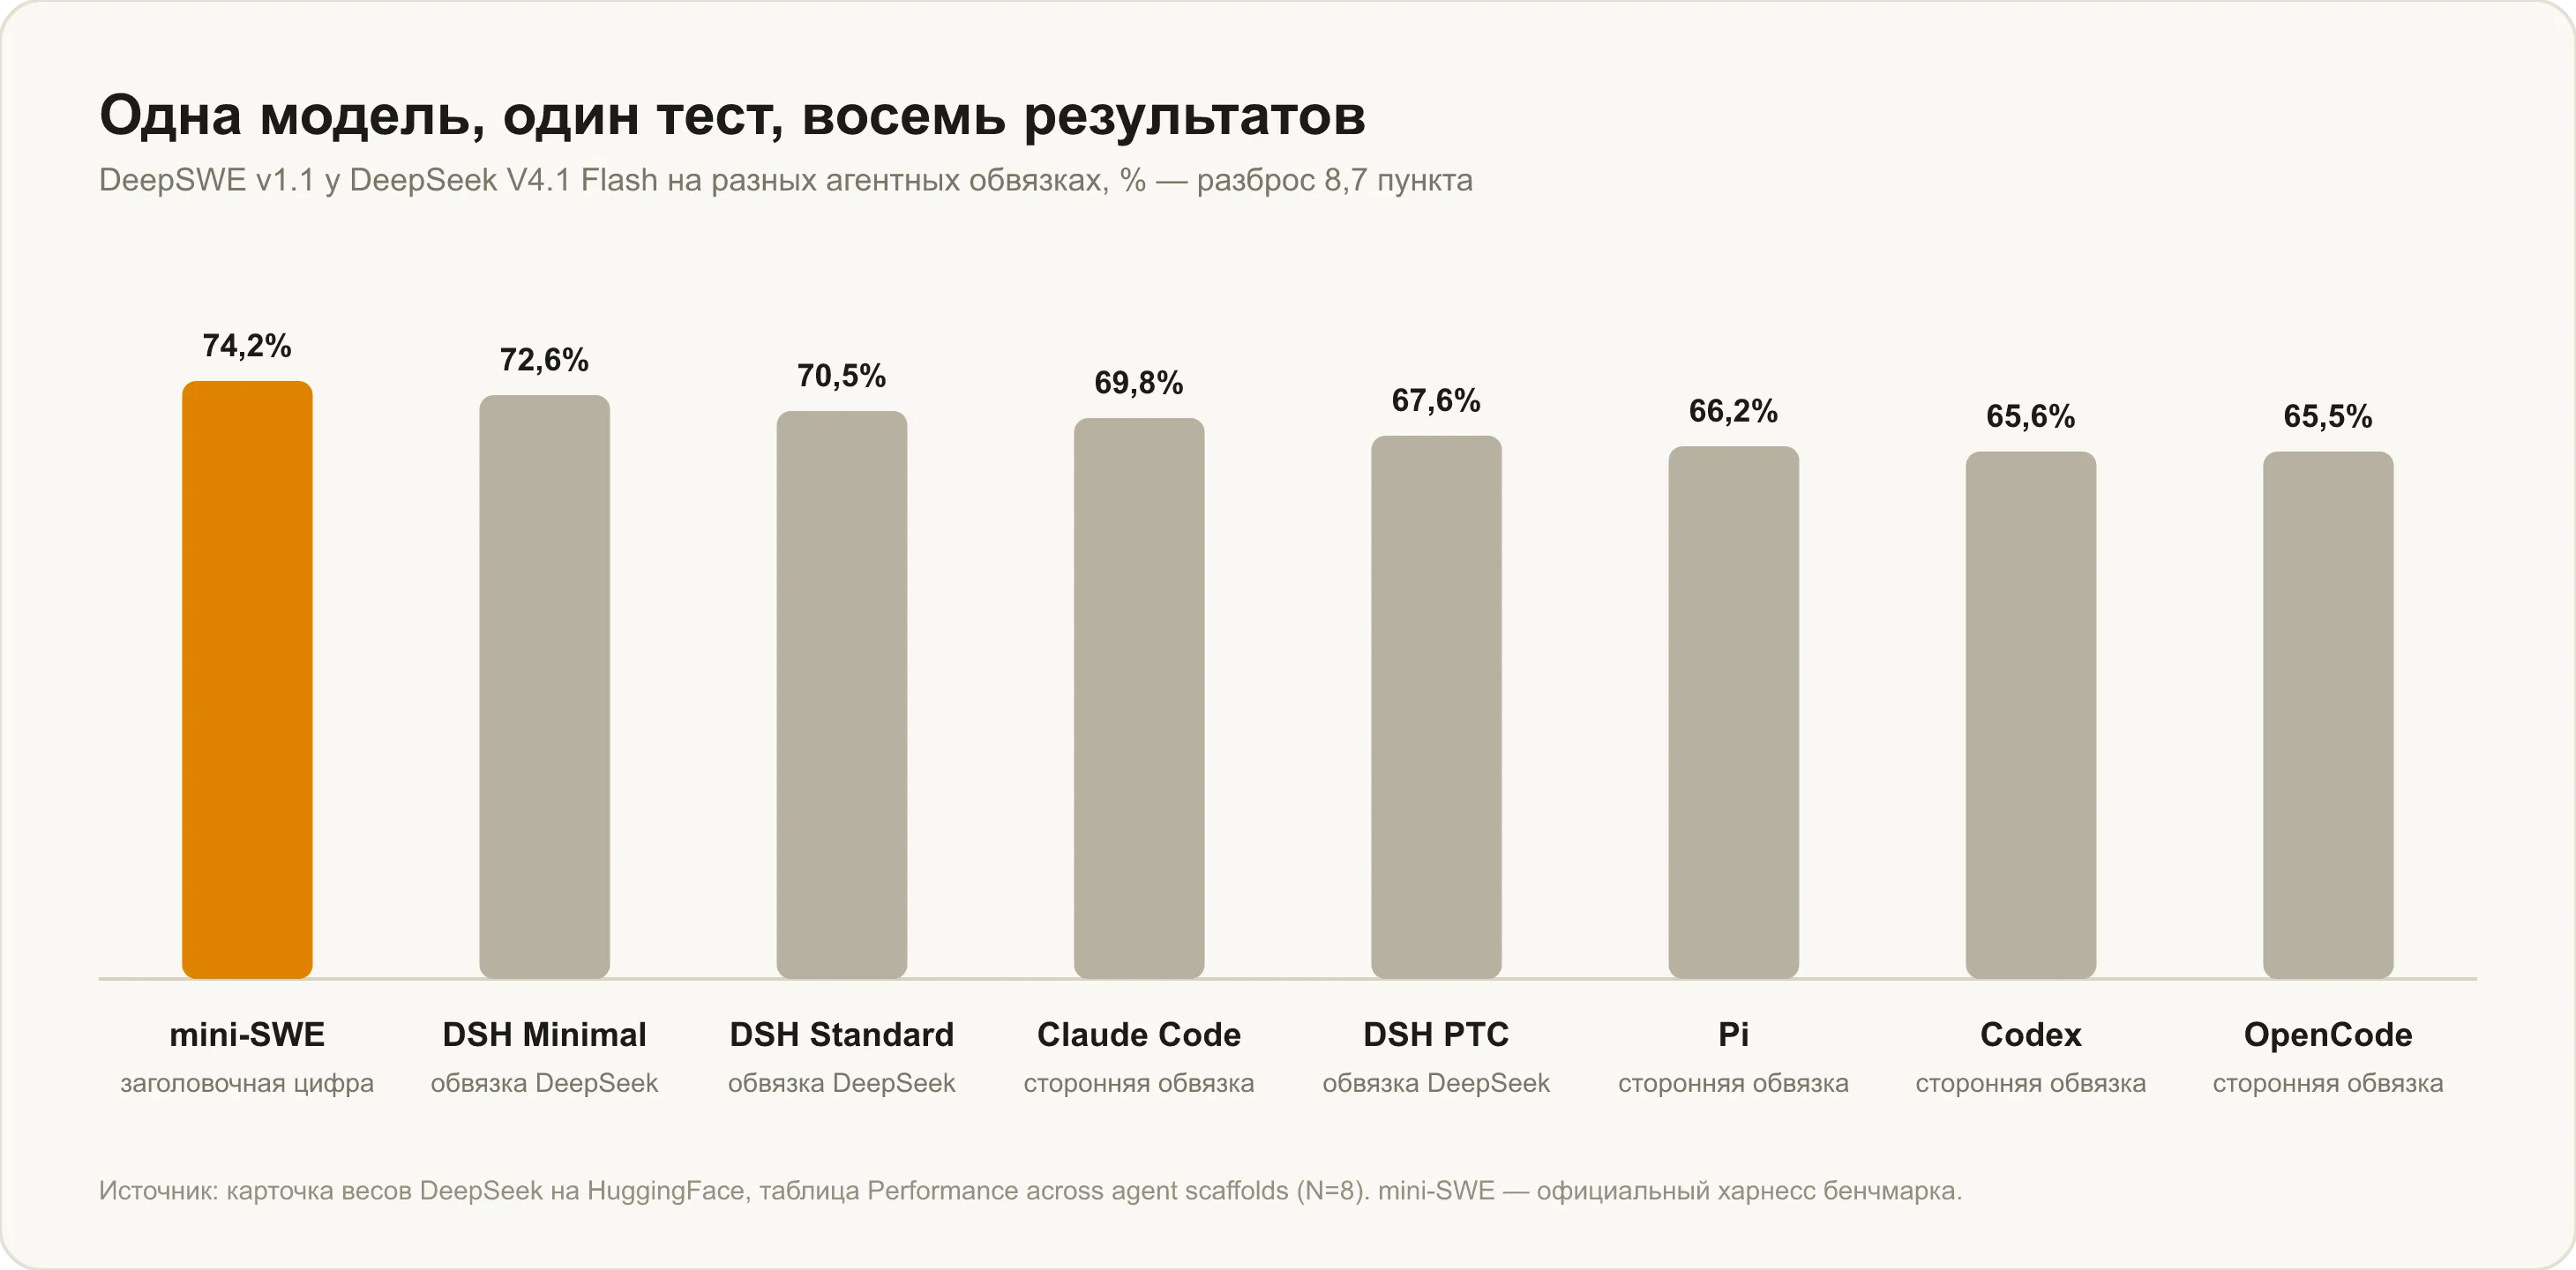
Заголовочные 74,2% получены на mini-SWE — официальной обвязке самого бенчмарка, так что выбор обоснован. Но под Claude Code та же модель даёт 69,8%, а под OpenCode — 65,5%. Вывод для читателя простой: сравнивать 74,2% с чужими цифрами корректно только если те тоже замерены на mini-SWE, а в реальной работе результат будет зависеть от того, в какой инструмент вы модель вставили.
Вторая поправка — все цифры выше публикует сама DeepSeek, включая результаты чужих моделей в своей таблице. Независимых прогонов, где все эти модели прогнали бы одной командой в одинаковых условиях, пока нет, так что расстановка в пределах пары пунктов — вопрос доверия к вендорским замерам, а не измеренный факт.
Где модель проседает
Обратная сторона видна на том же терминале, только в версиях посложнее. На Terminal-Bench 2.1 у V4.1 Flash 90,6% и первое место в таблице DeepSeek. На Terminal-Bench 3.0 — уже 30,0% против 43,3% у Claude Opus 5, а на Terminal-Bench 4.0 — 31,2% против 51,8%.
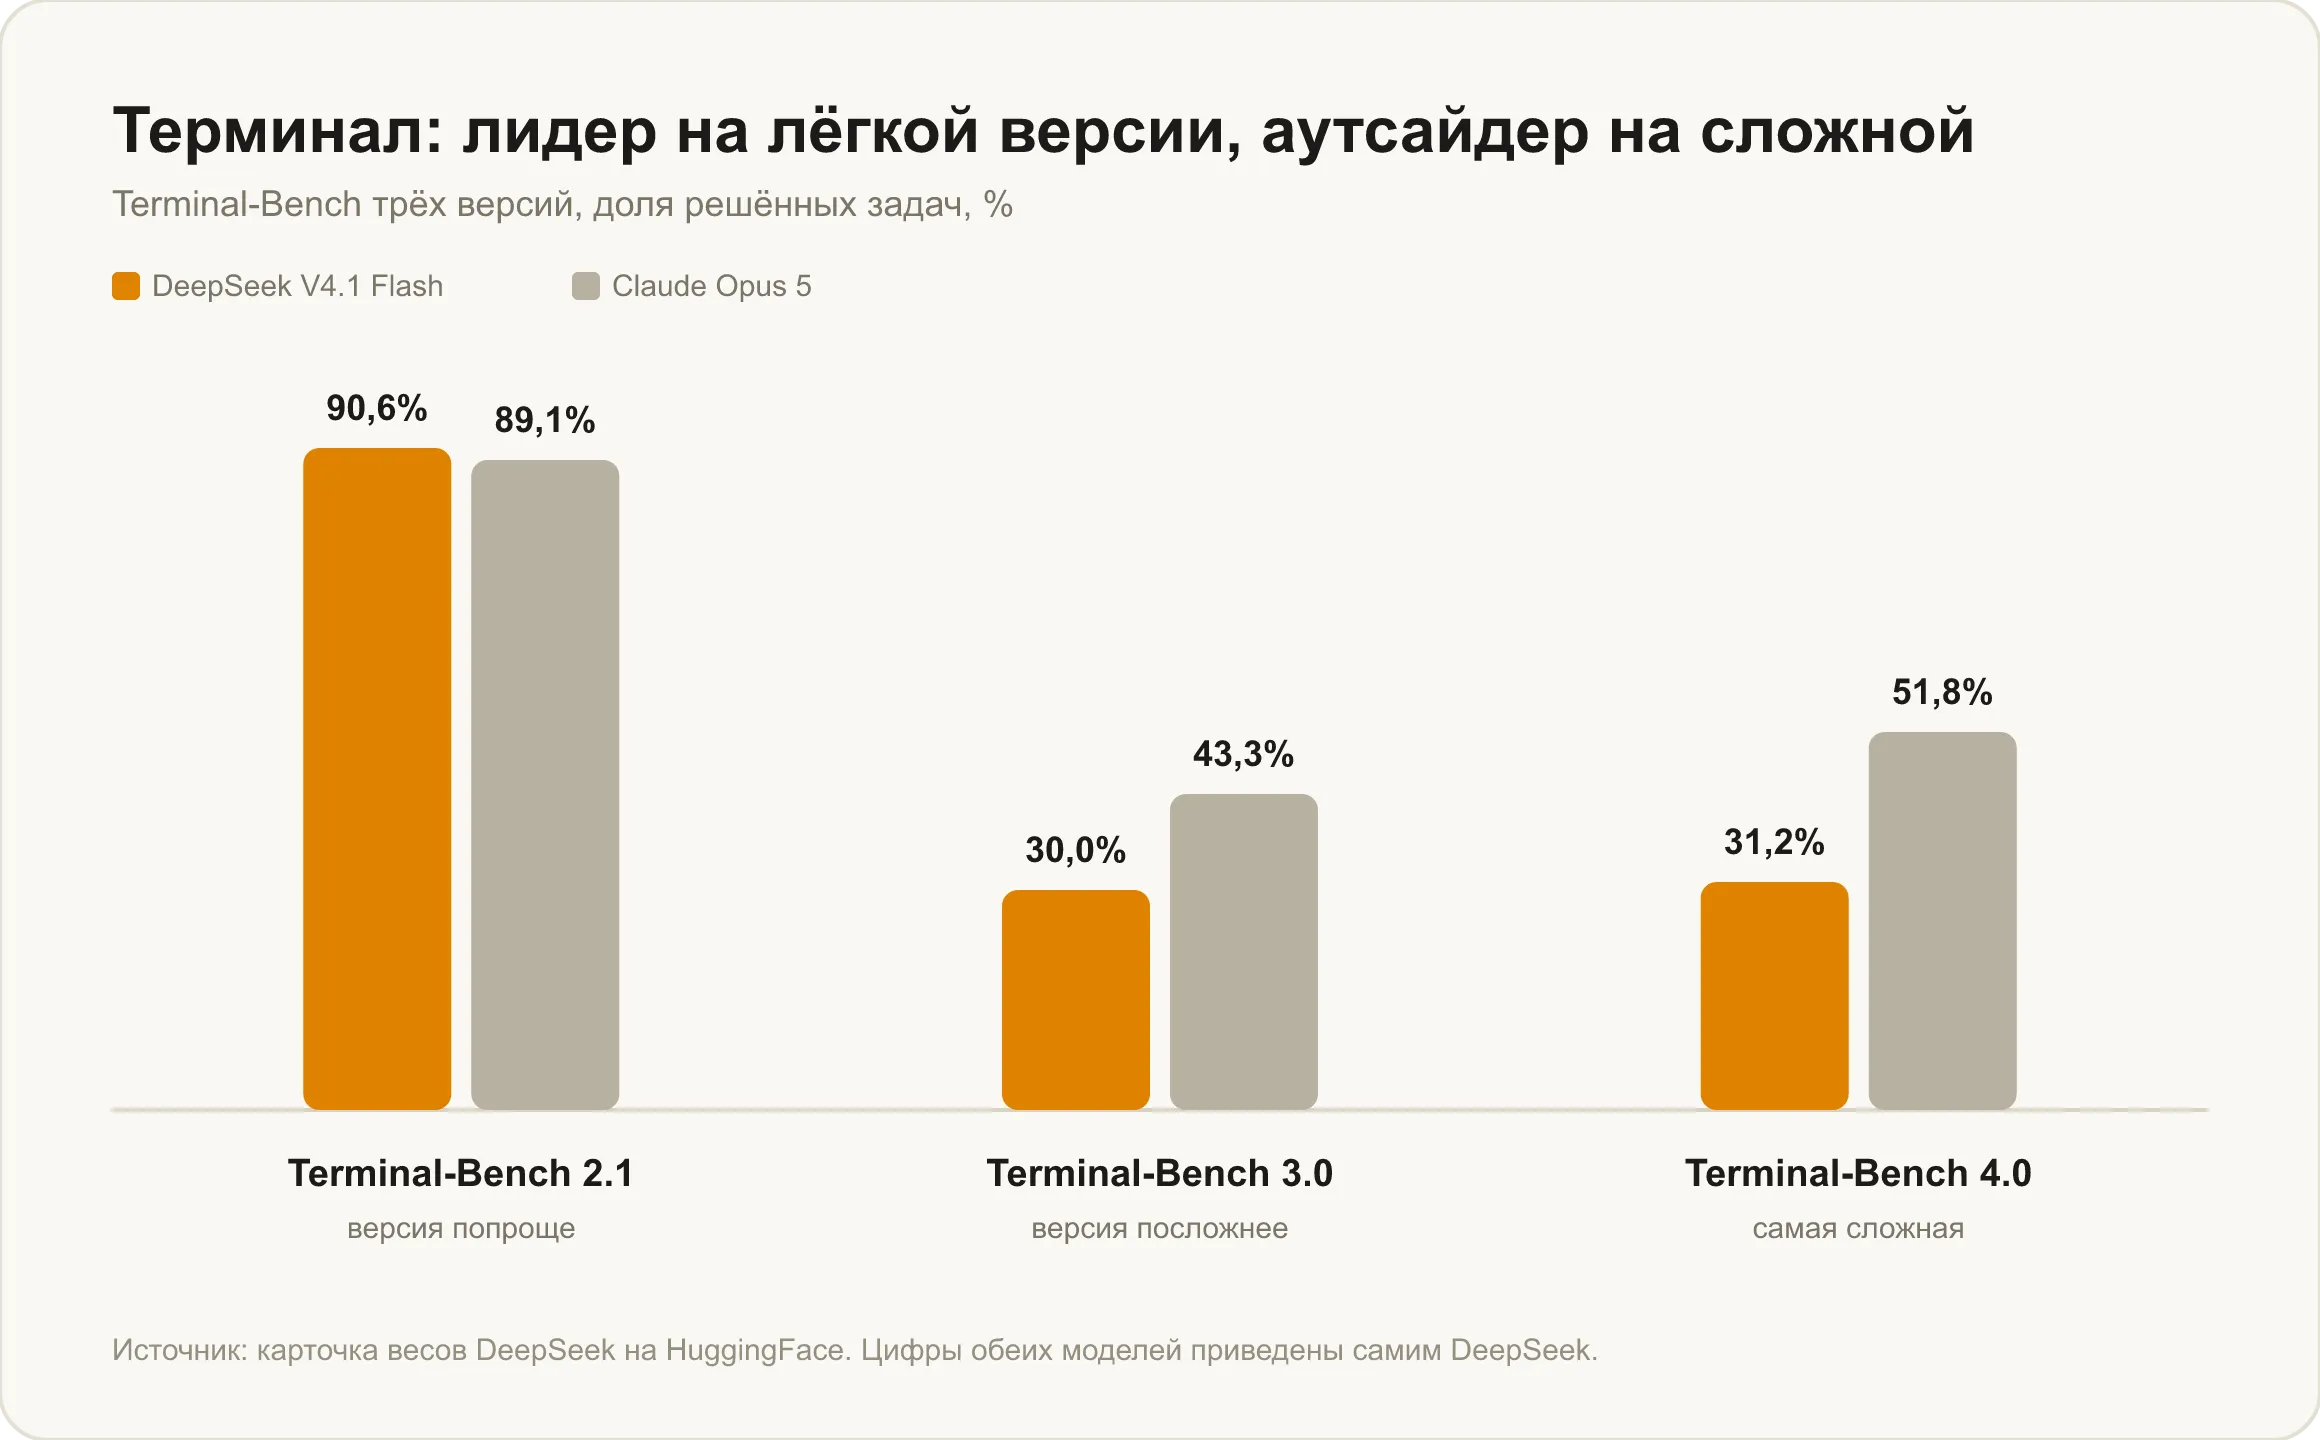
Это не противоречие в данных, а три разных теста: 2.1, 3.0 и 4.0 отличаются сложностью задач. Пересказы, где указан только один «Terminal-Bench 90,6», вводят в заблуждение — на трудных сценариях модель отстаёт от флагманов заметно.
Похожая картина на знаниевых тестах. Humanity's Last Exam без инструментов: 36,8% против 56,3% у Opus 5, разрыв почти двадцать пунктов. У этого теста несколько вариантов прогона — с инструментами, без них и только по текстовой части, — и цифры между ними не сравниваются: на текстовом подмножестве у V4.1 Flash 39,1%, а с инструментами уже 63,9%. На NL2Repo-Bench 64,0% против 75,3%, на ProgramBench 20,3% против 37,0%. Визуальные агентные задачи тоже ниже: Chartography 78,9% против 84,0%, BabyVision 89,6% против 94,1%.
Читается это так: V4.1 Flash сильна там, где нужно дёшево и много работать с кодом и длинным контекстом, и слабее там, где нужна широкая эрудиция или по-настоящему трудный многошаговый сценарий.
Независимый замер: индекс, скорость и многословность
Агрегатор Artificial Analysis поставил DeepSeek V4.1 Flash 39 баллов в сводном индексе интеллекта — при медиане 18 у сопоставимых моделей. Скорость на API самой DeepSeek — 225,6 токена в секунду, время до первого токена — 0,92 секунды (Artificial Analysis).
Одна оговорка, без которой легко сделать ложный вывод: сравнивать эти 39 баллов с числами из наших прежних статей про Claude Fable 5.1 или GPT-6 Astra нельзя. Агрегатор перевёл индекс на версию 4.3.2 с новой шкалой, и баллы разных версий между собой несопоставимы.
Полезнее другое наблюдение Artificial Analysis: на прогоне индекса модель сгенерировала 250 млн выходных токенов при медиане 140 млн. То есть V4.1 Flash заметно многословна, и часть выигрыша от дешёвого токена съедается их количеством. Полный прогон индекса обошёлся в $476,89 — но считали по пиковому тарифу, в льготные часы вышло бы вдвое меньше.
Сколько стоит DeepSeek V4.1 Flash
Официальный прайс — $0,15 за миллион входных токенов и $0,60 за выходные в льготные часы, $0,30 и $1,20 в пиковые. Чтение из кэша стоит $0,003 и $0,006 соответственно.
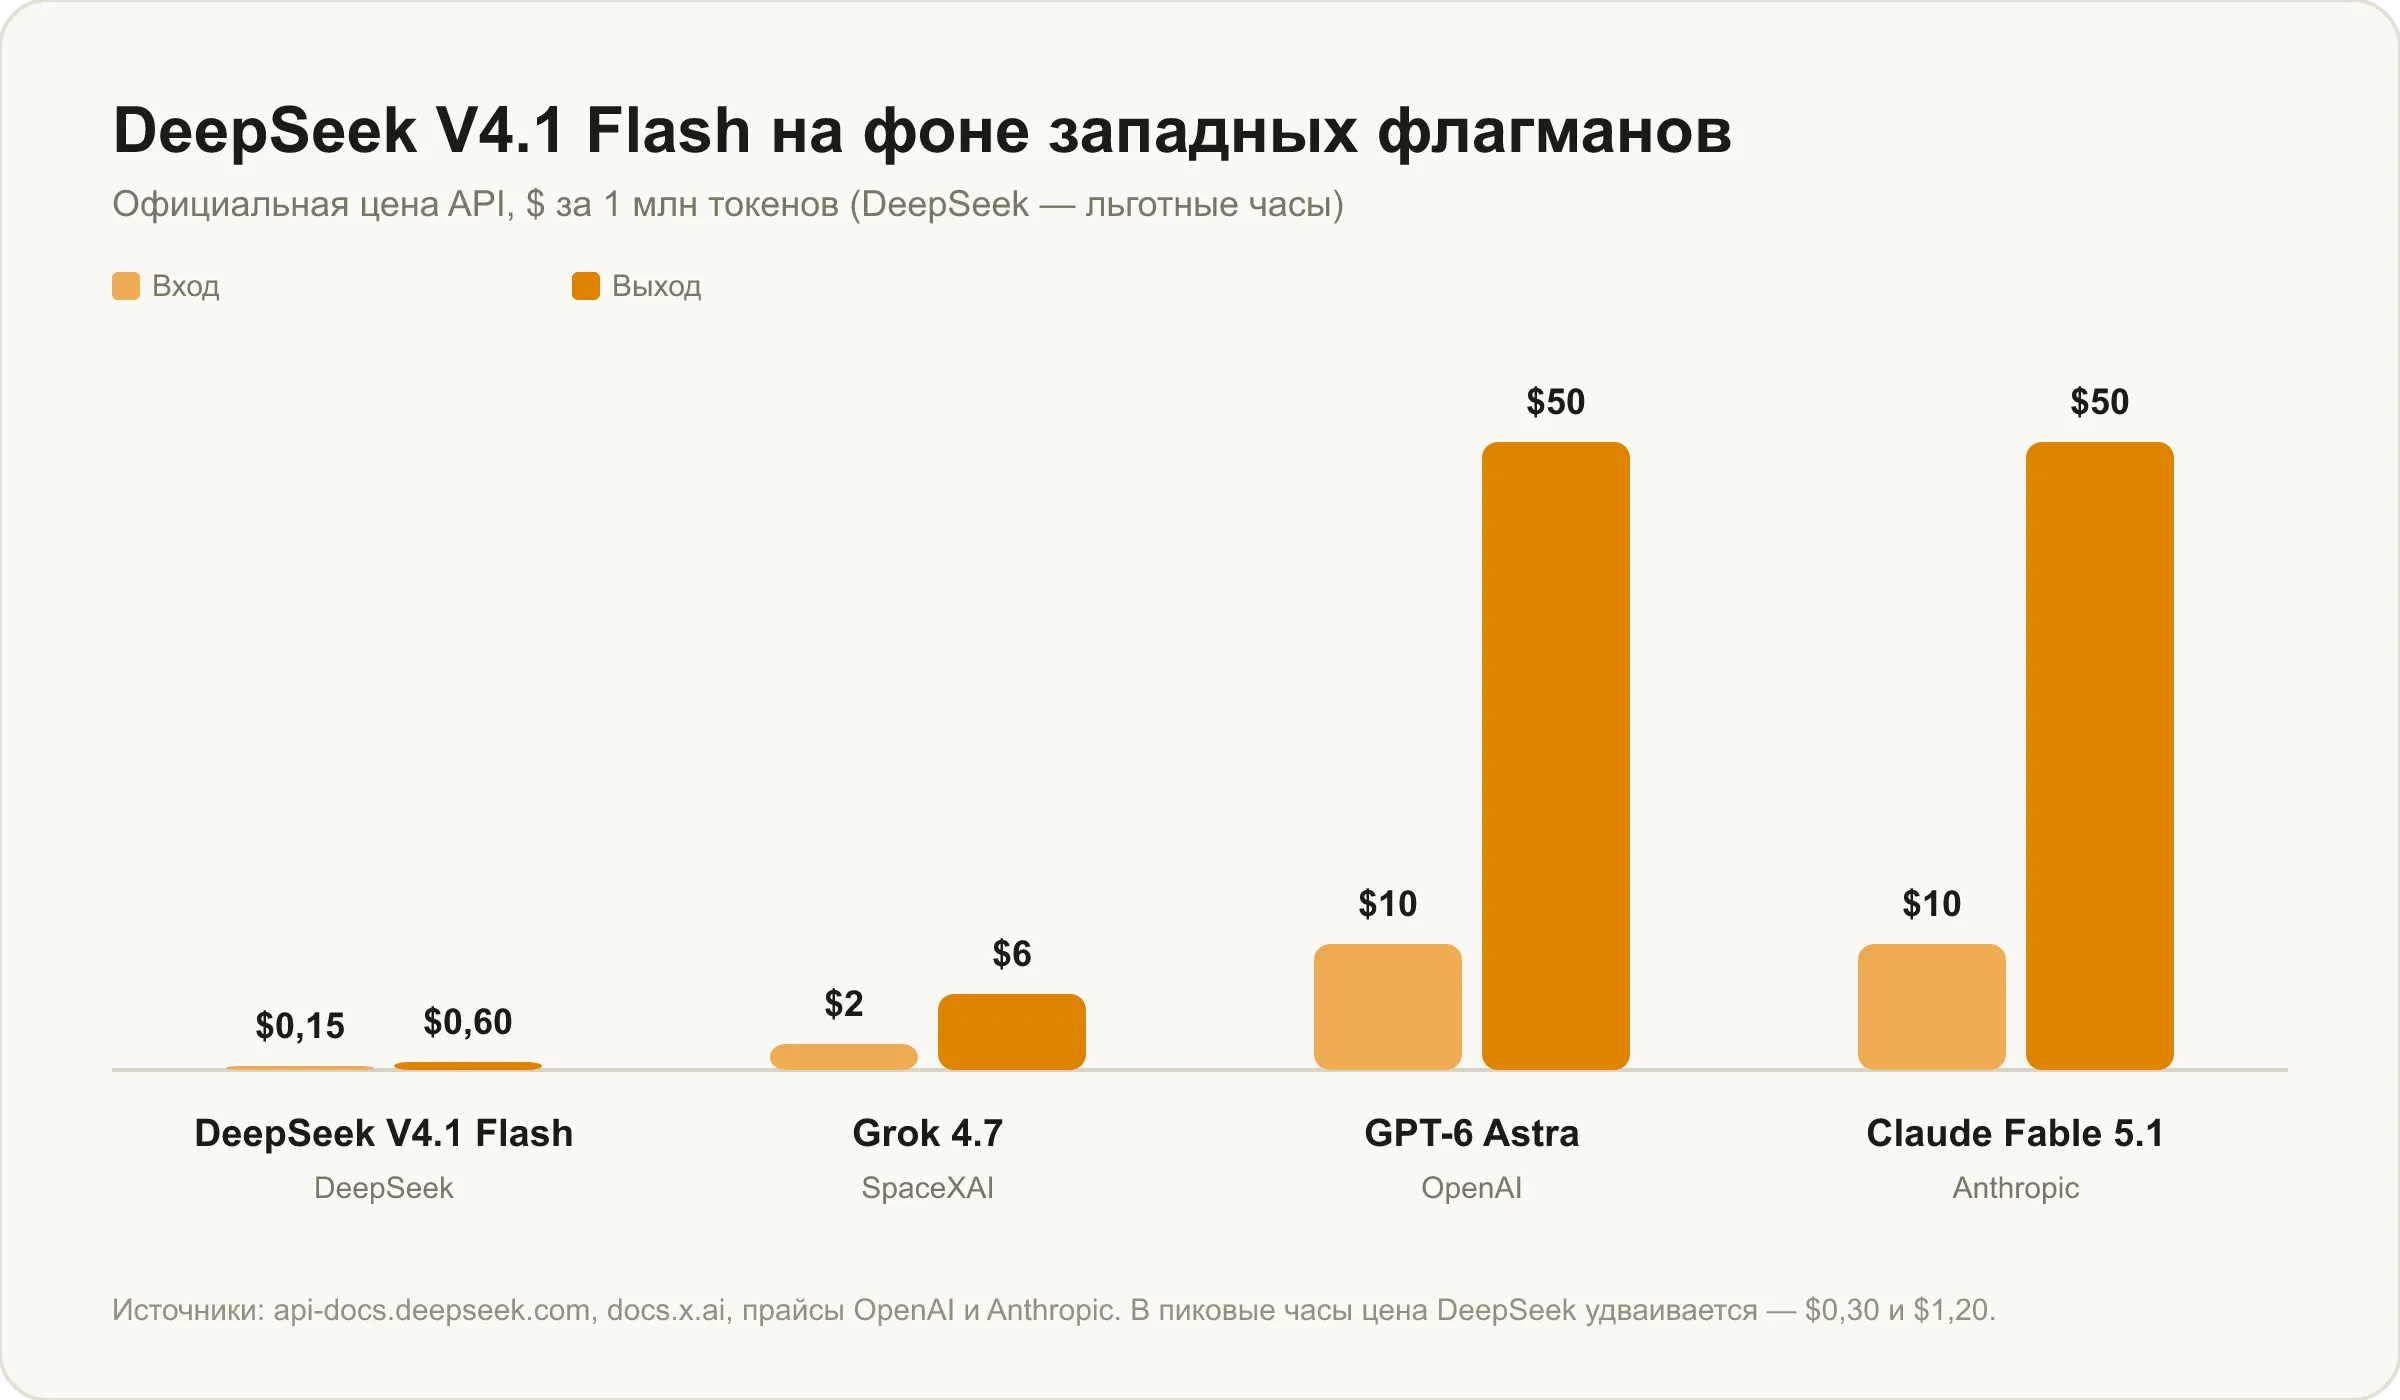
Важная деталь, которую часто перевирают: пиковые часы у DeepSeek — это 01
–04 и 06–10 UTC с понедельника по пятницу, то есть примерно 04–07 и 09–13 по Москве. Всё остальное время, включая выходные целиком, идёт по льготной цене. Поэтому $0,15 и $0,60 — не редкая акция, а режим по умолчанию для большей части суток.На фоне западных флагманов разрыв кратный: у GPT-6 Astra и Claude Fable 5.1 тот же объём стоит $10 и $50, у Grok 4.7 — $2 и $6. Сколько при этом стоят подписки на разные нейросети, мы считали отдельно — в материале сколько стоят нейросети в 2026 году.
Что будет с V4 Pro
Тут в самом DeepSeek вышла путаница, и её стоит развести. В анонсе 10 сентября компания написала, что с 14 сентября все запросы к deepseek-v4-pro будут перенаправляться на V4.1 Flash по её тарифу, то есть старшую модель выводят из обращения. Но в журнале изменений API формулировка позже сменилась на противоположную: по просьбам пользователей DeepSeek продолжает обслуживать V4 Pro и после 14 сентября, тарификация не меняется (журнал изменений).
На 22 сентября 2026 года V4 Pro жива, её тариф по-прежнему в прайсе. Так что утверждение «V4 Pro отключили» неверно, хотя оно и разошлось по новостям вслед за первой версией анонса. Подробный разбор того, какая из двух моделей кому нужна, — в отдельной статье V4.1 Flash против V4 Pro.
Как попробовать DeepSeek V4.1 Flash
DeepSeek V4.1 Flash добавлена в каталог моделей Veruna AI — сервиса, который даёт доступ сразу ко многим нейросетям в одном чате, без VPN и с оплатой в рублях. Модель открыта на подписке Plus и выше, оформить её можно на странице тарифов — страница сама доскроллит до нужного плана.
Как получить доступ из России, что при этом происходит с бесплатным чатом DeepSeek и почему запрос «дипсик 4.1 как пользоваться» на практике упирается не в VPN, разобрано в статье как пользоваться DeepSeek V4.1 в России.
Частые вопросы
Когда вышла DeepSeek V4.1 Flash? 10 сентября 2026 года. В тот же день в 04
UTC заработали новые тарифы API, а веса модели выложили на HuggingFace под лицензией MIT.Что такое дипсик 4.1?
Это новая модель DeepSeek: 552 млрд параметров в MoE, контекст 1 млн токенов, вход текстом и изображениями, выход только текстом. В API она называется deepseek-flash, без номера версии.
Чем DeepSeek V4.1 Flash отличается от V4 Pro? Она младше по позиционированию, но по собственным замерам DeepSeek обходит V4 Pro почти везде: 74,2% против 62,7% на DeepSWE v1.1, 54,8% против 43,2% на AutomationBench. При этом стоит вчетверо дешевле на входе и втрое с небольшим на выходе, а ещё умеет читать изображения, чего у V4 Pro нет.
Сколько стоит DeepSeek V4.1 Flash? $0,15 за миллион входных токенов и $0,60 за выходные в льготные часы; в пиковые — $0,30 и $1,20. Пик приходится на 01
–04 и 06–10 UTC по будням, всё остальное время действует льготный тариф.Правда ли, что V4.1 Flash лучше всех в коде? Нет. На DeepSWE v1.1 у неё 74,2% — это второй результат среди флагманов, которые мы разбирали, после Muse Spark 1.3 с 75,4%. К тому же сама цифра получена на лучшей из восьми проверенных обвязок: на других результат опускается до 65,5%.